Compare commits
8 Commits
| Author | SHA1 | Date | |
|---|---|---|---|
 truewhile |
c9c612df1b | ||
|
truewhile
|
e2cd32af53 | ||
|
truewhile
|
28485ed429 | ||
|
truewhile
|
34ccf14cda | ||
|
truewhile
|
44fde6c5a0 | ||
|
truewhile
|
94ef0116b1 | ||
|
truewhile
|
016c6687e9 | ||
|
truewhile
|
b5ce4646cf |
@@ -1,190 +0,0 @@
|
||||
# 【开源推荐】MeBox:把 NAS / 网盘 / 远程 Emby 统一家里的观影入口,Docker 一键部署
|
||||
|
||||
> 配图已托管在 GitHub 仓库(`raw.githubusercontent.com` 直链),发帖时可直接引用,或下载 `docs/tutorial-screenshots/` 后作为附件上传。
|
||||
|
||||
---
|
||||
|
||||
## 写在前面
|
||||
|
||||
给论坛的朋友们推荐一个我维护的开源项目 —— **MeBox**,一个面向 NAS 与家庭影音场景的**自托管私人媒体中心**(GPL-3.0,Go + React)。
|
||||
|
||||
GitHub:https://github.com/truewhile/MeBox
|
||||
|
||||
一句话介绍:**部署一个服务,同时获得媒体库后台、网盘 STRM 整理、Emby 客户端协议网关三件套。** 内置完整 Emby/Jellyfin 服务端协议实现——手机、电视、平板上的 Infuse、SenPlayer、Fileball、Emby/Jellyfin 官方客户端直接「添加 Emby 服务器」就能连,一套账号体系全搞定,Emby 老用户零学习成本。
|
||||
|
||||
项目 fork 自 MediaStationGo 并持续二开,围绕网盘播放、任务队列、远程挂载和权限体系做了大量增强。
|
||||
|
||||
---
|
||||
|
||||
## 它能解决什么问题?
|
||||
|
||||
家里看电影电视的痛点,MeBox 基本一把梭:
|
||||
|
||||
| 痛点 | MeBox 的解法 |
|
||||
| --- | --- |
|
||||
| 硬盘散落各处,海报墙乱七八糟 | 多根目录媒体库 + TMDb/Bangumi/Douban 自动刮削,海报墙、继续观看、多季剧集一应俱全 |
|
||||
| 网盘资源看一部下一部太麻烦 | OpenList / CloudDrive2 / 115 / WebDAV 接入,STRM 同步 + 直链/302 播放,不占本地空间 |
|
||||
| 已经有一台 Emby,出门还得开 App | **远程 Emby 挂载**:把远程 Emby 的媒体库直接挂进 MeBox 界面统一浏览 |
|
||||
| 家人乱动设置、小孩看不该看的 | 多用户 + 有效期 + 成人内容开关 + 播放配置 PIN,细粒度权限 |
|
||||
| 每个设备装一套专属 App 太折腾 | **完整兼容 Emby/Jellyfin 客户端**:Infuse、SenPlayer、Fileball、官方客户端按「添加 Emby 服务器」填地址 + MeBox 账号即可,海报墙、观看进度、多用户直接同步 |
|
||||
|
||||
---
|
||||
|
||||
## 特点一览
|
||||
|
||||
**1. 现代化 Web UI,海报墙开箱即用**
|
||||
|
||||
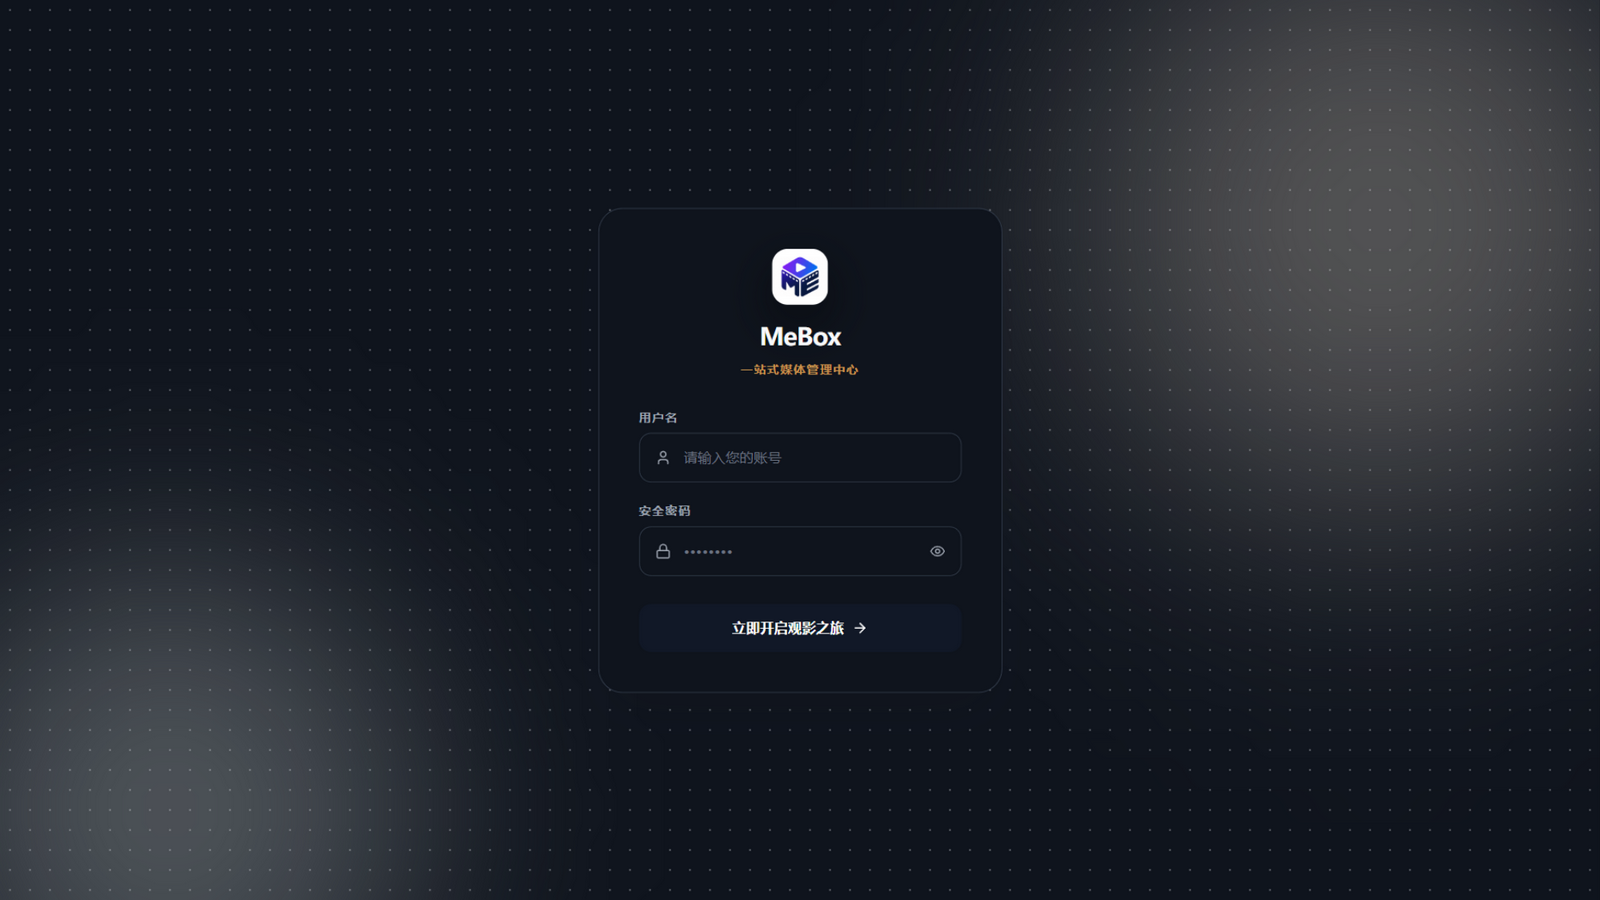
|
||||
|
||||
深色系登录页,默认账号 `admin / admin123`(首次登录请立即改密)。
|
||||
|
||||
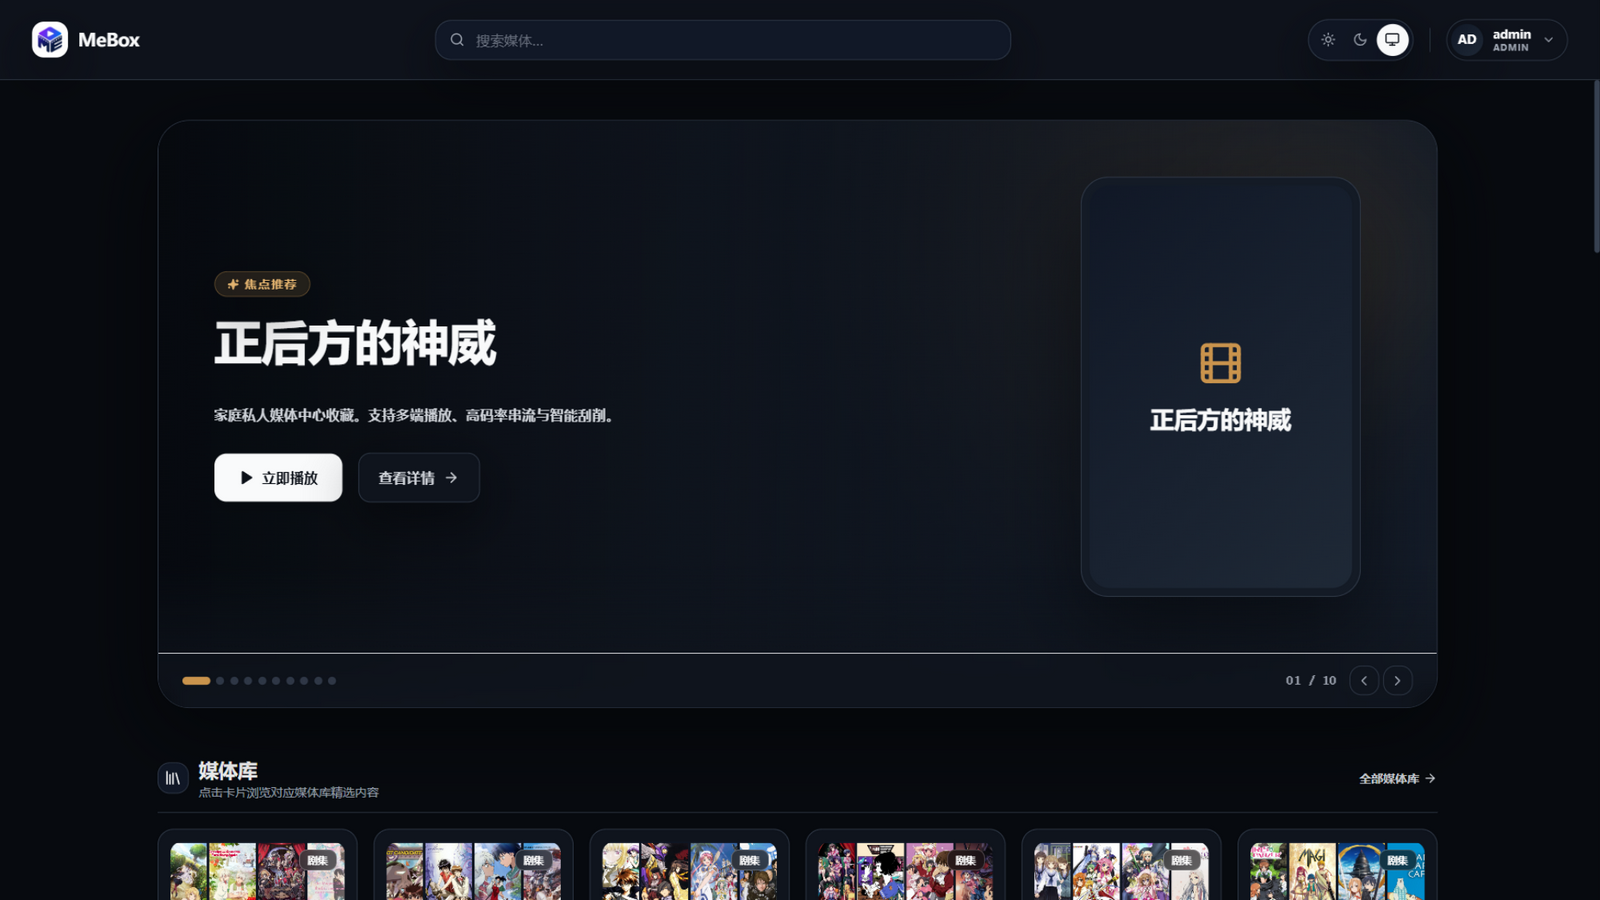
|
||||
|
||||
首页自带焦点推荐轮播 + 媒体库入口卡片,继续观看、最近添加直接呈现。
|
||||
|
||||
**2. 媒体库与刮削**
|
||||
|
||||
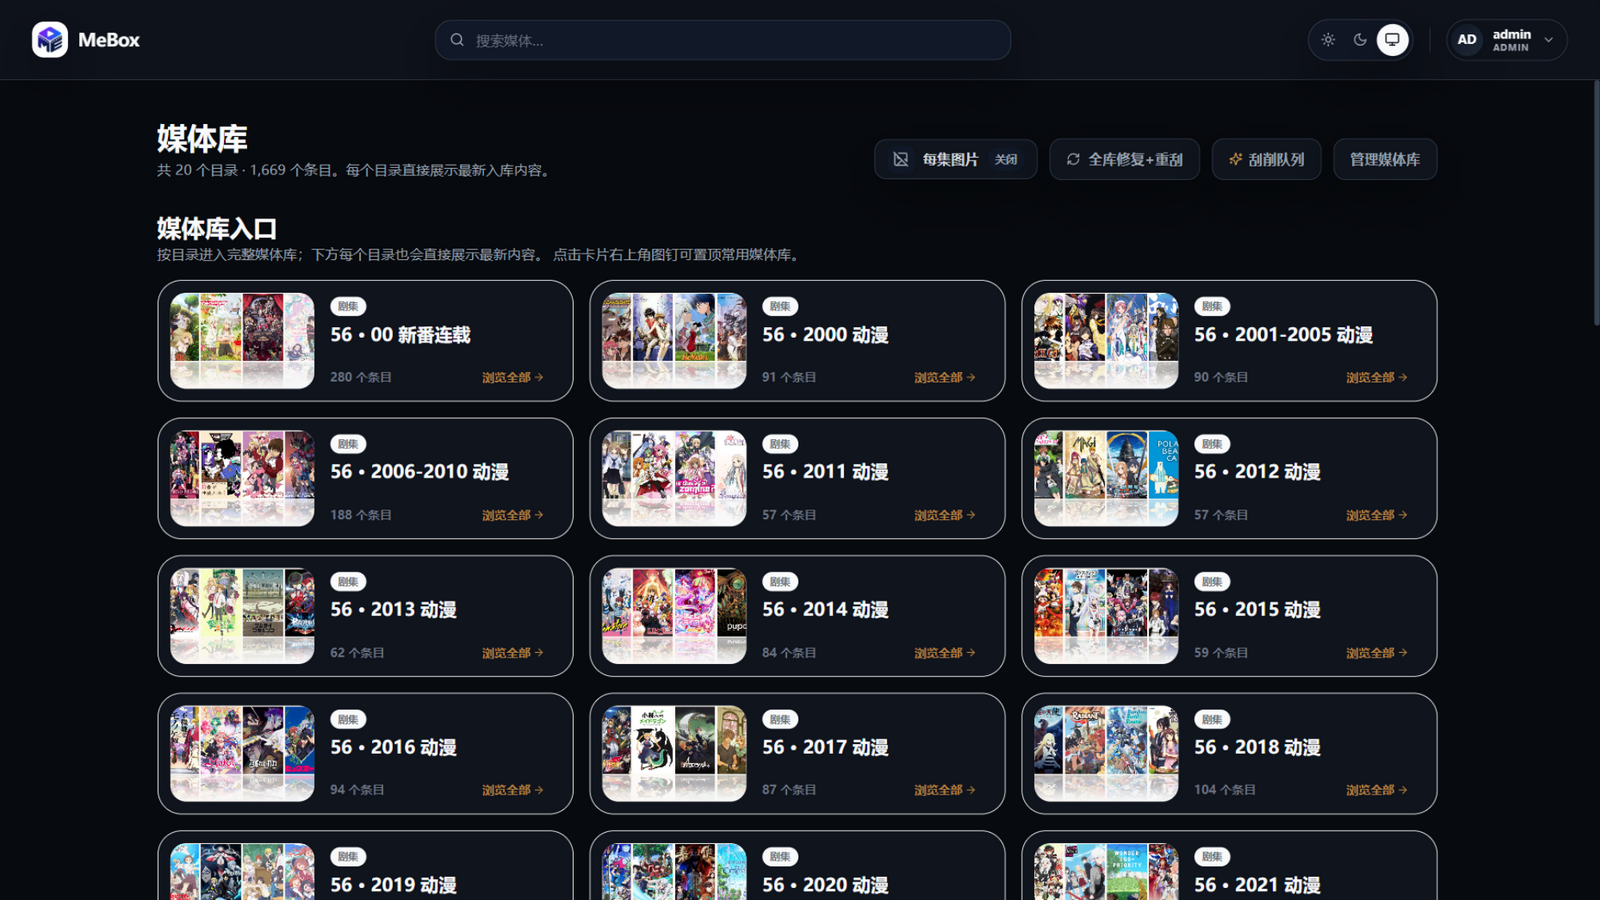
|
||||
|
||||
20 个媒体库、1600+ 条目一眼尽收:每库自带封面拼贴、条目数统计,支持「全库修复+重刮」「刮削队列」批量处理。
|
||||
|
||||
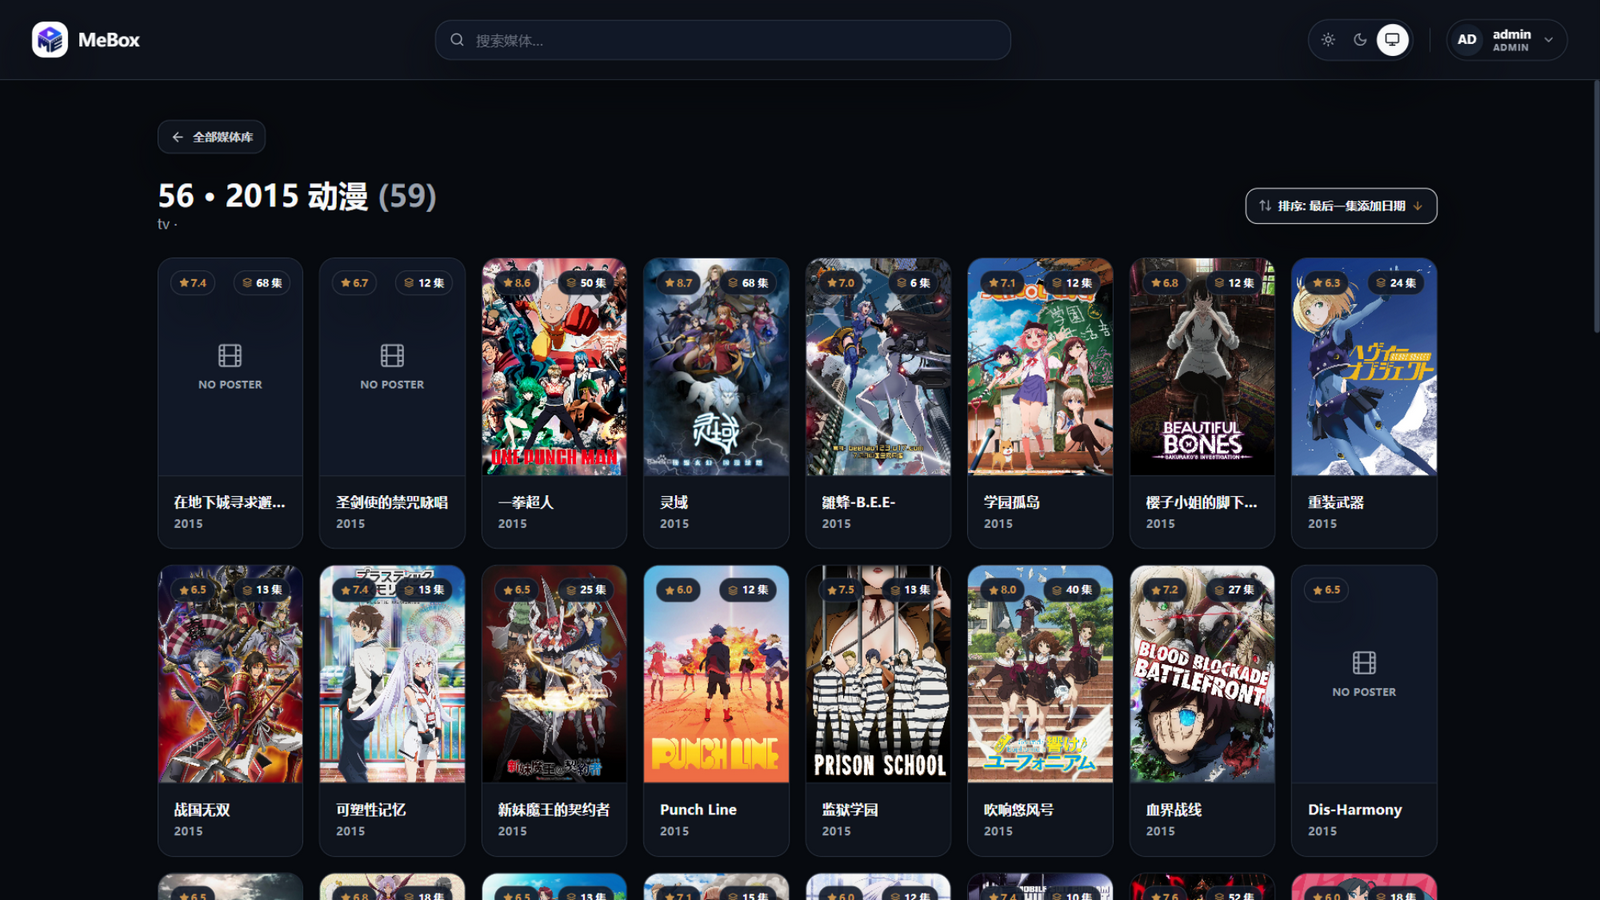
|
||||
|
||||
库内海报墙带评分、集数角标,支持按最后集添加日期排序,点开即看。
|
||||
|
||||
**3. 详情页与多季管理**
|
||||
|
||||
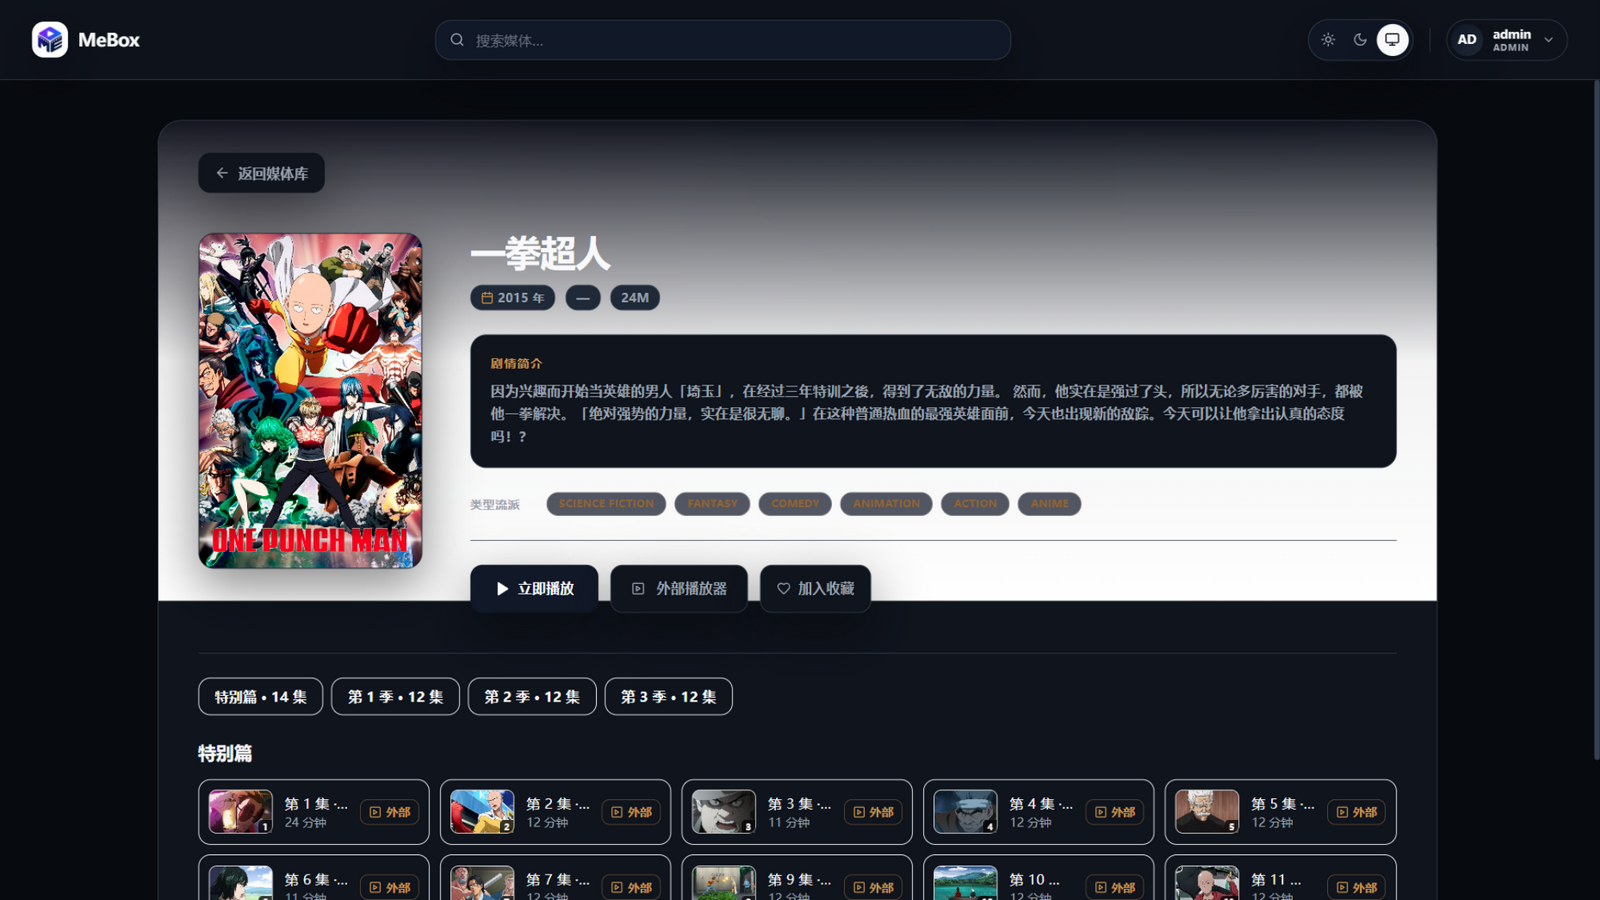
|
||||
|
||||
剧情简介、类型标签、多季分集(特别篇/第 1-N 季)、每集缩略图与时长;一键立即播放、调用外部播放器、加入收藏。
|
||||
|
||||
**4. Emby/Jellyfin 客户端无缝兼容**
|
||||
|
||||
这是我最想强调的一点:**MeBox 内置了完整的 Emby 服务端协议实现**。手机、电视、平板上的 Infuse、SenPlayer、Fileball,甚至 Emby/Jellyfin 官方客户端,都不需要任何插件或改造——按「添加 Emby 服务器」填入 `http://服务器IP:18080`,用 MeBox 账号登录,海报墙、观看进度、收藏、多用户权限全部无缝衔接。已经习惯 Emby 生态的朋友可以零成本迁移,家人只用电视端 App 也完全无感。
|
||||
|
||||
**5. 网页播放器 + 弹幕自动匹配**
|
||||
|
||||
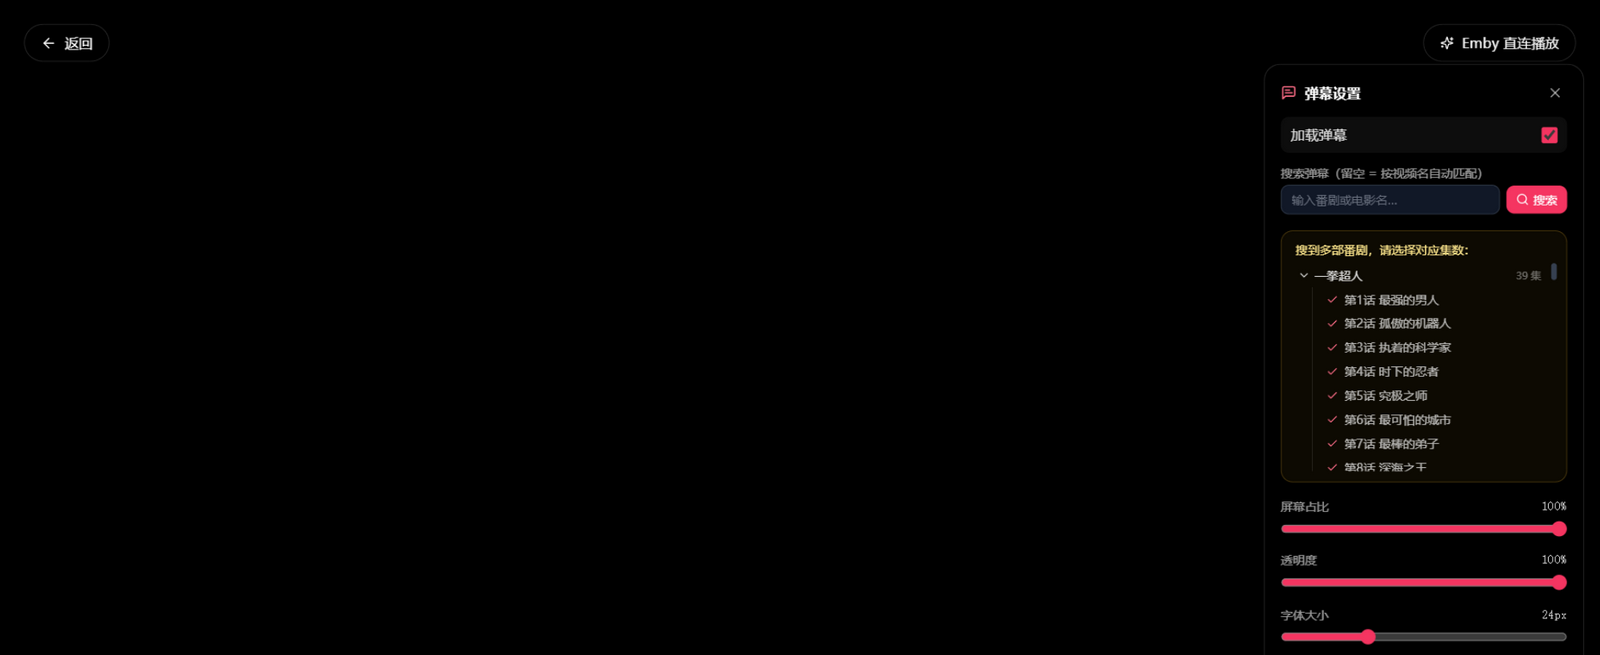
|
||||
|
||||
内置网页播放器支持 HLS 转码、字幕、播放配置档;**弹幕按剧名自动匹配全季分集**(截图中自动匹配到《一拳超人》39 集),屏幕占比/透明度/字号随意调,追新番体验直接拉满。
|
||||
|
||||
**6. 网盘 STRM:网盘当本地盘用**
|
||||
|
||||
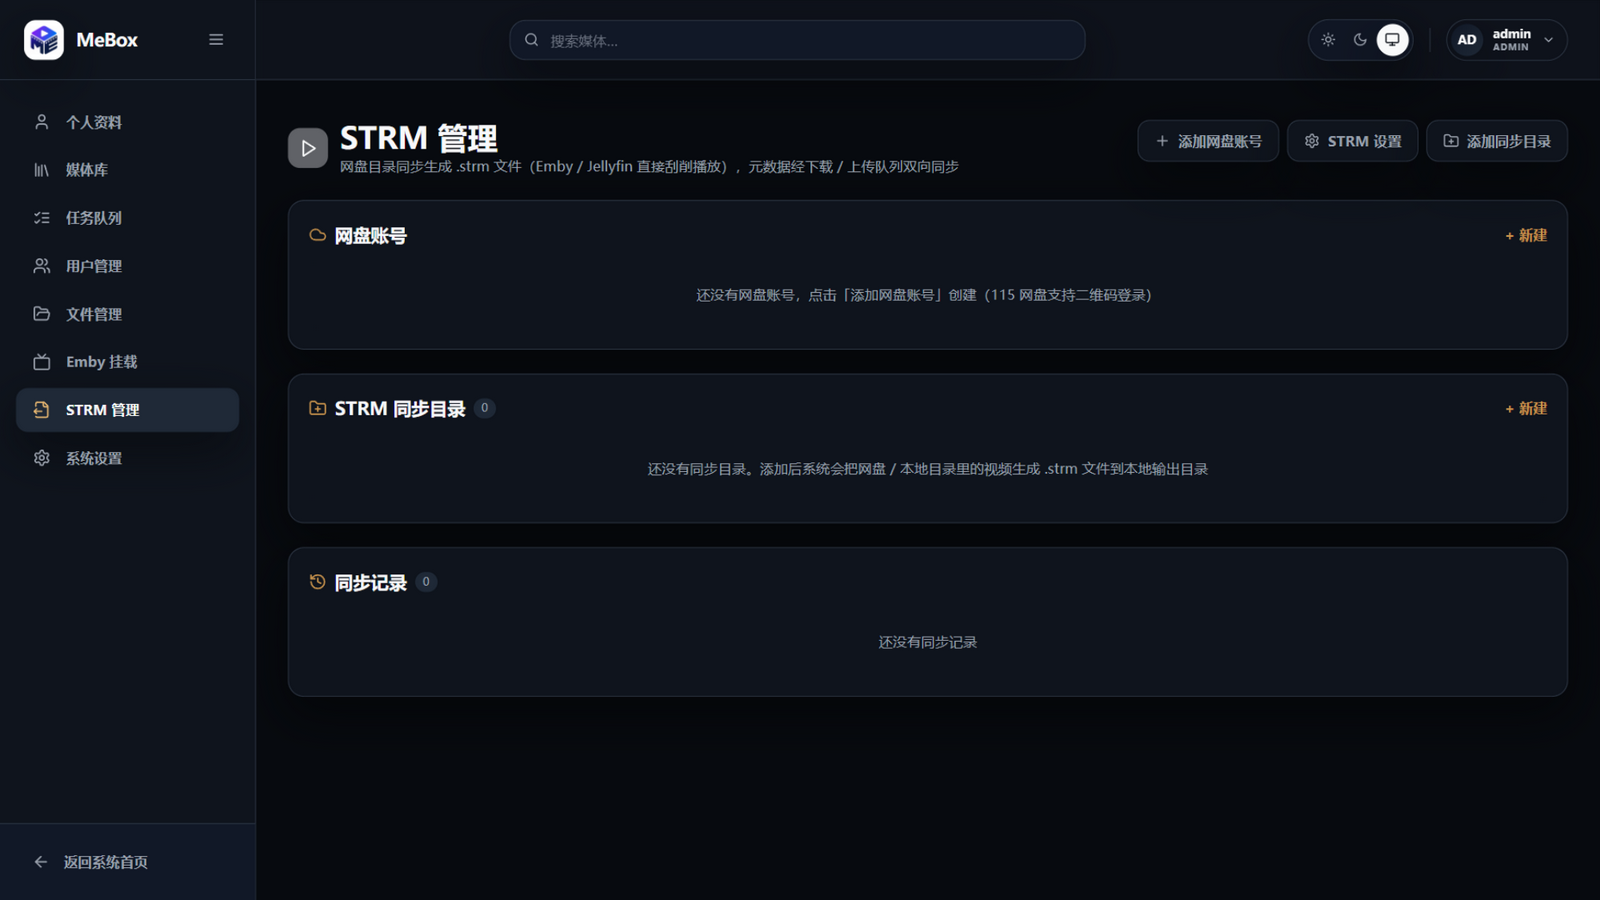
|
||||
|
||||
添加网盘账号(**115 支持二维码扫码登录**)→ 添加同步目录 → 系统把网盘/本地目录里的视频生成 `.strm` 文件,元数据经下载/上传队列双向同步,播放走直链/302 不落盘。
|
||||
|
||||
**7. 远程 Emby 挂载(特色功能)**
|
||||
|
||||
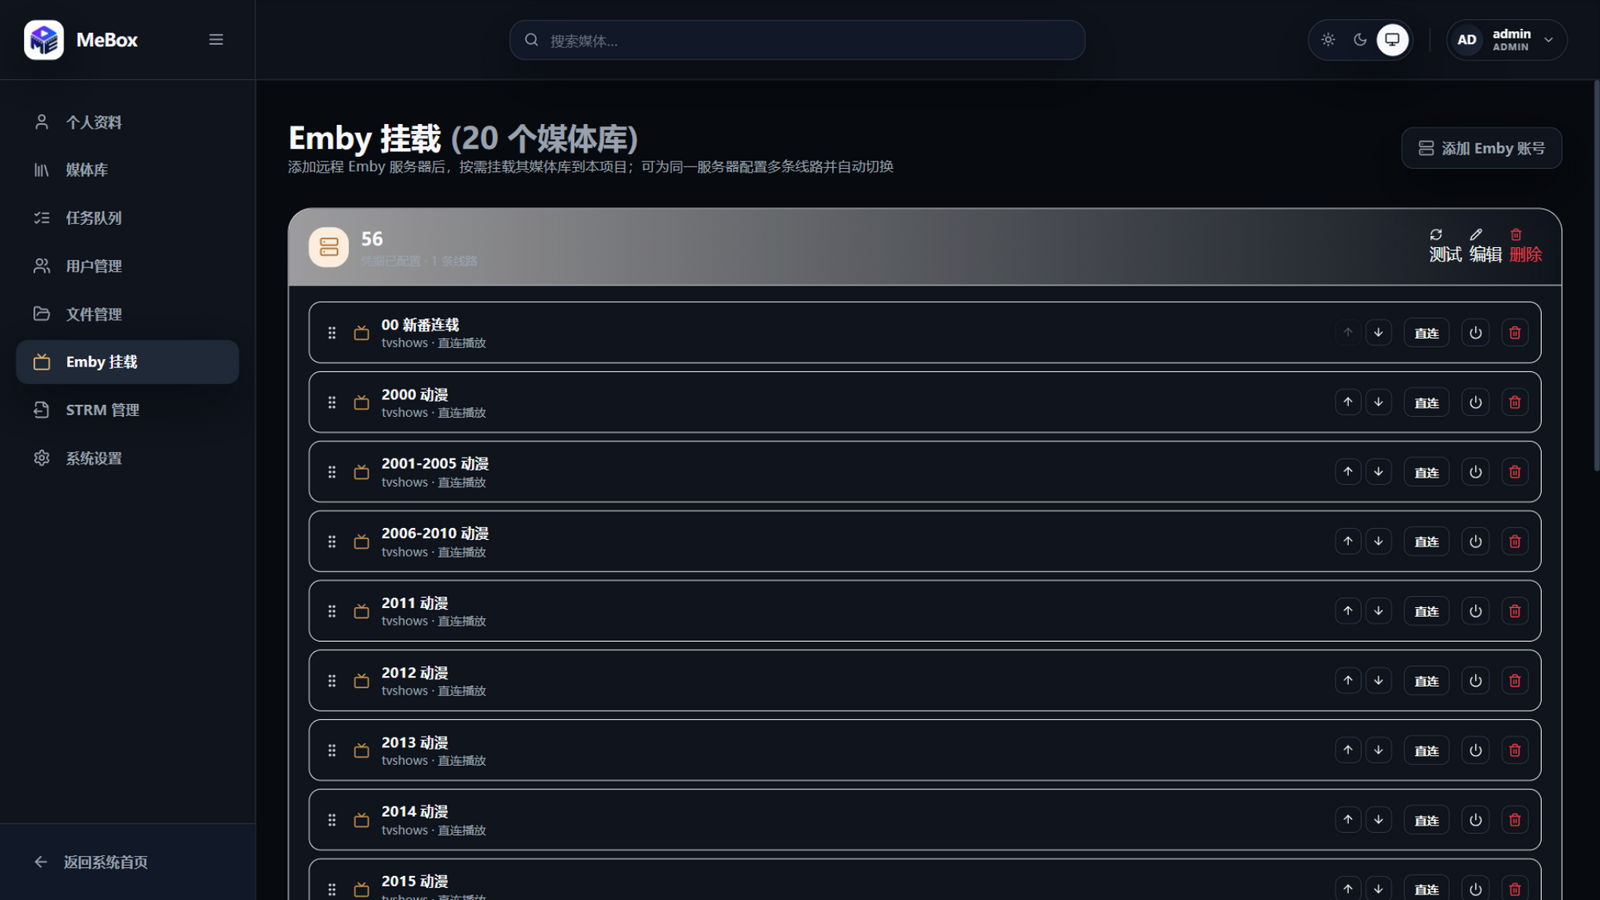
|
||||
|
||||
已有远程 Emby 服务器?填一次账号,按需勾选要挂载的媒体库(支持同服务器多线路自动切换、直连开关、排序),远程库直接出现在 MeBox 首页,不必再开 Emby 客户端。
|
||||
|
||||
**8. 任务队列统一管理**
|
||||
|
||||
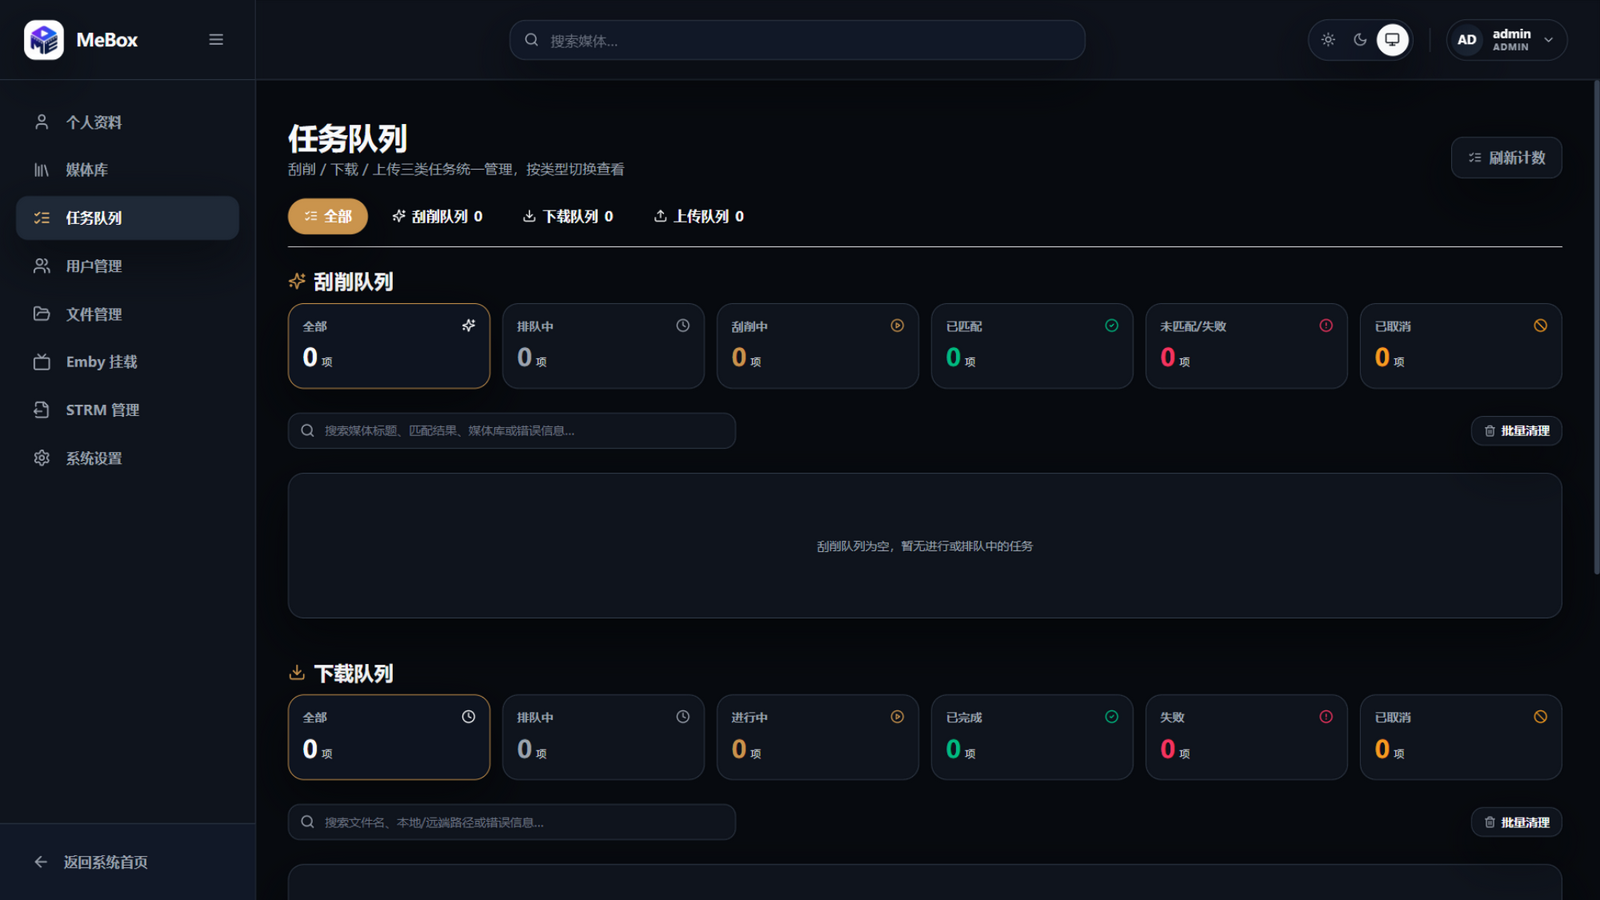
|
||||
|
||||
刮削 / 下载 / 上传三类任务统一看板,排队中、进行中、已匹配、失败分类计数,支持搜索与批量清理。
|
||||
|
||||
**9. 下载与自动整理**
|
||||
|
||||
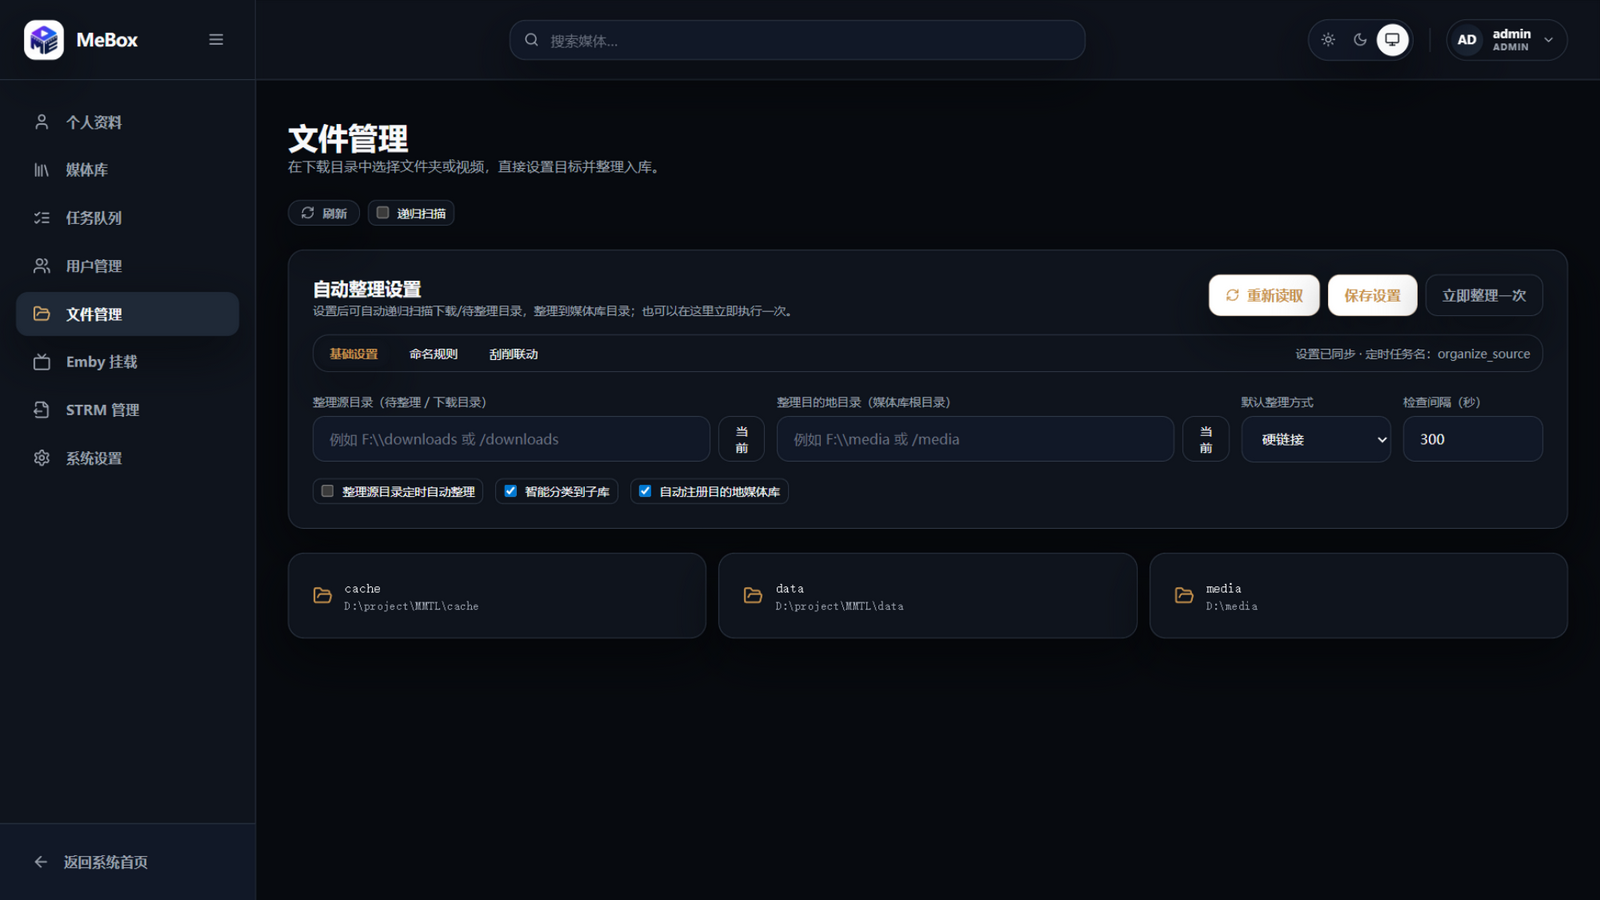
|
||||
|
||||
配合任意下载器(qBittorrent、Transmission 等下载到本地目录即可),MeBox 定时自动整理入媒体库:智能分类子库、自动注册目的地媒体库、复制/移动/硬链/软链多种整理方式,命名规则可配。
|
||||
|
||||
**10. 多用户与权限**
|
||||
|
||||
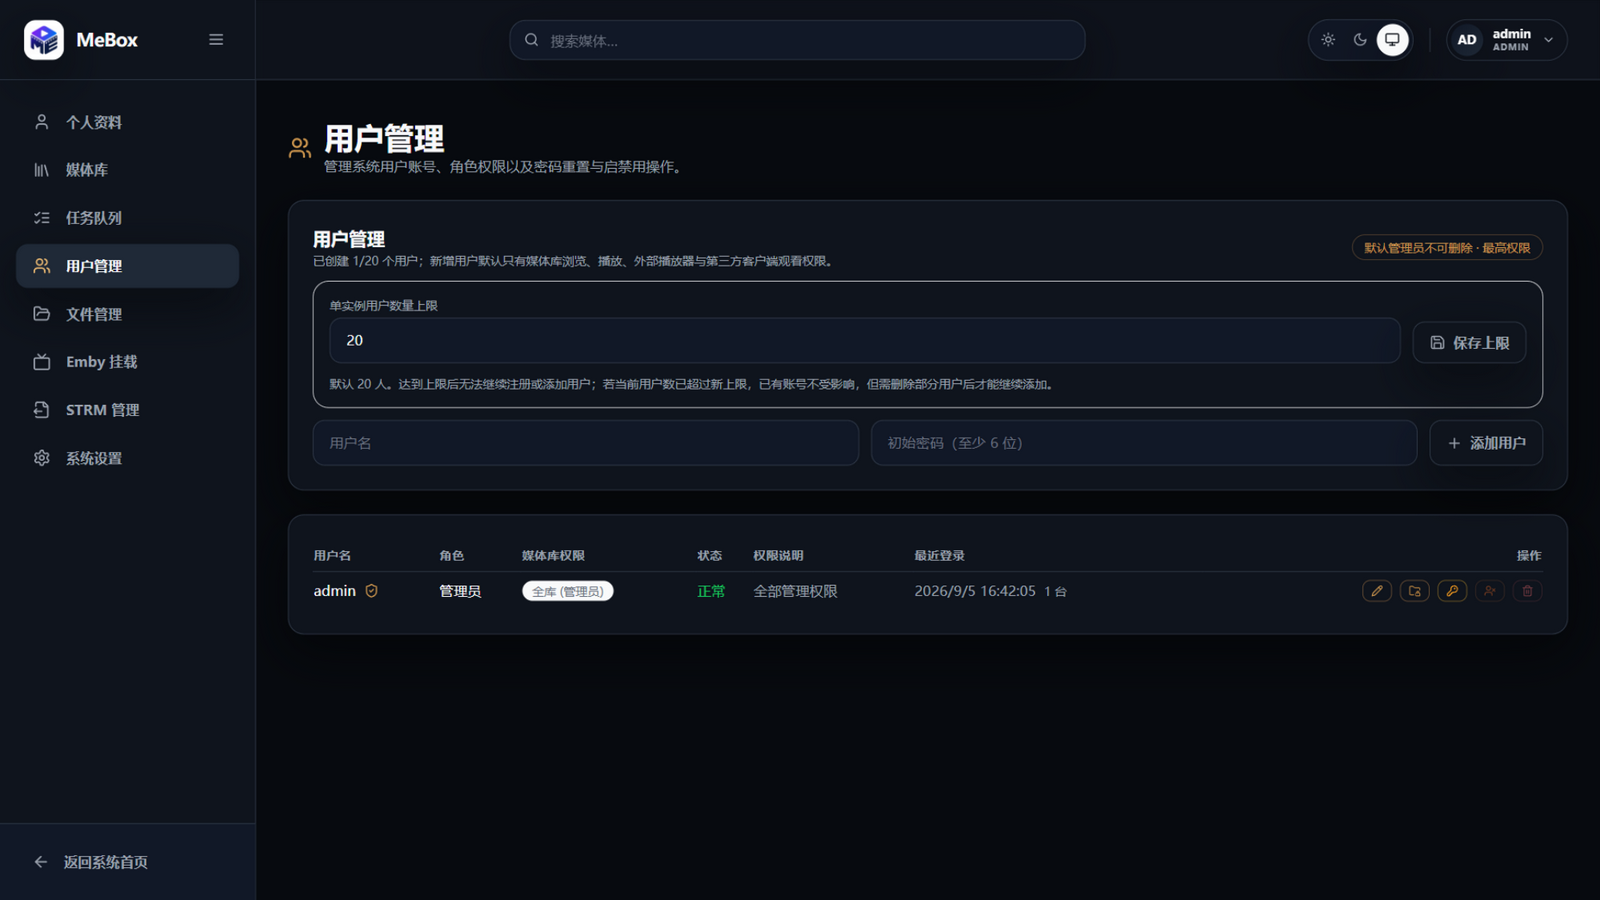
|
||||
|
||||
管理员/普通用户分级、单实例用户数上限、账号有效期、成人内容开关、播放配置 PIN——给家人开号放心给。
|
||||
|
||||
**11. 运维省心**
|
||||
|
||||
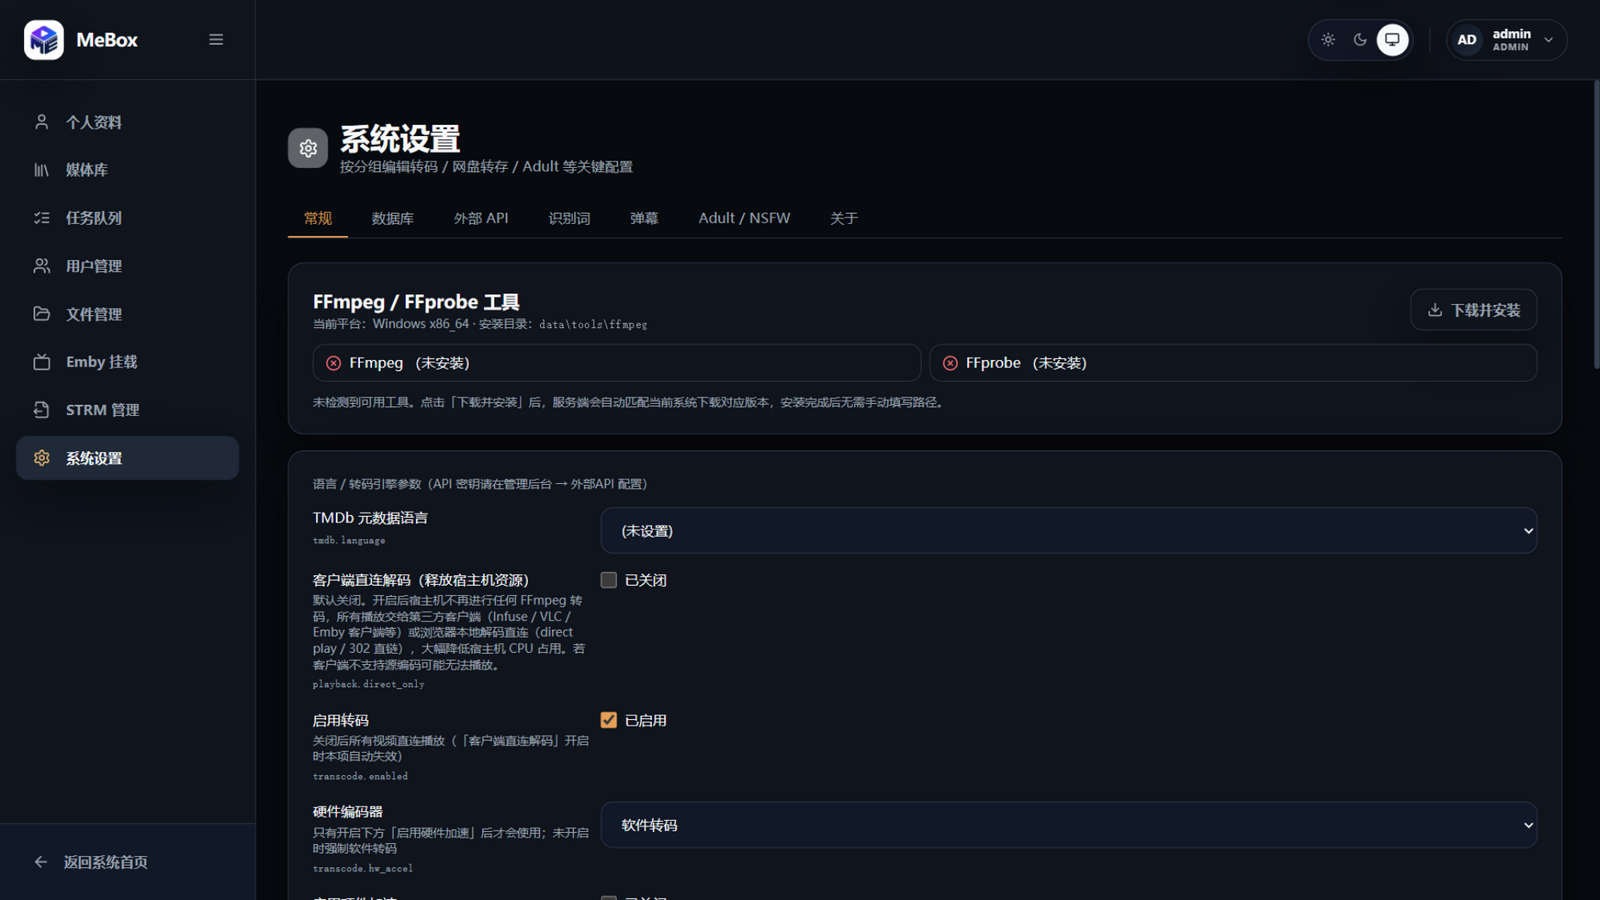
|
||||
|
||||
FFmpeg/FFprobe 一键下载安装、转码与硬件加速开关、TMDb 语言、识别词、弹幕、Adult/NSFW 开关全在设置页分组管理;另有 DLNA 投屏、存储统计、海报墙聚合视图:
|
||||
|
||||
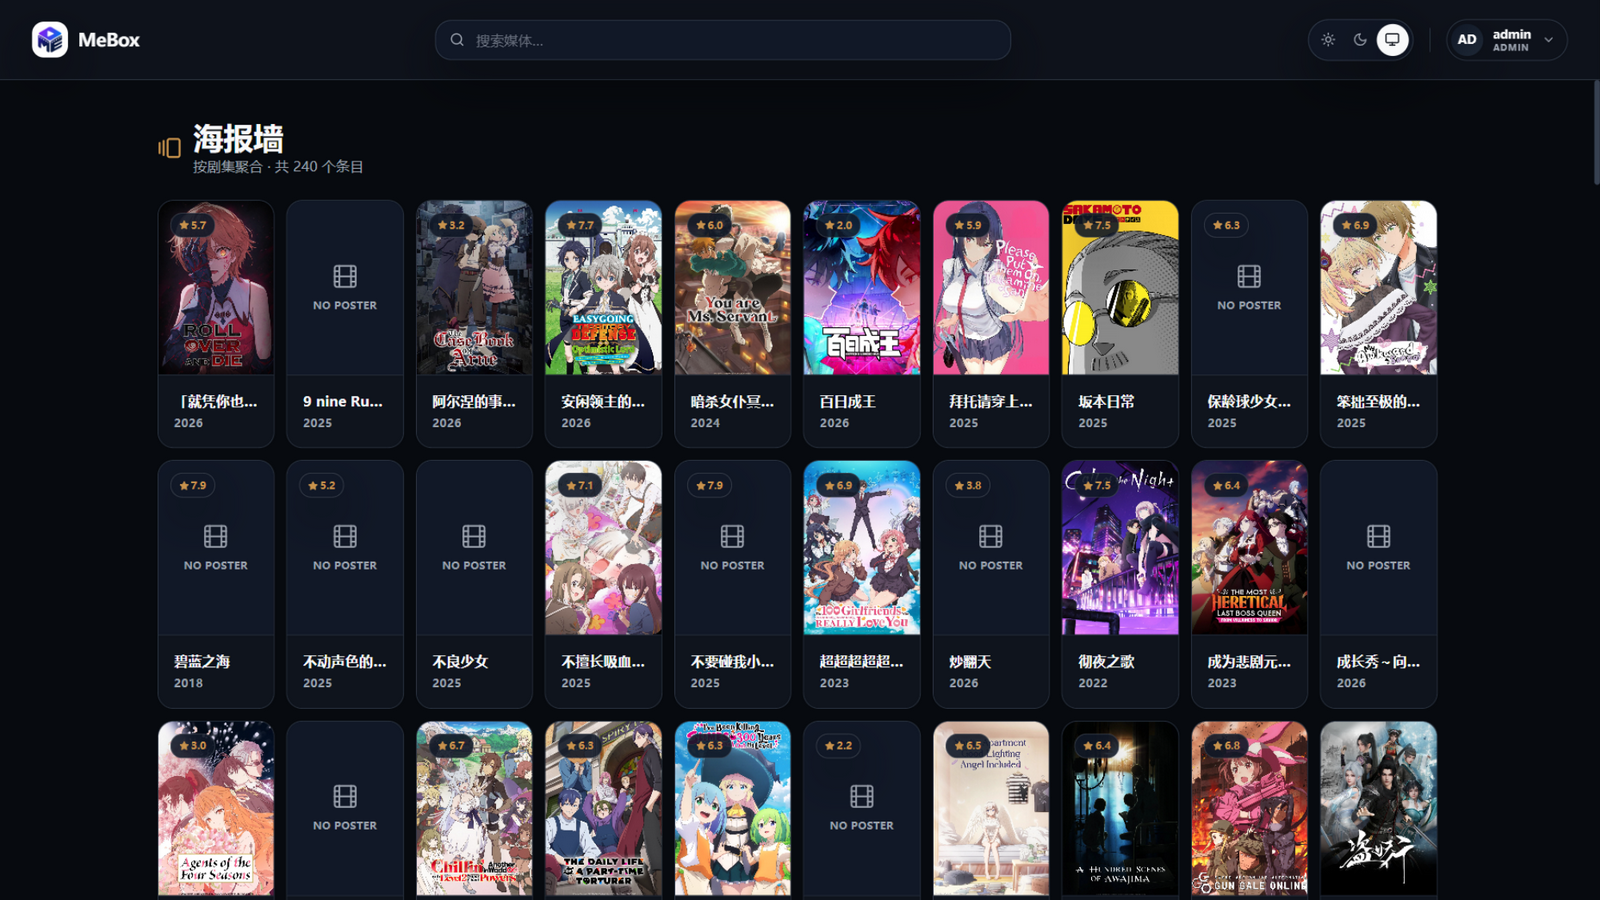
|
||||
|
||||
---
|
||||
|
||||
## 使用教程:从零到海报墙只要 5 步
|
||||
|
||||
### 第 1 步:Docker 一键部署
|
||||
|
||||
推荐 Docker Compose(仓库提供 4 份互相独立的完整模板,无需 `.env`):
|
||||
|
||||
```bash
|
||||
mkdir -p MeBox && cd MeBox
|
||||
|
||||
# 最省心:单镜像 + 内置 SQLite
|
||||
curl -fsSL https://raw.githubusercontent.com/truewhile/MeBox/main/docker-compose.simple.yml -o docker-compose.yml
|
||||
|
||||
# 多用户/大数据量可选 PostgreSQL 档、Redis 档、OpenSearch 档,见仓库 README「部署档位」
|
||||
|
||||
docker compose up -d
|
||||
```
|
||||
|
||||
浏览器访问 `http://服务器IP:18080`,镜像:`ghcr.io/truewhile/mebox:latest`(amd64 / arm64 都有,也提供 Windows/Linux/macOS 单文件可执行程序,不想装 Docker 直接下载跑)。
|
||||
|
||||
### 第 2 步:登录并修改密码
|
||||
|
||||
默认账号 `admin / admin123`,登录后右上角头像 → 个人资料修改密码。
|
||||
|
||||
### 第 3 步:创建媒体库 + 扫库
|
||||
|
||||
后台 → 媒体库 → 管理媒体库,添加本地路径(Docker 部署记得填**容器内**路径,如 `/media/电影`,`volumes` 左侧挂宿主机真实目录)→ 执行扫库。
|
||||
|
||||
### 第 4 步:配置元数据刮削
|
||||
|
||||
系统设置 → 外部 API,填入 TMDb / Bangumi / Douban 等 API Key;媒体库页可对单个库「全库修复+重刮」,刮削进度在任务队列实时可见。
|
||||
|
||||
### 第 5 步(可选但强烈推荐):
|
||||
|
||||
- **网盘用户**:STRM 管理 → 添加网盘账号(115 可扫码)→ 添加同步目录 → 生成 STRM 后直链播放;
|
||||
- **已有 Emby**:Emby 挂载 → 添加 Emby 账号 → 勾选要挂载的媒体库;
|
||||
- **第三方播放器(Emby 客户端全兼容)**:Infuse / SenPlayer / Fileball / Emby、Jellyfin 官方客户端,按「添加 Emby 服务器」填 `http://服务器IP:18080`,用 MeBox 账号登录即可,原有使用习惯完全不变;
|
||||
- **下载党**:qBittorrent 等任意下载器把视频下到下载目录,在文件管理里把它设为整理源,下完自动分类入库。
|
||||
|
||||
### 路径映射小抄(Docker 最常见坑)
|
||||
|
||||
```yaml
|
||||
volumes:
|
||||
- /vol1/1000/Media:/media # 左:宿主机真实路径;右:容器内路径(网页里填这个)
|
||||
environment:
|
||||
MEBOX_MEDIA_DIR: /vol1/1000/Media
|
||||
MEBOX_MEDIA_CONTAINER_DIR: /media
|
||||
```
|
||||
|
||||
硬链接要求同一文件系统/子卷,跨盘请改复制或软链。
|
||||
|
||||
---
|
||||
|
||||
## 部署档位怎么选?
|
||||
|
||||
| 档位 | 文件 | 组件 | 适合 |
|
||||
| --- | --- | --- | --- |
|
||||
| 极简 | `docker-compose.simple.yml` | 单镜像 + SQLite | 个人使用、低配设备 |
|
||||
| 标准 | `docker-compose.yml` | + PostgreSQL | 多用户家庭共享 |
|
||||
| 增强 | `docker-compose.standard.yml` | + Redis | 大媒体库高频访问 |
|
||||
| 搜索 | `docker-compose.search.yml` | + OpenSearch | 超大库全文搜索 |
|
||||
|
||||
---
|
||||
|
||||
## 技术栈与致谢
|
||||
|
||||
- 后端:Go · Gin · GORM · SQLite/PostgreSQL · 可选 Redis / OpenSearch
|
||||
- 前端:React 18 · Vite · TypeScript · Tailwind CSS · Zustand
|
||||
- 部署:Docker Compose 多档模板,amd64/arm64 镜像 + 单文件可执行
|
||||
|
||||
感谢上游 [MediaStationGo](https://github.com/ShukeBta/MediaStationGo) 的奠基,网盘同步/STRM/整理部分参考了 [qmediasync](https://github.com/qicfan/qmediasync) 的思路。
|
||||
|
||||
---
|
||||
|
||||
## 链接
|
||||
|
||||
- GitHub:https://github.com/truewhile/MeBox
|
||||
- Issue / PR:欢迎提 bug(附部署方式+复现步骤+日志)与功能建议
|
||||
- License:GPL-3.0
|
||||
|
||||
觉得有用的话求个 Star ⭐,也欢迎论坛里的朋友反馈使用体验,我长期维护。
|
||||
@@ -1,743 +0,0 @@
|
||||
# 阅读模块(Reading Module)设计与实施方案
|
||||
|
||||
> 状态:设计稿,待评审
|
||||
> 目标版本:v0.2.0(分期落地,见第 9 节)
|
||||
> 关联现有子系统:媒体库 / 网盘存储 / 权限体系 / 任务队列
|
||||
|
||||
---
|
||||
|
||||
## 1. 目标与范围
|
||||
|
||||
### 1.1 已确认的产品决策
|
||||
|
||||
| 维度 | 决策 |
|
||||
| --- | --- |
|
||||
| 内容类型 | **电子书 + 漫画统一书架**(EPUB / TXT / PDF / MOBI 与 CBZ / CBR / 图片文件夹) |
|
||||
| 书源 | **独立书库**(不复用影视媒体库)+ **网盘直链阅读** |
|
||||
| 首版范围 | **完整版**:多用户书库权限 + 阅读统计 |
|
||||
| 阅读形态 | **滚动流式与分页翻页双模式**,用户可切换并持久化偏好 |
|
||||
|
||||
### 1.2 明确的非目标
|
||||
|
||||
- **不接入 Emby/Jellyfin 协议。** Emby 的 `Items` / `Views` / `PlaybackInfo` 语义围绕音视频构建,没有书籍章节与阅读进度的对应概念。强行映射会污染 `internal/service/emby_*.go` 与 `internal/handler/emby_*.go` 的既有兼容层,收益极低。阅读能力只通过 MeBox 自己的 Web UI 提供。
|
||||
- **不复用 `model.Library` / `LibraryRoot`。** `Library.Type` 的取值域是 `movie/tv/anime/music`,且被海报墙轮播(`CarouselEnabled`)、自动整理管线、Emby 视图、首页预览等链路消费。把书库塞进去会导致这些链路需要到处加 `type != "book"` 判断。
|
||||
- 首版不做:听书 TTS、在线书源(笔趣阁类)、社交分享、跨设备同步批注冲突合并。
|
||||
|
||||
---
|
||||
|
||||
## 2. 总体架构
|
||||
|
||||
### 2.1 分层落位
|
||||
|
||||
完全沿用现有分层,不引入新模式:
|
||||
|
||||
```
|
||||
web/src/pages/Books*.tsx ← 页面
|
||||
web/src/components/Book*.tsx ← 阅读器与书架组件
|
||||
web/src/api/books.ts ← axios 封装(仿 web/src/api/library.ts)
|
||||
↓ /api/books/*
|
||||
internal/handler/books*.go ← 反序列化 + 权限校验 + 响应
|
||||
internal/service/book_*.go ← 业务策略(扫描、解析、进度、统计)
|
||||
internal/repository/book_*.go ← 纯持久化
|
||||
internal/model/book.go ← GORM 模型,注册进 model.AllModels()
|
||||
```
|
||||
|
||||
新增路由注册走 `internal/handler/routes_authenticated_features.go` 的既有范式,新增一个 `registerAuthedBookRoutes(authed, svc)`,在 `registerAuthenticatedRoutes` 链上挂载。`service.Container` 与 `repository.Container` 各追加一个字段。
|
||||
|
||||
### 2.2 与现有能力的复用点
|
||||
|
||||
| 现有部件 | 复用方式 |
|
||||
| --- | --- |
|
||||
| `service.StreamService.ServeFile`(`internal/service/stream_file.go`) | 已用 `http.ServeContent` 处理 HEAD / Range / If-Modified-Since,**PDF 与原始文件流直接照搬这条路径** |
|
||||
| `cloud.Provider.Resolve(ctx, fileRef) (*DirectLink, error)`(`internal/service/cloud/cloud.go`) | 网盘书源的直链解析入口,`DirectLink.Proxy` 决定 302 还是反代 |
|
||||
| `model.StorageConfig`(`internal/model/storage_assistant.go`) | 直接复用为网盘书源的账号凭据载体,**不新建凭据表** |
|
||||
| `service.ImageProxy`(`internal/service/image_proxy*.go`) | 漫画页与封面的磁盘缓存 + 远程拉取 + 缩放,复用其缓存目录与命名思路 |
|
||||
| `service.PruneImageCache` / `PruneImageCachePools`(`internal/service/cache_cleanup.go`) | 现成的「按池做 LRU 淘汰 + 按保留时长淘汰」助手,书籍缓存淘汰直接复用它 |
|
||||
| `service/scheduler_local_jobs.go` | 本地定时任务的挂载点,书籍缓存清理与每日统计汇总都注册在这里 |
|
||||
| `config.CacheConfig`(`internal/config/types.go`) | 已有 `CacheDir` / `ImagesMaxSizeMB` / `ImagesOriginalsMaxSizeMB` / `ImagesOriginalsTTLHours` / `MemoryMaxSizeMB`,书籍缓存容量配置直接挂进去 |
|
||||
| `service.FileManager`(`internal/service/filemanager.go`) | 本地书源目录浏览,前端复用 `LocalDirBrowserDialog.tsx` |
|
||||
| `service.Scheduler` | 书库定时扫描(默认关闭,管理员可开) |
|
||||
| `model.UserPermission` | 新增阅读权限位,见第 7 节 |
|
||||
| `helper.Go` / `Container.stopCtx` | 后台扫描任务的生命周期管理 |
|
||||
|
||||
---
|
||||
|
||||
## 3. 数据模型
|
||||
|
||||
新增文件 `internal/model/book.go`,并在 `internal/model/model.go` 的 `AllModels()` 中追加。所有表继承 `model.Base`(UUID 主键 + 时间戳 + 软删除)。
|
||||
|
||||
**表名约定**:`internal/model` 全包**没有任何 `TableName()` 覆盖**,一律使用 GORM 默认复数化(例如 `PlaybackHistory` → `playback_histories`,可从 `internal/database/schema_migration.go` 的裸 SQL 印证)。新表沿用该约定,不引入例外。因此模型命名要保证复数化结果干净:
|
||||
|
||||
| 模型 | 表名 |
|
||||
| --- | --- |
|
||||
| `Book` | `books` |
|
||||
| `BookLibrary` | `book_libraries` |
|
||||
| `BookSource` | `book_sources` |
|
||||
| `BookChapter` | `book_chapters` |
|
||||
| `BookProgress` | `book_progresses` |
|
||||
| `BookAnnotation` | `book_annotations` |
|
||||
| `BookFavorite` | `book_favorites` |
|
||||
| `BookReadingSession` | `book_reading_sessions` |
|
||||
| `BookDailyStat` | `book_daily_stats` |
|
||||
|
||||
(刻意用 `BookDailyStat` 而不是 `BookStatDaily`——后者复数化会得到 `book_stat_dailies`。)
|
||||
|
||||
### 3.1 书库与书源
|
||||
|
||||
```go
|
||||
// BookLibrary 是独立于影视媒体库的书库。
|
||||
type BookLibrary struct {
|
||||
Base
|
||||
Name string `gorm:"size:128;not null" json:"name"`
|
||||
Kind string `gorm:"size:16;not null;default:mixed" json:"kind"` // ebook / comic / mixed
|
||||
CoverURL string `gorm:"size:1024" json:"cover_url,omitempty"`
|
||||
Enabled bool `gorm:"default:true" json:"enabled"`
|
||||
SortOrder int `gorm:"index;default:0" json:"sort_order"`
|
||||
LastScanAt *time.Time `json:"last_scan_at,omitempty"`
|
||||
ScanStatus string `gorm:"size:16;default:idle" json:"scan_status"` // idle / scanning / error
|
||||
ScanMessage string `gorm:"size:512" json:"scan_message,omitempty"`
|
||||
}
|
||||
|
||||
// BookSource 是书库下的一条挂载来源:本地目录或网盘路径。
|
||||
type BookSource struct {
|
||||
Base
|
||||
LibraryID string `gorm:"index;size:36;not null" json:"library_id"`
|
||||
Name string `gorm:"size:128" json:"name,omitempty"`
|
||||
StorageKind string `gorm:"size:16;not null;default:local" json:"storage_kind"` // local / cloud
|
||||
Path string `gorm:"size:1024;not null" json:"path"` // 本地绝对路径 / 网盘内路径
|
||||
StorageConfigID string `gorm:"index;size:36" json:"storage_config_id,omitempty"` // 复用 model.StorageConfig
|
||||
Depth int `gorm:"default:3" json:"depth"` // 扫描递归深度上限
|
||||
Enabled bool `gorm:"default:true" json:"enabled"`
|
||||
SortOrder int `gorm:"default:0" json:"sort_order"`
|
||||
}
|
||||
```
|
||||
|
||||
`StorageKind = cloud` 时,`StorageConfigID` 指向一条 `StorageConfig`(`Type` ∈ `cloud115 / clouddrive2 / openlist / emby_remote`)。凭据解密沿用 `service.CryptoService`。
|
||||
|
||||
### 3.2 书籍与章节
|
||||
|
||||
```go
|
||||
type Book struct {
|
||||
Base
|
||||
LibraryID string `gorm:"index;size:36;not null" json:"library_id"`
|
||||
SourceID string `gorm:"uniqueIndex:uniq_book_source_path,priority:1;index;size:36;not null" json:"source_id"`
|
||||
// SourcePath 在本地源是绝对路径,在网盘源是「网盘内路径」,两者都用
|
||||
// (source_id, source_path) 做唯一键,天然隔离两个 ID 空间。
|
||||
SourcePath string `gorm:"uniqueIndex:uniq_book_source_path,priority:2;size:1024;not null" json:"source_path"`
|
||||
SourceRef string `gorm:"size:256" json:"source_ref,omitempty"` // 网盘 file id / pickcode
|
||||
Title string `gorm:"size:512;not null" json:"title"`
|
||||
Author string `gorm:"size:256;index" json:"author,omitempty"`
|
||||
SeriesName string `gorm:"size:256;index" json:"series_name,omitempty"`
|
||||
Volume int `json:"volume"`
|
||||
Format string `gorm:"size:16;not null" json:"format"` // epub/txt/pdf/mobi/cbz/cbr/folder
|
||||
MediaKind string `gorm:"size:16;not null;default:ebook" json:"media_kind"` // ebook / comic
|
||||
SizeBytes int64 `json:"size_bytes"`
|
||||
FileHash string `gorm:"index;size:64" json:"file_hash,omitempty"` // 大小+首尾采样,去重
|
||||
CoverURL string `gorm:"size:1024" json:"cover_url,omitempty"`
|
||||
Description string `gorm:"type:text" json:"description,omitempty"`
|
||||
Language string `gorm:"size:32" json:"language,omitempty"`
|
||||
Tags string `gorm:"type:text" json:"tags,omitempty"` // 逗号分隔
|
||||
ChapterCount int `json:"chapter_count"`
|
||||
WordCount int64 `json:"word_count"`
|
||||
PageCount int `json:"page_count"` // 漫画总页数 / PDF 页数
|
||||
ParseStatus string `gorm:"size:16;default:pending" json:"parse_status"` // pending/ok/failed
|
||||
ParseMessage string `gorm:"size:512" json:"parse_message,omitempty"`
|
||||
NSFW bool `gorm:"default:false" json:"nsfw"`
|
||||
AddedAt time.Time `json:"added_at"`
|
||||
}
|
||||
```
|
||||
|
||||
**唯一键说明**:`SourcePath` 上的 `uniqueIndex` 需与 `SourceID` 组成复合键(`uniq_book_source_path`,priority 1 = `source_id`)。同一本书被两个书源包含时允许重复入库,这是符合预期的(用户可能故意如此)。
|
||||
|
||||
```go
|
||||
// BookChapter 只存索引,不存正文(见 3.4 的取舍)。
|
||||
type BookChapter struct {
|
||||
Base
|
||||
BookID string `gorm:"index:idx_book_chapter,priority:1;size:36;not null" json:"book_id"`
|
||||
Index int `gorm:"index:idx_book_chapter,priority:2" json:"index"`
|
||||
Title string `gorm:"size:512" json:"title"`
|
||||
Level int `gorm:"default:1" json:"level"` // 目录嵌套层级,1 = 顶级
|
||||
// 电子书定位:二选一
|
||||
Href string `gorm:"size:1024" json:"href,omitempty"` // EPUB zip 内条目路径
|
||||
StartOffset int64 `json:"start_offset"` // TXT 字节区间
|
||||
EndOffset int64 `json:"end_offset"`
|
||||
// 漫画/PDF 定位
|
||||
PageStart int `json:"page_start"`
|
||||
PageEnd int `json:"page_end"`
|
||||
CharCount int `json:"char_count"`
|
||||
}
|
||||
```
|
||||
|
||||
### 3.3 进度、批注、收藏、统计
|
||||
|
||||
```go
|
||||
// BookProgress 每个用户每本书一行(复合唯一键,仿 model.PlaybackHistory 的 uniq_user_history 模式)。
|
||||
type BookProgress struct {
|
||||
Base
|
||||
UserID string `gorm:"uniqueIndex:uniq_user_book,priority:1;size:36;not null" json:"user_id"`
|
||||
BookID string `gorm:"uniqueIndex:uniq_user_book,priority:2;size:36;not null" json:"book_id"`
|
||||
ChapterIndex int `gorm:"default:0" json:"chapter_index"`
|
||||
ChapterTitle string `gorm:"size:512" json:"chapter_title,omitempty"`
|
||||
CharOffset int `json:"char_offset"` // 章内字符偏移(电子书)
|
||||
PageIndex int `json:"page_index"` // 页码(漫画 / PDF)
|
||||
Percent float64 `json:"percent"` // 全书百分比,书架进度条展示用
|
||||
ScrollRatio float64 `json:"scroll_ratio"` // 章内滚动比例,跨端还原更精确
|
||||
ReaderMode string `gorm:"size:16;default:scroll" json:"reader_mode"` // scroll / paged
|
||||
Finished bool `gorm:"default:false" json:"finished"`
|
||||
TotalSeconds int64 `json:"total_seconds"`
|
||||
LastReadAt time.Time `gorm:"index" json:"last_read_at"`
|
||||
}
|
||||
|
||||
type BookAnnotation struct {
|
||||
Base
|
||||
UserID string `gorm:"index:idx_book_anno,priority:1;size:36;not null" json:"user_id"`
|
||||
BookID string `gorm:"index:idx_book_anno,priority:2;size:36;not null" json:"book_id"`
|
||||
ChapterIndex int `json:"chapter_index"`
|
||||
Type string `gorm:"size:16;not null" json:"type"` // bookmark / highlight / note
|
||||
StartOffset int `json:"start_offset"`
|
||||
EndOffset int `json:"end_offset"`
|
||||
SelectedText string `gorm:"size:2048" json:"selected_text,omitempty"`
|
||||
Note string `gorm:"type:text" json:"note,omitempty"`
|
||||
Color string `gorm:"size:16" json:"color,omitempty"`
|
||||
}
|
||||
|
||||
type BookFavorite struct {
|
||||
Base
|
||||
UserID string `gorm:"uniqueIndex:uniq_user_book_fav,priority:1;size:36;not null" json:"user_id"`
|
||||
BookID string `gorm:"uniqueIndex:uniq_user_book_fav,priority:2;size:36;not null" json:"book_id"`
|
||||
}
|
||||
|
||||
// BookReadingSession 由前端心跳驱动,服务端按小时聚合,避免行数爆炸。
|
||||
type BookReadingSession struct {
|
||||
Base
|
||||
UserID string `gorm:"index:idx_book_stat,priority:1;size:36;not null" json:"user_id"`
|
||||
BookID string `gorm:"index;size:36;not null" json:"book_id"`
|
||||
BucketStart time.Time `gorm:"index:idx_book_stat,priority:2" json:"bucket_start"` // 截断到小时
|
||||
Seconds int64 `json:"seconds"`
|
||||
CharsRead int64 `json:"chars_read"`
|
||||
PagesRead int `json:"pages_read"`
|
||||
}
|
||||
|
||||
// BookDailyStat 每日汇总,供热力图与「年度阅读报告」查询,避免实时扫 session 表。
|
||||
type BookDailyStat struct {
|
||||
Base
|
||||
UserID string `gorm:"uniqueIndex:uniq_user_book_daily,priority:1;size:36;not null" json:"user_id"`
|
||||
Day string `gorm:"uniqueIndex:uniq_user_book_daily,priority:2;size:10;not null" json:"day"` // YYYY-MM-DD
|
||||
Seconds int64 `json:"seconds"`
|
||||
Chars int64 `json:"chars"`
|
||||
Pages int `json:"pages"`
|
||||
Books int `json:"books"` // 当日有阅读记录的书数
|
||||
}
|
||||
```
|
||||
|
||||
### 3.4 关键取舍:正文不入库
|
||||
|
||||
**决策:DB 只存章节索引(偏移量 / zip 内路径 / 页码区间),正文按需从源文件读取。**
|
||||
|
||||
理由:
|
||||
1. 网文 TXT 常见 5–50MB,漫画单册 100–800MB。入库会让 SQLite 单文件膨胀到数十 GB,直接冲击 `docker-compose.simple.yml` 的「单文件数据库好备份」定位,也会拖慢全库 VACUUM / 备份 / 数据库迁移(`internal/service/database_admin.go`)。
|
||||
2. 源文件本来就是权威副本,重复存储没有收益。
|
||||
3. EPUB 与 CBZ 本质上都是 zip,**随机读取 zip 内单个条目成本极低**(读中央目录 + 解压目标条目),不需要把整本解压落盘。
|
||||
|
||||
代价是每次打开章节都要读源文件。缓解手段:
|
||||
- 本地源:`os.Open` + `io.SectionReader`,代价可忽略。
|
||||
- 网盘源:见 4.3 的本地缓存策略,且对已缓存的章节走本地。
|
||||
|
||||
### 3.5 用户级字段(挂在 `model.User` 上)
|
||||
|
||||
沿用 `AllowedLibraryIDs` 的 JSON-in-text 模式(见 `internal/model/user.go`),**不复用影视库字段**,避免两个 ID 空间交叉:
|
||||
|
||||
```go
|
||||
// 追加到 model.User
|
||||
ReaderSettings string `gorm:"type:text" json:"-"` // 阅读器偏好 JSON
|
||||
AllowedBookLibraryIDs string `gorm:"type:text" json:"-"` // 空 = 不限制
|
||||
AllowedBookLibraryList []string `gorm:"-" json:"allowed_book_library_ids,omitempty"`
|
||||
```
|
||||
|
||||
`ReaderSettings` 结构(前端读写,服务端仅透传与长度校验):
|
||||
|
||||
```json
|
||||
{
|
||||
"mode": "scroll|paged",
|
||||
"fontSize": 18,
|
||||
"lineHeight": 1.8,
|
||||
"fontFamily": "serif|sans|custom",
|
||||
"contentWidth": 720,
|
||||
"theme": "light|sepia|dark|black",
|
||||
"pageAnimation": "slide|fade|none",
|
||||
"comicLayout": "single|double|auto",
|
||||
"comicDirection": "ltr|rtl",
|
||||
"hideScrollbar": true
|
||||
}
|
||||
```
|
||||
|
||||
放在 `User` 行内(而非新表)的理由:与 `PlayerVolume` / `DanmakuFontSize` 等既有播放器偏好一致,读取时随用户信息一并返回,无需额外查询。
|
||||
|
||||
---
|
||||
|
||||
## 4. 书源与内容读取管线
|
||||
|
||||
### 4.1 扫描流程
|
||||
|
||||
```
|
||||
POST /api/books/libraries/:id/scan
|
||||
→ BookScannerService.ScanLibrary(ctx, libraryID)
|
||||
1. 置 ScanStatus=scanning,通过 SSEHub 广播进度(复用 service.SSEHub)
|
||||
2. 遍历启用的 BookSource
|
||||
- local: filepath.WalkDir,按扩展名白名单过滤,超过 Depth 停止递归
|
||||
- cloud: cloud.New(cfg.Type, cfg, client).List(ctx, dirID) 递归列目录
|
||||
3. 对每个候选文件调 BookParser.ParseMeta(reader) 拿元信息 + 目录
|
||||
4. Upsert 到 books / book_chapters(source_id + source_path 为幂等键)
|
||||
5. 源上已消失的书标记软删除(与影视库扫描语义保持一致)
|
||||
6. 置 ScanStatus=idle,记录 LastScanAt
|
||||
```
|
||||
|
||||
扩展名白名单:`.epub .txt .pdf .mobi .azw3 .cbz .cbr .zip .rar`(`.zip/.rar` 仅当目录内全是图片时按漫画处理,否则跳过,防止误吞压缩包)。
|
||||
|
||||
并发:复用 `internal/service` 现有的 worker 池写法,默认 2–4 并发解析(解析要读文件,IO 密集)。
|
||||
|
||||
### 4.2 各格式解析策略
|
||||
|
||||
| 格式 | 元信息 | 章节 / 页 | 正文读取 |
|
||||
| --- | --- | --- | --- |
|
||||
| **EPUB** | zip → `META-INF/container.xml` → OPF → `dc:title/dc:creator/dc:language/dc:description`;封面取 OPF `meta[name=cover]` 指向项,退化到 `guide` | 按 spine 顺序,标题取每个 XHTML 的 `<title>` 或首个 `h1..h3`;`Level` 由 nav/ncx 的嵌套深度推断 | `archive/zip` 定位 `Href` 条目,读出 XHTML → 服务端清洗后返回 |
|
||||
| **TXT** | 文件名(`书名 - 作者.txt` 模式)+ 编码探测 | 正则切分:`第[一二三四五六七八九十百千零两0-9]+[章节卷回篇]`、`Chapter\s+\d+`、`^\s*\d+\s*$`;命中不足 3 个则按固定字节窗口切片 | `io.SectionReader` 读 `[StartOffset, EndOffset)` → 按探测到的编码转 UTF-8 |
|
||||
| **PDF** | 首页/元数据(页数、标题);封面渲染首屏,失败则留空 | 单章「正文」,`PageStart/PageEnd` = 全书页 | 原始文件流(Range),前端 pdf.js 自己解析 |
|
||||
| **CBZ / CBR** | zip/rar 条目自然排序,第一张图做封面 | 单章,页区间 = 图片条目序号 | 按页解压单条目,走图片响应路径 |
|
||||
| **图片文件夹** | 目录名 | 单章,页区间 = 排序后图片序号 | 直接读本地文件 |
|
||||
| **MOBI / AZW3** | PalmDOC / KF8 头 | 首版**只入库展示、不支持在线阅读**,详情页给出「下载原文件」入口 | — |
|
||||
|
||||
实现细节提示:
|
||||
- 编码探测用 `golang.org/x/text`(已是 `go.mod` 间接依赖)。GBK/Big5/UTF-16LE 都要覆盖,中文网文 TXT 大量是 GBK。
|
||||
- CBR 需要 RAR 解压。建议引入纯 Go 的 `github.com/nwaples/rardecode`;若不接受新依赖,首版把 CBR 归入「只入库、不可读」。
|
||||
- EPUB XHTML 清洗**必须在服务端做**:剔除 `<script>`、`on*` 事件属性、`<iframe>`、外部 `http(s)` 资源引用,把 `src/href` 重写为 `/api/books/:id/res/*`。前端再叠一层 DOMPurify 作为纵深防御。
|
||||
|
||||
### 4.3 网盘书籍的读取策略
|
||||
|
||||
网盘直链的核心约束:**EPUB / CBZ 的解析必须能读到文件尾部**(zip 中央目录在末尾),但 `cloud.Provider.Resolve` 返回的是短时效 URL,且 115 直链依赖 UA/Cookie(`DirectLink.Headers`),浏览器无法直接携带。
|
||||
|
||||
因此分两条路径:
|
||||
|
||||
**A. 解析阶段 —— 完整拉取到缓存目录**
|
||||
|
||||
```
|
||||
<CacheDir>/books/<sourceID>/<hash>.<ext>
|
||||
```
|
||||
|
||||
`BookParser` 通过 `DirectLink` 拉全量文件到缓存后再解析。缓存目录复用 `config.CacheConfig.CacheDir`(默认 `<DataDir>/cache`,容器里是 `/cache`),容量上限新加一项 `CacheConfig.BooksMaxSizeMB`(默认 2GB),走 LRU 淘汰。缓存命中的书后续正文读取也直接走本地,不再回网盘。
|
||||
|
||||
**B. 阅读阶段 —— 优先本地缓存,未命中走代理流**
|
||||
|
||||
未缓存时由服务端反代目标 URL(`DirectLink.Proxy=true` 时同样反代),并把 `Content-Type: image/*` 或 `application/pdf` 透传给前端。反代实现直接参照 `internal/service/cloud115_hls_proxy.go` 的响应头透传白名单(`Content-Type/Content-Length/Content-Range/Accept-Ranges/ETag/Last-Modified`)。
|
||||
|
||||
**C. 阅读进度与文件解耦** —— 代码里区分「源」「位置」:
|
||||
|
||||
```go
|
||||
type BookLocator struct {
|
||||
Kind string `json:"kind"` // local / cloud
|
||||
LocalPath string `json:"local_path,omitempty"`
|
||||
CloudConfig string `json:"cloud_config,omitempty"`
|
||||
CloudRef string `json:"cloud_ref,omitempty"`
|
||||
Href string `json:"href,omitempty"` // zip 内条目
|
||||
StartOffset int64 `json:"start_offset,omitempty"`
|
||||
EndOffset int64 `json:"end_offset,omitempty"`
|
||||
}
|
||||
```
|
||||
|
||||
被缓存的书 `Kind` 仍报 `cloud`(进度不绑物理位置),这样缓存被淘汰后进度依然有效。这是不把 `Book.Path` 直接存成本地缓存路径的原因。
|
||||
|
||||
### 4.4 磁盘与容器
|
||||
|
||||
书籍目录需要在 compose 里挂载,并在 README 的部署档位表补充说明。新缓存目录复用现有 `MEBOX_CACHE_CACHE_DIR`(`docker-compose.simple.yml` 中为 `/cache`),无需新增环境变量。
|
||||
|
||||
---
|
||||
|
||||
## 5. HTTP API 设计
|
||||
|
||||
全部挂在 `/api/books/*`,注册在 `registerAuthedBookRoutes`。响应统一走 `internal/handler/response.go` 的既有助手。
|
||||
|
||||
### 5.1 书库与扫描(管理端)
|
||||
|
||||
| 方法 | 路径 | 权限 | 说明 |
|
||||
| --- | --- | --- | --- |
|
||||
| GET | `/api/books/libraries` | `can_read_books` | 列表,按 `AllowedBookLibraryIDs` 过滤可见性 |
|
||||
| POST | `/api/books/libraries` | `can_manage_book_library` | 新建/更新书库 |
|
||||
| DELETE | `/api/books/libraries/:id` | `can_manage_book_library` | 删除(含级联软删 books) |
|
||||
| GET | `/api/books/libraries/:id/sources` | `can_manage_book_library` | 书源列表 |
|
||||
| POST | `/api/books/libraries/:id/sources` | `can_manage_book_library` | 新增书源(本地目录 / 网盘路径) |
|
||||
| POST | `/api/books/libraries/:id/scan` | `can_manage_book_library` | 触发扫描,返回 task id |
|
||||
| GET | `/api/books/scan/status` | `can_manage_book_library` | 扫描进度轮询 |
|
||||
| GET | `/api/books/browse` | `can_manage_book_library` | 网盘路径浏览(复用 cloud Provider.List) |
|
||||
|
||||
### 5.2 书架与详情
|
||||
|
||||
| 方法 | 路径 | 说明 |
|
||||
| --- | --- | --- |
|
||||
| GET | `/api/books` | 书架列表。参数:`library_id`、`keyword`、`media_kind`、`format`、`tag`、`sort`(`title/added_at/last_read/progress`)、`page/page_size` |
|
||||
| GET | `/api/books/continue-reading` | 最近在读,首页「继续阅读」区块用 |
|
||||
| GET | `/api/books/:id` | 详情(元信息 + 目录树 + 当前用户进度 + 收藏态) |
|
||||
| GET | `/api/books/:id/cover` | 封面。走 `ImageProxy` 的缓存与缩放,参数 `w` |
|
||||
| GET | `/api/books/:id/chapters/:index` | 章节正文。电子书返回 `text/html`(已清洗)或 `application/json` 结构化段落 |
|
||||
| GET | `/api/books/:id/res/*path` | EPUB 内部资源(图片/字体/CSS),路径参数为 zip 内条目 |
|
||||
| GET | `/api/books/:id/pages/:index` | 漫画单页图片,`Content-Type: image/*` + 长效缓存头 |
|
||||
| GET | `/api/books/:id/file` | 原始文件流(Range),pdf.js 与「下载原文件」共用 |
|
||||
| POST | `/api/books/:id/favorite` | 收藏 / 取消收藏 |
|
||||
| DELETE | `/api/books/:id` | 删除(`can_manage_books`) |
|
||||
|
||||
**章节响应格式(推荐 JSON 而非裸 HTML)**:
|
||||
|
||||
```json
|
||||
{
|
||||
"index": 12,
|
||||
"title": "第十二章 雨夜",
|
||||
"char_count": 3820,
|
||||
"blocks": [
|
||||
{ "type": "p", "text": "……" },
|
||||
{ "type": "img", "src": "/api/books/xxx/res/images/1.png" }
|
||||
],
|
||||
"next_index": 13,
|
||||
"prev_index": 11
|
||||
}
|
||||
```
|
||||
|
||||
用结构化 blocks 而非 HTML 的理由:
|
||||
1. 前端可安全渲染,不必 `dangerouslySetInnerHTML`,彻底绕开 XSS 面。
|
||||
2. 分页模式需要按节点测量高度做分栏,结构化的段落数组比操作 DOM 简单得多。
|
||||
3. 字号/行距/主题切换只需重渲染,不碰 HTML 字符串。
|
||||
|
||||
保底方案:`?format=html` 仍返回清洗后的 HTML,供 EPUB 中复杂排版(表格、脚注、双向文字)回退。
|
||||
|
||||
### 5.3 进度、批注、统计
|
||||
|
||||
| 方法 | 路径 | 说明 |
|
||||
| --- | --- | --- |
|
||||
| GET | `/api/books/:id/progress` | 当前用户进度 |
|
||||
| PUT | `/api/books/:id/progress` | 保存进度。前端**节流 5s + 页面卸载时 `sendBeacon`** |
|
||||
| GET | `/api/books/:id/annotations` | 批注列表 |
|
||||
| POST | `/api/books/:id/annotations` | 新建 |
|
||||
| PATCH | `/api/books/:id/annotations/:aid` | 修改 note / color |
|
||||
| DELETE | `/api/books/:id/annotations/:aid` | 删除 |
|
||||
| POST | `/api/books/:id/heartbeat` | 阅读心跳,body 为 `{seconds, chars, pages}`,落 `book_reading_sessions` 小时桶 |
|
||||
| GET | `/api/books/reader-settings` | 读取当前用户的阅读器偏好(`model.User.ReaderSettings`) |
|
||||
| PUT | `/api/books/reader-settings` | 保存阅读器偏好(服务端只做长度与枚举校验后原样存储) |
|
||||
| GET | `/api/books/stats` | 个人统计:累计时长、已读书数、在读、近 30 天热力图 |
|
||||
| GET | `/api/books/stats/overview` | 管理员视角:全站阅读统计(`can_access_settings`) |
|
||||
|
||||
进度写入的并发安全:`uniq_user_book` 复合唯一键 + 先 `Updates` 再 `Create` 的 upsert 模式。**参照 `internal/database/schema_migration.go` 里 `dedupePlaybackHistories` 的前车之鉴**——`PlaybackHistory` 曾因 read-then-write 产生重复行导致唯一索引进不去,新表直接写 upsert,不要复制那个 bug。
|
||||
|
||||
---
|
||||
|
||||
## 6. 前端设计
|
||||
|
||||
### 6.1 路由与导航
|
||||
|
||||
`web/src/appRoutes.tsx` 新增懒加载路由:
|
||||
|
||||
```tsx
|
||||
const BookshelfPage = lazy(() => import('./pages/BookshelfPage').then(m => ({ default: m.BookshelfPage })))
|
||||
const BookDetailPage = lazy(() => import('./pages/BookDetailPage').then(m => ({ default: m.BookDetailPage })))
|
||||
const BookReaderPage = lazy(() => import('./pages/BookReaderPage').then(m => ({ default: m.BookReaderPage })))
|
||||
const BookStatsPage = lazy(() => import('./pages/BookStatsPage').then(m => ({ default: m.BookStatsPage })))
|
||||
const BookLibraryPage = lazy(() => import('./pages/BookLibraryPage').then(m => ({ default: m.BookLibraryPage })))
|
||||
```
|
||||
|
||||
```
|
||||
/books 书架
|
||||
/books/:id 书籍详情(目录、元信息、开始阅读)
|
||||
/books/:id/read 阅读器(全屏,隐藏底栏)
|
||||
/books/stats 阅读统计
|
||||
/books/library 书库管理(adminOnly)
|
||||
```
|
||||
|
||||
`web/src/components/layoutNavigation.ts` 的改动:
|
||||
|
||||
- `MEDIA_NAV_ITEMS` 与 `MOBILE_BOTTOM_NAV_ITEMS` 加「阅读」项(`BookOpen` 图标),普通用户可见。
|
||||
- 新增 `isBookReaderRoute(pathname)`,并在 `shouldShowMobileBottomNav` 中排除 `/books/:id/read`,与 `isPlayerRoute` 的处理一致。
|
||||
- `resolveHeaderBack` 补 `/books/...` 的返回链。
|
||||
- `LAYOUT_NAV_ITEMS` 加「书库管理」条目,`adminOnly: true`。
|
||||
|
||||
### 6.2 页面组成
|
||||
|
||||
```
|
||||
web/src/pages/
|
||||
BookshelfPage.tsx 书架:筛选栏 + 网格/列表双视图 + 继续阅读横滑
|
||||
BookDetailPage.tsx 详情:封面、元信息、目录树、进度、开始/继续阅读
|
||||
BookReaderPage.tsx 阅读器外壳:顶栏 + 内容区 + 底部工具条 + 设置抽屉
|
||||
BookStatsPage.tsx 统计:热力图 + 概览卡片
|
||||
BookLibraryPage.tsx 书库管理:书库 CRUD + 书源 CRUD + 扫描触发与进度
|
||||
web/src/components/
|
||||
book/ReaderCore.tsx 渲染内核分发(按 media_kind + format)
|
||||
book/ScrollReader.tsx 滚动流式
|
||||
book/PagedReader.tsx 分页翻页
|
||||
book/ComicReader.tsx 漫画(单页/双页/右开本/预加载)
|
||||
book/PdfReader.tsx PDF(pdf.js)
|
||||
book/ReaderToolbar.tsx 顶栏 + 底栏(章节、进度、目录、批注、设置)
|
||||
book/ReaderSettingsPanel.tsx 阅读设置
|
||||
book/ChapterTocDrawer.tsx 目录抽屉
|
||||
book/AnnotationList.tsx 书签笔记列表
|
||||
book/ReaderProgressBar.tsx 进度条(可拖拽跳章)
|
||||
web/src/api/books.ts 接口封装
|
||||
```
|
||||
|
||||
对于 4 类内容,`ReaderCore` 的分发是第一层决策:
|
||||
|
||||
| `media_kind` | `format` | 内核 |
|
||||
| --- | --- | --- |
|
||||
| ebook | epub / txt | `ScrollReader` 或 `PagedReader`(按 `settings.mode`) |
|
||||
| ebook | pdf | `PdfReader` |
|
||||
| comic | cbz / cbr / folder | `ComicReader` |
|
||||
| ebook | mobi / azw3 | 不提供阅读,仅详情页 |
|
||||
|
||||
### 6.3 渲染内核选型(关键决策)
|
||||
|
||||
**结论:自研内核,不引入 epub.js / foliate-js。**
|
||||
|
||||
对比:
|
||||
|
||||
| 方案 | 优点 | 缺点 |
|
||||
| --- | --- | --- |
|
||||
| `epub.js` | 成熟、CFI 精确定位、多列分页开箱即用 | 维护停滞;CFI 定位难以与自研进度模型(`charOffset` / `percent`)对齐;PDF/漫画仍需另做两个内核 |
|
||||
| `foliate-js` | 一套 API 覆盖 EPUB/MOBI/CBZ/PDF,排版质量高 | 生态小、文档薄、非稳定 API,需要 vendored 一份并自行承担升级风险 |
|
||||
| **自研(推荐)** | 进度模型完全可控、跨端一致;零新增重依赖;与既有 Tailwind 主题体系天然统一 | 需要自己实现分页测量、脏 HTML 清洗、资源重写 |
|
||||
|
||||
自研方案的可行性依据:分页的本质是「CSS multi-column 布局 + `transform: translateX` 平移」,foliate-js 也是这么做的,核心约 200 行;滚动模式的虚拟化可以直接复用已有的 `react-virtuoso`(已在 `web/package.json`,用于 `VirtualMediaGrid`)。
|
||||
|
||||
自研必须做好的三件事:
|
||||
|
||||
1. **HTML 清洗**:服务端为主(见 4.2),前端用 `dompurify` 兜底。这是新增的唯一运行时依赖。
|
||||
2. **资源重写**:EPUB 内部图片/字体/CSS 的 `src`、`href`、`url()` 全部重写到 `/api/books/:id/res/`,否则相对路径会 404。
|
||||
3. **分页测量与重排**:容器尺寸变化(窗口 resize、字号切换、横竖屏)后必须重新分页,并把「当前段落 + 段内比例」作为锚点恢复位置,不能让用户跳回章首。
|
||||
|
||||
### 6.4 双模式实现
|
||||
|
||||
**滚动模式(`ScrollReader`)**
|
||||
- 章内虚拟化:单章文本通常 2k–10k 字,直接整章渲染即可;跨章用「当前章 + 前后各一章」的窗口,滚动到边界时无缝追加。
|
||||
- 进度:`IntersectionObserver` 观测可视段落,映射为 `charOffset`;`scroll_ratio` 同时上报。
|
||||
- 优势:移动端体验好,实现简单,长段落无分页误差。
|
||||
|
||||
**分页模式(`PagedReader`)**
|
||||
- 章内:容器设为多列(`column-width: <contentWidth>`),`overflow: hidden`,通过 `translateX` 翻页;总页数由 `scrollWidth / containerWidth` 得出。
|
||||
- 跨章:翻到本章末尾自动加载下一章首页;反向同理。章首/章尾需处理「残页合并」,避免出现半屏空白页。
|
||||
- 输入:左右方向键、空格、点击左右热区、滑动手势(移动端)。`comicDirection`/`pageAnimation` 控制方向与动画。
|
||||
- 进度:`chapter_index` + `page_index` 映射回 `charOffset`。
|
||||
|
||||
两种模式共享 `BookProgress`,切换模式时用「章 + 比率」换算,不丢位置。
|
||||
|
||||
### 6.5 状态与持久化
|
||||
|
||||
- 阅读器设置来自 `authStore` 的用户信息(`ReaderSettings` 反序列化),改动后 `PUT /api/books/reader-settings` 持久化 + 本地 `localStorage` 兜底(首屏渲染不等接口)。
|
||||
- 进度本地先写 `localStorage`(key `mebook:book:<id>:pos`),再节流同步服务端;页面隐藏/卸载用 `navigator.sendBeacon` 保证不丢。
|
||||
- 新增 `web/src/stores/readerSettings.ts`(zustand),与既有 `playProfile.ts` 组织方式一致。
|
||||
|
||||
---
|
||||
|
||||
## 7. 权限与多用户
|
||||
|
||||
`model.UserPermission` 新增 4 位(当前 18 个字段,加后 22 位):
|
||||
|
||||
| 权限位 | 默认 | 含义 |
|
||||
| --- | --- | --- |
|
||||
| `can_read_books` | `true` | 书架、阅读、进度、批注 |
|
||||
| `can_manage_book_library` | `false` | 书库 / 书源 CRUD、触发扫描、网盘浏览 |
|
||||
| `can_manage_books` | `false` | 编辑书籍元信息、删除书、手动重新解析 |
|
||||
| `can_view_book_stats` | `false` | 查看全站阅读统计 |
|
||||
|
||||
同步改动清单(**漏一处就会出现「后端有权限、前端不显示开关」的静默 bug**):
|
||||
|
||||
1. `internal/model/permission.go` — 字段、`NewDefaultPermission()`、`PermissionMap()`,并更新文件头注释里的数量描述(注释目前写「19项」,实际 18 个字段,顺手修正)。
|
||||
2. `web/src/types/auth.ts` — `PermissionFlags` 接口加 4 个字段。
|
||||
3. `web/src/stores/permissions.ts` — 默认值对象、中文标签映射、权限分组数组。
|
||||
4. `web/src/hooks/usePermission.ts` — 若其中有分组注释需同步。
|
||||
5. `internal/handler/permissions.go` — 权限矩阵响应(若有枚举)。
|
||||
6. `web/src/pages/AdminUsersForm.tsx` / 权限勾选 UI — 若按分组硬编码了列表。
|
||||
|
||||
书库可见性:
|
||||
|
||||
- 管理员在用户管理页勾选该用户可访问的书库,写入 `User.AllowedBookLibraryIDs`。
|
||||
- 空值 = 不限制(与影视库语义一致)。
|
||||
- 过滤集中在一个 `bookVisibility` 助手,与现有的 `internal/handler/visibility.go` 并列(该文件就是影视库可见性的集中判定点,并且会与 `PlayProfile.AllowedLibraryIDs` 求交集)。**阅读模块首版不接播放配置档**——`PlayProfile` 是影视播放器概念(音量、转码参数、PIN),与阅读无关;但判定入口要与它放在同一层,将来若要按配置档限制书库才不用重构。
|
||||
- **服务端强制**:`GET /api/books/:id`、章节、页面、资源(`/res/*`)、封面、原始文件流,**所有**按 ID 取内容的接口都要校验 `book.LibraryID ∈ 用户可见书库`,不能只靠书架列表过滤。这是最容易漏的越权点:`/api/books/:id/res/*path` 会直接吐出书籍内部的原始资源,漏校验等于开放全库文件读取。
|
||||
- 用户被取消书库授权后,其 `BookProgress` / `BookAnnotation` 保留不删(授权恢复即恢复),但接口一律按当前可见性判定,不因历史数据放行。
|
||||
|
||||
---
|
||||
|
||||
## 8. 阅读统计
|
||||
|
||||
- **采集**:阅读器每 30s 发一次 `heartbeat`,卸载时补发一次;服务端按 `(user_id, book_id, 小时桶)` 累加,行数上限 = 用户数 × 书数 × 阅读小时数,可控。
|
||||
- **汇总**:`Scheduler` 每日 03:00 把昨天之前的 session 滚进 `BookDailyStat`(复用 `service.Scheduler` 的既有定时任务注册方式)。
|
||||
- **展示**:
|
||||
- 个人页「阅读统计」:累计时长、读完本数、在读本数、近 30 天热力图(仿 GitHub 贡献图)、阅读类型分布(电子书 / 漫画)。
|
||||
- 首页新增「继续阅读」横滑区块(参照 `HomePageSections.tsx` 里既有区块的写法)。
|
||||
- 管理员视图:全站活跃度、热门书籍 Top 20(需 `can_view_book_stats`)。
|
||||
|
||||
隐私:统计仅对本人与管理员可见;管理员视图只出聚合数据,不暴露单个用户的阅读内容。
|
||||
|
||||
---
|
||||
|
||||
## 9. 分期实施计划
|
||||
|
||||
### P0 — 端到端可用(本地书库 / EPUB + TXT 电子书)
|
||||
|
||||
目标:能扫库、能在网页上把一本书读完、关掉浏览器再打开能续读。
|
||||
|
||||
| # | 交付物 |
|
||||
| --- | --- |
|
||||
| 1 | `internal/model/book.go` 九张表 + `AllModels()` 注册 + 迁移验证(SQLite 与 PostgreSQL 各跑一次升级) |
|
||||
| 2 | `BookLibrary` / `BookSource` / `Book` / `BookChapter` / `BookProgress` 的 repository |
|
||||
| 3 | `BookParser`:EPUB 与 TXT 解析(含 GBK 编码探测、章节正则切分、封面提取) |
|
||||
| 4 | `BookScannerService`:本地目录扫描 + upsert + 进度广播 |
|
||||
| 5 | API:书库 CRUD、书源 CRUD、扫描、书架列表、详情、章节正文、封面、进度读写、阅读器偏好读写 |
|
||||
| 6 | 前端:`BookshelfPage`、`BookDetailPage`、`BookReaderPage`(仅滚动模式)、目录抽屉、阅读设置面板 |
|
||||
| 7 | 权限:4 个权限位 + `AllowedBookLibraryIDs` 全链路(含服务端越权校验) |
|
||||
|
||||
**验收标准**
|
||||
- 一个含 50 本 EPUB 与 20 本 GBK 编码 TXT 的目录,扫描后书架正确列出,标题/作者/封面/章节目录无误。
|
||||
- 任意一本书可连续阅读 3 章以上,刷新页面后回到原位置(误差 < 1 段)。
|
||||
- 权限为 `can_read_books=false` 的账号访问 `/api/books` 返回 403;直接请求他人书库的 `/api/books/:id/chapters/0`、`/api/books/:id/res/*`、`/api/books/:id/file` 同样被拒。
|
||||
- SQLite 单文件档与 PostgreSQL 档都能从旧版本升级启动,无迁移报错。
|
||||
|
||||
### P1 — 漫画 + 分页模式 + 网盘直链
|
||||
|
||||
| # | 交付物 |
|
||||
| --- | --- |
|
||||
| 1 | `ComicReader`:CBZ 解析、单页/双页、右开本、相邻页预加载 |
|
||||
| 2 | `PagedReader`:分页测量、resize 重排、跨章衔接、键鼠与手势输入 |
|
||||
| 3 | 网盘书源:`StorageKind=cloud` 的书源配置、`cloud.Provider` 接入、本地缓存目录 + LRU 淘汰 |
|
||||
| 4 | 网盘书籍的索引拉取与阅读反代(含 `Content-Range` 透传) |
|
||||
| 5 | PDF:`PdfReader`(pdf.js)+ Range 文件流接口 |
|
||||
| 6 | 图片文件夹型漫画 |
|
||||
|
||||
**验收标准**
|
||||
- CBZ 单册 300 页可流畅翻阅,双页模式断页处理正确(避免跨章错配)。
|
||||
- 分页模式下切换字号、resize 窗口、手机横竖屏切换后,位置不跳、不出现空白页。
|
||||
- 挂在 OpenList 与 115 上的 EPUB 能正常入库并在线阅读,缓存目录达到上限后按 LRU 淘汰且不影响已有进度。
|
||||
- 20MB 以上 PDF 可跳页、可缩放。
|
||||
|
||||
### P2 — 批注、统计与体验打磨
|
||||
|
||||
| # | 交付物 |
|
||||
| --- | --- |
|
||||
| 1 | 划线 / 书签 / 笔记:`BookAnnotation` 接口与 UI,批注列表与跳转 |
|
||||
| 2 | 阅读统计:心跳采集、每日汇总任务、个人统计页、首页「继续阅读」区块 |
|
||||
| 3 | 管理员统计视图 + 热门书籍排行 |
|
||||
| 4 | 书库定时扫描(`Scheduler` 接入,默认关闭) |
|
||||
| 5 | 书架高级筛选与排序、合集(系列)聚合视图 |
|
||||
| 6 | MOBI/AZW3 元信息解析(仍不做在线阅读,仅提供下载) |
|
||||
| 7 | 部署文档与 compose 注释更新(书籍目录挂载说明) |
|
||||
|
||||
### P3 — 可选增强
|
||||
听书 TTS、跨设备批注冲突合并、书源自动整理(仿 `OrganizerService`)、EPUB 阅读器内注释锚点高亮。
|
||||
|
||||
---
|
||||
|
||||
## 10. 风险与待拍板项
|
||||
|
||||
### 10.1 需要你拍板的两点
|
||||
|
||||
**① 网盘书籍的缓存策略**
|
||||
- 选项 A(本方案):索引时完整下载到缓存目录,阅读时优先本地。省流量、体验好,但全新书首次打开有等待,且占用磁盘(默认 2GB 上限)。
|
||||
- 选项 B:完全不落盘,每次按 Range/整文件从网盘拉。省磁盘,但每次打开都要重新下载,网盘限速时体验很差。
|
||||
- 选项 C:折中——只对 EPUB/CBZ 缓存(解析必须读全文),漫画原图与 PDF 走流式。
|
||||
|
||||
我的建议是 **C**,因为它把「必须落盘」和「可以不落盘」分开了。
|
||||
|
||||
**② 章节正文的返回格式**
|
||||
- JSON blocks(本方案推荐):安全、便于分页测量,但复杂 EPUB 排版(表格、脚注、竖排)会降级。
|
||||
- 清洗后 HTML:保真度高,但前端要 `dangerouslySetInnerHTML`,XSS 面更大。
|
||||
- 我的建议是 **JSON blocks 为主 + `?format=html` 回退**,两者都实现,前端在遇到 `type: "html-block"` 时回退渲染。
|
||||
|
||||
### 10.2 技术风险
|
||||
|
||||
| 风险 | 影响 | 缓解 |
|
||||
| --- | --- | --- |
|
||||
| 自研分页内核的边界情况多(残页、跨章、RTL、竖排) | P1 可能超期 | P0 先只做滚动模式;分页单独立项,配套 `playerPageModel.test.ts` 那样的单测 |
|
||||
| TXT 章节正则对网文变体覆盖不足 | 目录错乱 | 提供「手动重新切分」入口,规则可配(仿 `RecognitionWordsPanel` 的可配置词表模式) |
|
||||
| 网盘直链失效 / 限速 / 防盗链 | 阅读中断 | 复用现有 115 换链与 `url_cache.go` 的缓存机制;失败时前端降级为「下载原文件」 |
|
||||
| 大 TXT(>50MB)章节表行数过多 | SQLite 写入慢 | 章节超过阈值(如 5000 章)时按固定窗口粗切,或改为「按需切分 + 缓存到章节表」的惰性策略 |
|
||||
| 缓存目录膨胀 | 磁盘打满 | 容量上限 + 复用 `service.PruneImageCache` 的 LRU 清理 + 系统设置页可见 |
|
||||
| 数据库迁移对老库不兼容 | 升级失败 | 新表全部是纯新增,无列变更;不触碰 `ensurePostgresColumnCompatibility` 的既有语句 |
|
||||
|
||||
### 10.3 不引入的新依赖清单
|
||||
|
||||
| 依赖 | 用途 | 取舍 |
|
||||
| --- | --- | --- |
|
||||
| `dompurify` | 前端 HTML 清洗兜底 | **建议引入**(前端必需) |
|
||||
| `pdfjs-dist` | PDF 渲染 | **建议引入**(P1) |
|
||||
| `github.com/nwaples/rardecode` | CBR 解压 | 可选;不接受则 CBR 首版只入库 |
|
||||
| `epub.js` / `foliate-js` | EPUB 渲染 | **不引入**,见 6.3 |
|
||||
|
||||
---
|
||||
|
||||
## 11. 测试策略
|
||||
|
||||
与项目现有测试密度对齐(`internal/service` 下大量 `_test.go`,前端有 `*.test.ts`):
|
||||
|
||||
**后端**
|
||||
- `book_parser_test.go`:EPUB / TXT 各准备 fixture(`testdata/` 下小体积样本),断言元信息、章节数、章节边界字节偏移、GBK 转码正确性。
|
||||
- `book_scanner_test.go`:临时目录扫描 + 重复扫描幂等 + 源文件删除后软删。
|
||||
- `book_progress_test.go`:并发 upsert 不产生重复行(直接复现 `dedupePlaybackHistories` 防的那类 bug)。
|
||||
- `book_permission_test.go`:越权矩阵,逐接口断言非可见书库返回 403/404。
|
||||
- Handler 层:仿 `internal/handler/media_test.go` 起的 `httptest` + 真实内存 SQLite。
|
||||
|
||||
**前端**
|
||||
- `readerModel.test.ts`:模式切换时的位置换算(`scroll ↔ paged`、`charOffset ↔ pageIndex`)、百分比计算、跨章边界。
|
||||
- 分页计算的纯函数抽出单测(不含 DOM),参照 `web/src/pages/playerPageModel.test.ts` 的做法——把逻辑从组件里拔出来测,是项目已有的好传统。
|
||||
|
||||
---
|
||||
|
||||
## 12. 附:改动文件清单
|
||||
|
||||
**后端新增**
|
||||
```
|
||||
internal/model/book.go
|
||||
internal/repository/book_repository.go
|
||||
internal/service/book_parser.go EPUB / TXT / CBZ 解析
|
||||
internal/service/book_parser_epub.go
|
||||
internal/service/book_parser_txt.go
|
||||
internal/service/book_parser_comic.go
|
||||
internal/service/book_scanner.go
|
||||
internal/service/book_reader.go 章节 / 页面 / 资源的读取与清洗
|
||||
internal/service/book_progress.go
|
||||
internal/service/book_stats.go
|
||||
internal/service/book_cache.go 网盘缓存与 LRU
|
||||
internal/handler/books.go
|
||||
internal/handler/books_library.go
|
||||
internal/handler/books_reader.go
|
||||
internal/handler/routes_books.go
|
||||
```
|
||||
|
||||
**后端修改**
|
||||
```
|
||||
internal/model/model.go AllModels() 追加 9 张表
|
||||
internal/model/permission.go 4 个权限位
|
||||
internal/model/user.go ReaderSettings / AllowedBookLibraryIDs
|
||||
internal/repository/repository.go Container 加字段
|
||||
internal/service/service.go Container 加字段 + Boot() 启动扫描
|
||||
internal/handler/routes_authenticated.go 挂载 registerAuthedBookRoutes
|
||||
internal/service/scheduler_local_jobs.go 书籍缓存清理 + 每日阅读统计汇总
|
||||
internal/config/types.go CacheConfig 加 BooksMaxSizeMB;新增 BookConfig(扫描并发等)
|
||||
docker-compose*.yml 书籍目录挂载注释
|
||||
README.md / README_EN.md 能力表新增「阅读」
|
||||
```
|
||||
|
||||
**前端新增**
|
||||
```
|
||||
web/src/api/books.ts
|
||||
web/src/stores/readerSettings.ts
|
||||
web/src/pages/BookshelfPage.tsx
|
||||
web/src/pages/BookDetailPage.tsx
|
||||
web/src/pages/BookReaderPage.tsx
|
||||
web/src/pages/BookStatsPage.tsx
|
||||
web/src/pages/BookLibraryPage.tsx
|
||||
web/src/components/book/*.tsx
|
||||
```
|
||||
**前端修改**
|
||||
```
|
||||
web/src/appRoutes.tsx 4 条路由
|
||||
web/src/components/layoutNavigation.ts 导航项、阅读器路由判定、返回链
|
||||
web/src/types/auth.ts 权限位
|
||||
web/src/stores/permissions.ts 权限位默认值 / 标签 / 分组
|
||||
web/src/pages/HomePageSections.tsx 「继续阅读」区块
|
||||
web/src/pages/settingsGroupBooks.ts (新增)阅读设置分组
|
||||
web/src/pages/settingsGroups.ts 把 settingsGroupBooks 加入 GROUPS 数组
|
||||
```
|
||||

|
Before Width: | Height: | Size: 620 KiB |

|
Before Width: | Height: | Size: 743 KiB |

|
Before Width: | Height: | Size: 793 KiB |

|
Before Width: | Height: | Size: 1.1 MiB |

|
Before Width: | Height: | Size: 612 KiB |

|
Before Width: | Height: | Size: 85 KiB |

|
Before Width: | Height: | Size: 247 KiB |

|
Before Width: | Height: | Size: 376 KiB |

|
Before Width: | Height: | Size: 285 KiB |

|
Before Width: | Height: | Size: 319 KiB |

|
Before Width: | Height: | Size: 306 KiB |

|
Before Width: | Height: | Size: 265 KiB |

|
Before Width: | Height: | Size: 1.1 MiB |
@@ -20,6 +20,12 @@ type settingReq struct {
|
||||
Value string `json:"value"`
|
||||
}
|
||||
|
||||
// maskedSettingKeys 里的设置值绝不能被完整下发:它们是可用于对外操作的凭据。
|
||||
// 下发脱敏值,保存时再靠 isMaskedSettingValue 还原为「保持原值」。
|
||||
var maskedSettingKeys = map[string]bool{
|
||||
service.SettingTelegramBotToken: true,
|
||||
}
|
||||
|
||||
func listSettingsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
settings, err := svc.Repo.Setting.All(c.Request.Context())
|
||||
@@ -27,10 +33,21 @@ func listSettingsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
for i := range settings {
|
||||
if maskedSettingKeys[settings[i].Key] {
|
||||
settings[i].Value = service.MaskSecret(settings[i].Value)
|
||||
}
|
||||
}
|
||||
c.JSON(http.StatusOK, settings)
|
||||
}
|
||||
}
|
||||
|
||||
// isMaskedSettingValue 识别「前端把脱敏值原样提交回来」的情况。此时必须保留
|
||||
// 已存的真实值,否则一次保存就会把凭据覆盖成 ***。
|
||||
func isMaskedSettingValue(value string) bool {
|
||||
return strings.Contains(value, "***")
|
||||
}
|
||||
|
||||
func updateSettingHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
var req settingReq
|
||||
@@ -38,6 +55,11 @@ func updateSettingHandler(svc *service.Container) gin.HandlerFunc {
|
||||
c.JSON(http.StatusBadRequest, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
// 脱敏值回传 == 用户没改这个凭据,保留库里已存的真实值。
|
||||
if maskedSettingKeys[req.Key] && isMaskedSettingValue(req.Value) {
|
||||
c.Status(http.StatusNoContent)
|
||||
return
|
||||
}
|
||||
oldValue := ""
|
||||
if req.Key == service.AdultLibraryIDsSettingKey {
|
||||
oldValue, _ = svc.Repo.Setting.Get(c.Request.Context(), req.Key)
|
||||
|
||||
@@ -0,0 +1,173 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"net/http"
|
||||
"strings"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/middleware"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// 设备管理接口。
|
||||
//
|
||||
// 普通用户只能操作自己的设备(路由挂在 /me 下,用户 ID 始终取自会话);
|
||||
// 管理员通过 /admin/users/:id/devices 代管任意用户。两组接口共用同一份
|
||||
// DeviceService,因此「谁上线过、谁被踢掉」只有一处事实来源。
|
||||
|
||||
// deviceListPayload 是设备列表的下发形状。Fingerprint 不外发:它是防共享
|
||||
// 判定用的内部标识,暴露出去只会方便伪造。
|
||||
type deviceListPayload struct {
|
||||
Devices []devicePayload `json:"devices"`
|
||||
}
|
||||
|
||||
type devicePayload struct {
|
||||
ID string `json:"id"`
|
||||
DeviceID string `json:"device_id"`
|
||||
DeviceName string `json:"device_name,omitempty"`
|
||||
Client string `json:"client,omitempty"`
|
||||
LastIP string `json:"last_ip,omitempty"`
|
||||
LastSeenAt string `json:"last_seen_at,omitempty"`
|
||||
LastPlayAt string `json:"last_play_at,omitempty"`
|
||||
Kicked bool `json:"kicked"`
|
||||
Online bool `json:"online"`
|
||||
Playing bool `json:"playing"`
|
||||
Warnings int `json:"warnings"`
|
||||
}
|
||||
|
||||
func toDevicePayload(d model.UserDevice) devicePayload {
|
||||
out := devicePayload{
|
||||
ID: d.ID,
|
||||
DeviceID: d.DeviceID,
|
||||
DeviceName: d.DeviceName,
|
||||
Client: d.Client,
|
||||
LastIP: d.LastIP,
|
||||
Kicked: d.Kicked,
|
||||
Online: d.Online,
|
||||
Playing: d.Playing,
|
||||
Warnings: d.Warnings,
|
||||
}
|
||||
if !d.LastSeenAt.IsZero() {
|
||||
out.LastSeenAt = d.LastSeenAt.Format("2006-01-02T15:04:05Z07:00")
|
||||
}
|
||||
if d.LastPlayAt != nil && !d.LastPlayAt.IsZero() {
|
||||
out.LastPlayAt = d.LastPlayAt.Format("2006-01-02T15:04:05Z07:00")
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
func deviceListResponse(devices []model.UserDevice) deviceListPayload {
|
||||
items := make([]devicePayload, 0, len(devices))
|
||||
for _, d := range devices {
|
||||
items = append(items, toDevicePayload(d))
|
||||
}
|
||||
return deviceListPayload{Devices: items}
|
||||
}
|
||||
|
||||
// myDevicesHandler 返回当前会话用户的设备列表。
|
||||
func myDevicesHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := sessionUserID(c)
|
||||
devices, err := svc.Device.ListDevices(c.Request.Context(), userID)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, deviceListResponse(devices))
|
||||
}
|
||||
}
|
||||
|
||||
// myKickDeviceHandler 踢掉当前用户的一台设备。
|
||||
func myKickDeviceHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := sessionUserID(c)
|
||||
deviceID := strings.TrimSpace(c.Param("deviceID"))
|
||||
if deviceID == "" {
|
||||
c.JSON(http.StatusBadRequest, gin.H{"error": "device id required"})
|
||||
return
|
||||
}
|
||||
if err := svc.Device.KickDevice(c.Request.Context(), userID, deviceID); err != nil {
|
||||
c.JSON(http.StatusNotFound, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.Status(http.StatusNoContent)
|
||||
}
|
||||
}
|
||||
|
||||
// myKickAllDevicesHandler 踢掉当前用户的全部设备。
|
||||
func myKickAllDevicesHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := sessionUserID(c)
|
||||
if err := svc.Device.KickAllDevices(c.Request.Context(), userID); err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.Status(http.StatusNoContent)
|
||||
}
|
||||
}
|
||||
|
||||
// adminUserDevicesHandler 返回指定用户的设备列表。
|
||||
func adminUserDevicesHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := strings.TrimSpace(c.Param("id"))
|
||||
// FindByID 对「不存在」返回 (nil, nil),必须判空而不是判 error,
|
||||
// 否则「用户不存在」会伪装成「该用户没有设备」的空列表。
|
||||
user, err := svc.Repo.User.FindByID(c.Request.Context(), userID)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
if user == nil {
|
||||
c.JSON(http.StatusNotFound, gin.H{"error": "user not found"})
|
||||
return
|
||||
}
|
||||
devices, err := svc.Device.ListDevices(c.Request.Context(), userID)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, deviceListResponse(devices))
|
||||
}
|
||||
}
|
||||
|
||||
// adminKickUserDeviceHandler 由管理员踢掉指定用户的一台设备。
|
||||
func adminKickUserDeviceHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := strings.TrimSpace(c.Param("id"))
|
||||
deviceID := strings.TrimSpace(c.Param("deviceID"))
|
||||
if deviceID == "" {
|
||||
c.JSON(http.StatusBadRequest, gin.H{"error": "device id required"})
|
||||
return
|
||||
}
|
||||
if err := svc.Device.KickDevice(c.Request.Context(), userID, deviceID); err != nil {
|
||||
c.JSON(http.StatusNotFound, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.Status(http.StatusNoContent)
|
||||
}
|
||||
}
|
||||
|
||||
// adminKickAllUserDevicesHandler 由管理员踢掉指定用户的全部设备。
|
||||
func adminKickAllUserDevicesHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := strings.TrimSpace(c.Param("id"))
|
||||
if err := svc.Device.KickAllDevices(c.Request.Context(), userID); err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.Status(http.StatusNoContent)
|
||||
}
|
||||
}
|
||||
|
||||
// sessionUserID 读取会话用户 ID。调用方路由都挂在鉴权中间件之后,因此这里
|
||||
// 只做类型断言兜底,不做权限判断。
|
||||
func sessionUserID(c *gin.Context) string {
|
||||
if v, ok := c.Get(middleware.CtxUserID); ok {
|
||||
if s, ok := v.(string); ok {
|
||||
return s
|
||||
}
|
||||
}
|
||||
return ""
|
||||
}
|
||||
@@ -0,0 +1,232 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"strings"
|
||||
"testing"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"github.com/glebarez/sqlite"
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/middleware"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// newDeviceTestEnv 搭一个只挂设备/Telegram 路由的最小环境,并预置两个用户,
|
||||
// 用于验证「只能操作自己的设备」这条边界。
|
||||
func newDeviceTestEnv(t *testing.T) (*gin.Engine, *service.Container) {
|
||||
t.Helper()
|
||||
gin.SetMode(gin.TestMode)
|
||||
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatalf("open db: %v", err)
|
||||
}
|
||||
if err := db.AutoMigrate(&model.User{}, &model.UserDevice{}, &model.Setting{}); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
svc := &service.Container{Repo: repos, Log: zap.NewNop()}
|
||||
svc.Device = service.NewDeviceService(zap.NewNop(), repos)
|
||||
svc.Device.SetSessionTracker(service.NewSessionTrackerService(zap.NewNop()))
|
||||
svc.Telegram = service.NewTelegramService(zap.NewNop(), repos)
|
||||
|
||||
const secret = "test-secret"
|
||||
router := gin.New()
|
||||
authed := router.Group("/api", func(c *gin.Context) {
|
||||
// 测试里直接注入会话身份,绕开真实 JWT 解析。
|
||||
if uid := c.GetHeader("X-Test-User"); uid != "" {
|
||||
c.Set(middleware.CtxUserID, uid)
|
||||
c.Set(middleware.CtxUserRole, c.GetHeader("X-Test-Role"))
|
||||
}
|
||||
c.Next()
|
||||
})
|
||||
authed.GET("/me/devices", myDevicesHandler(svc))
|
||||
authed.POST("/me/devices/kick-all", myKickAllDevicesHandler(svc))
|
||||
authed.POST("/me/devices/:deviceID/kick", myKickDeviceHandler(svc))
|
||||
authed.GET("/me/telegram", getTelegramStatusHandler(svc))
|
||||
authed.POST("/me/telegram/bind-code", startTelegramBindHandler(svc))
|
||||
authed.DELETE("/me/telegram", unbindTelegramHandler(svc))
|
||||
authed.GET("/admin/users/:id/devices", adminUserDevicesHandler(svc))
|
||||
authed.POST("/admin/users/:id/devices/:deviceID/kick", adminKickUserDeviceHandler(svc))
|
||||
_ = secret
|
||||
return router, svc
|
||||
}
|
||||
|
||||
func seedDeviceUsers(t *testing.T, svc *service.Container) {
|
||||
t.Helper()
|
||||
ctx := context.Background()
|
||||
for _, id := range []string{"user-a", "user-b"} {
|
||||
if err := svc.Repo.User.Create(ctx, &model.User{
|
||||
Base: model.Base{ID: id}, Username: id, PasswordHash: "x", Role: "user", IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func doJSON(t *testing.T, router *gin.Engine, method, path, userID, role string) *httptest.ResponseRecorder {
|
||||
t.Helper()
|
||||
req := httptest.NewRequest(method, path, nil)
|
||||
req.Header.Set("X-Test-User", userID)
|
||||
if role != "" {
|
||||
req.Header.Set("X-Test-Role", role)
|
||||
}
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
return w
|
||||
}
|
||||
|
||||
// /me/devices 只能返回调用者自己的设备。
|
||||
func TestMyDevicesScopedToCaller(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
seedDeviceUsers(t, svc)
|
||||
ctx := context.Background()
|
||||
|
||||
svc.Device.RecordLogin(ctx, "user-a", "dev-a", "A-Phone", "Infuse", "1.1.1.1")
|
||||
svc.Device.RecordLogin(ctx, "user-b", "dev-b", "B-Phone", "Infuse", "2.2.2.2")
|
||||
|
||||
w := doJSON(t, router, http.MethodGet, "/api/me/devices", "user-a", "user")
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
var payload struct {
|
||||
Devices []struct {
|
||||
DeviceID string `json:"device_id"`
|
||||
} `json:"devices"`
|
||||
}
|
||||
if err := json.Unmarshal(w.Body.Bytes(), &payload); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(payload.Devices) != 1 || payload.Devices[0].DeviceID != "dev-a" {
|
||||
t.Fatalf("devices = %+v, want only dev-a", payload.Devices)
|
||||
}
|
||||
// 设备指纹属于内部判定标识,不能下发。
|
||||
if strings.Contains(w.Body.String(), "fingerprint") {
|
||||
t.Fatalf("response must not expose fingerprint: %s", w.Body.String())
|
||||
}
|
||||
}
|
||||
|
||||
// 踢别人的设备必须失败:/me 路由用会话身份,deviceID 属于他人时查不到。
|
||||
func TestKickForeignDeviceFails(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
seedDeviceUsers(t, svc)
|
||||
svc.Device.RecordLogin(context.Background(), "user-b", "dev-b", "B-Phone", "Infuse", "2.2.2.2")
|
||||
|
||||
w := doJSON(t, router, http.MethodPost, "/api/me/devices/dev-b/kick", "user-a", "user")
|
||||
if w.Code == http.StatusNoContent {
|
||||
t.Fatal("user-a must not be able to kick user-b's device")
|
||||
}
|
||||
}
|
||||
|
||||
func TestMyKickOwnDeviceSucceeds(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
seedDeviceUsers(t, svc)
|
||||
svc.Device.RecordLogin(context.Background(), "user-a", "dev-a", "A-Phone", "Infuse", "1.1.1.1")
|
||||
|
||||
w := doJSON(t, router, http.MethodPost, "/api/me/devices/dev-a/kick", "user-a", "user")
|
||||
if w.Code != http.StatusNoContent {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
}
|
||||
|
||||
// 管理员接口对不存在的用户返回 404,避免把「用户不存在」和「用户没有设备」
|
||||
// 混成同一个空列表。
|
||||
func TestAdminDevicesUnknownUserReturns404(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
seedDeviceUsers(t, svc)
|
||||
|
||||
w := doJSON(t, router, http.MethodGet, "/api/admin/users/nope/devices", "admin-1", "admin")
|
||||
if w.Code != http.StatusNotFound {
|
||||
t.Fatalf("status = %d, want 404", w.Code)
|
||||
}
|
||||
}
|
||||
|
||||
func TestTelegramStatusAndBindCode(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
seedDeviceUsers(t, svc)
|
||||
|
||||
w := doJSON(t, router, http.MethodGet, "/api/me/telegram", "user-a", "user")
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d", w.Code)
|
||||
}
|
||||
if !strings.Contains(w.Body.String(), `"bound":false`) {
|
||||
t.Fatalf("body = %s, want bound=false", w.Body.String())
|
||||
}
|
||||
|
||||
w = doJSON(t, router, http.MethodPost, "/api/me/telegram/bind-code", "user-a", "user")
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
var code struct {
|
||||
Code string `json:"code"`
|
||||
ExpiresIn int `json:"expires_in_seconds"`
|
||||
}
|
||||
if err := json.Unmarshal(w.Body.Bytes(), &code); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(code.Code) != 6 {
|
||||
t.Fatalf("code = %q, want 6 chars", code.Code)
|
||||
}
|
||||
if code.ExpiresIn <= 0 {
|
||||
t.Fatalf("expires_in_seconds = %d, want > 0", code.ExpiresIn)
|
||||
}
|
||||
}
|
||||
|
||||
func TestAdminSettingsMasksBotToken(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
ctx := context.Background()
|
||||
if err := svc.Repo.Setting.Set(ctx, service.SettingTelegramBotToken, "123456:AAHsecretTOKEN"); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
router.GET("/api/admin/settings", listSettingsHandler(svc))
|
||||
router.PUT("/api/admin/settings", updateSettingHandler(svc))
|
||||
|
||||
w := doJSON(t, router, http.MethodGet, "/api/admin/settings", "admin-1", "admin")
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d", w.Code)
|
||||
}
|
||||
if strings.Contains(w.Body.String(), "AAHsecretTOKEN") {
|
||||
t.Fatalf("bot token leaked: %s", w.Body.String())
|
||||
}
|
||||
if !strings.Contains(w.Body.String(), "***") {
|
||||
t.Fatalf("bot token should be masked: %s", w.Body.String())
|
||||
}
|
||||
}
|
||||
|
||||
// 把脱敏值原样提交回来时,必须保留库里真实 Token —— 否则一次保存就把凭据毁掉。
|
||||
func TestSavingMaskedTokenKeepsRealValue(t *testing.T) {
|
||||
router, svc := newDeviceTestEnv(t)
|
||||
ctx := context.Background()
|
||||
const real = "123456:AAHsecretTOKEN"
|
||||
if err := svc.Repo.Setting.Set(ctx, service.SettingTelegramBotToken, real); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
router.PUT("/api/admin/settings", updateSettingHandler(svc))
|
||||
|
||||
body := `{"key":"telegram.bot_token","value":"12***EN"}`
|
||||
req := httptest.NewRequest(http.MethodPut, "/api/admin/settings", strings.NewReader(body))
|
||||
req.Header.Set("Content-Type", "application/json")
|
||||
req.Header.Set("X-Test-User", "admin-1")
|
||||
req.Header.Set("X-Test-Role", "admin")
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
|
||||
if w.Code != http.StatusNoContent {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
got, err := svc.Repo.Setting.Get(ctx, service.SettingTelegramBotToken)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got != real {
|
||||
t.Fatalf("stored token = %q, want the original value preserved", got)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,122 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"net/http"
|
||||
"strconv"
|
||||
"strings"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// Emby 发现类接口的 handler:NextUp / Similar / Genres。
|
||||
//
|
||||
// 这三个接口此前返回空列表,导致第三方客户端首页「接下来播放」、详情页
|
||||
// 「相似推荐」、按类型浏览全部为空白。它们必须始终返回 200 + 合法信封,
|
||||
// 因为客户端在首页刷新时会并发请求,任何 4xx/5xx 都会被判定为服务端异常。
|
||||
|
||||
func embyNextUpHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := embyScopedUserID(c)
|
||||
if userID == "" {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
limit, _ := strconv.Atoi(embyFirstNonEmptyString(firstQueryValue(c, "Limit", "limit"), ""))
|
||||
// YamBy / Emby 进剧集详情会带 SeriesId 请求「本剧下一集」。
|
||||
// 忽略该参数会把全站 NextUp 第一条塞进详情页「继续播放」。
|
||||
// 注意:不要把普通 ParentId(媒体库)当成 SeriesId,否则首页 NextUp 会被滤空。
|
||||
seriesID := firstQueryValue(c, "SeriesId", "seriesId", "seriesid")
|
||||
if seriesID == "" {
|
||||
if parentID := firstQueryValue(c, "ParentId", "parentId", "parentid"); parentID != "" {
|
||||
if strings.HasPrefix(parentID, "msgo-series-") || service.IsEmbyRemoteID(parentID) {
|
||||
seriesID = parentID
|
||||
}
|
||||
}
|
||||
}
|
||||
out, err := svc.Emby.NextUp(c.Request.Context(), userID, seriesID, limit)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
embyAttachRequestTokenToMediaSources(c, out)
|
||||
c.JSON(http.StatusOK, out)
|
||||
}
|
||||
}
|
||||
|
||||
// embyShowNextUpHandler 处理 /Shows/{id}/NextUp:把路径上的剧集 ID 当作 SeriesId。
|
||||
func embyShowNextUpHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
userID := embyScopedUserID(c)
|
||||
if userID == "" {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
seriesID := strings.TrimSpace(c.Param("id"))
|
||||
if seriesID == "" || strings.EqualFold(seriesID, "NextUp") {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
limit, _ := strconv.Atoi(embyFirstNonEmptyString(firstQueryValue(c, "Limit", "limit"), ""))
|
||||
out, err := svc.Emby.NextUp(c.Request.Context(), userID, seriesID, limit)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
embyAttachRequestTokenToMediaSources(c, out)
|
||||
c.JSON(http.StatusOK, out)
|
||||
}
|
||||
}
|
||||
|
||||
func embySimilarHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
mediaID := strings.TrimSpace(c.Param("id"))
|
||||
if mediaID == "" {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
limit, _ := strconv.Atoi(embyFirstNonEmptyString(firstQueryValue(c, "Limit", "limit"), ""))
|
||||
out, err := svc.Emby.SimilarItems(c.Request.Context(), mediaID, embyEffectiveUserID(c), limit)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
embyAttachRequestTokenToMediaSources(c, out)
|
||||
c.JSON(http.StatusOK, out)
|
||||
}
|
||||
}
|
||||
|
||||
func embyGenresHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
parentID := firstQueryValue(c, "ParentId", "parentId", "parentid")
|
||||
out, err := svc.Emby.Genres(c.Request.Context(), embyEffectiveUserID(c), parentID)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusOK, embyEmptyItemsPayload())
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, out)
|
||||
}
|
||||
}
|
||||
|
||||
// embyScopedUserID 解析「按用户请求」的 Emby 接口的生效用户。
|
||||
//
|
||||
// 路由上带 :userId 时(/Users/{uid}/Shows/NextUp),只允许查询自己:客户端
|
||||
// 偶尔会带着别人的 id 请求,直接采信等于开放他人观看历史的读取。管理员同样
|
||||
// 按自己处理,避免出现一条无人使用的越权路径。
|
||||
func embyScopedUserID(c *gin.Context) string {
|
||||
caller := embyEffectiveUserID(c)
|
||||
requested := strings.TrimSpace(c.Param("userId"))
|
||||
if requested == "" {
|
||||
return caller
|
||||
}
|
||||
if requested == caller {
|
||||
return caller
|
||||
}
|
||||
return ""
|
||||
}
|
||||
|
||||
// embyEmptyItemsPayload 与 embyEmptyItemsHandler 保持同一形状。
|
||||
func embyEmptyItemsPayload() gin.H {
|
||||
return gin.H{"Items": []any{}, "TotalRecordCount": 0}
|
||||
}
|
||||
@@ -0,0 +1,372 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"strconv"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"github.com/glebarez/sqlite"
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// newEmbyDiscoveryEnv 搭一个跑在内存库上的 Emby 路由环境。
|
||||
func newEmbyDiscoveryEnv(t *testing.T) (*gin.Engine, *service.Container, string) {
|
||||
t.Helper()
|
||||
gin.SetMode(gin.TestMode)
|
||||
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatalf("open db: %v", err)
|
||||
}
|
||||
if err := db.AutoMigrate(
|
||||
&model.User{}, &model.Library{}, &model.Media{}, &model.PlaybackHistory{},
|
||||
&model.Setting{}, &model.Favorite{}, &model.UserDevice{},
|
||||
); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
cfg := &config.Config{}
|
||||
cfg.Secrets.JWTSecret = "test-secret"
|
||||
|
||||
svc := &service.Container{Repo: repos, Log: zap.NewNop()}
|
||||
svc.Emby = service.NewEmbyService(cfg, zap.NewNop(), repos).
|
||||
SetDiscovery(service.NewMediaDiscoveryService(zap.NewNop(), repos))
|
||||
|
||||
const userID = "user-1"
|
||||
if err := repos.User.Create(context.Background(), &model.User{
|
||||
Base: model.Base{ID: userID}, Username: "tester", PasswordHash: "x",
|
||||
Role: "user", IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
router := gin.New()
|
||||
registerEmbyRoutes(router, cfg.Secrets.JWTSecret, svc)
|
||||
return router, svc, userID
|
||||
}
|
||||
|
||||
func seedEmbyLibrary(t *testing.T, svc *service.Container, typ string) string {
|
||||
t.Helper()
|
||||
lib := &model.Library{Name: "库-" + typ, Path: "/media/" + typ, Type: typ, Enabled: true}
|
||||
if err := svc.Repo.Library.Create(context.Background(), lib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
return lib.ID
|
||||
}
|
||||
|
||||
func embyGet(t *testing.T, router *gin.Engine, path, token string) *httptest.ResponseRecorder {
|
||||
t.Helper()
|
||||
req := httptest.NewRequest(http.MethodGet, path, nil)
|
||||
if token != "" {
|
||||
req.Header.Set("X-Emby-Token", token)
|
||||
}
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
return w
|
||||
}
|
||||
|
||||
func decodeItemsEnvelope(t *testing.T, body []byte) []map[string]any {
|
||||
t.Helper()
|
||||
var payload struct {
|
||||
Items []map[string]any `json:"Items"`
|
||||
TotalRecordCount int64 `json:"TotalRecordCount"`
|
||||
}
|
||||
if err := json.Unmarshal(body, &payload); err != nil {
|
||||
t.Fatalf("decode %s: %v", string(body), err)
|
||||
}
|
||||
return payload.Items
|
||||
}
|
||||
|
||||
// NextUp 必须真的返回下一集,而不是空数组。
|
||||
func TestEmbyNextUpReturnsNextEpisode(t *testing.T) {
|
||||
router, svc, userID := newEmbyDiscoveryEnv(t)
|
||||
libID := seedEmbyLibrary(t, svc, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
for episode, watched := range map[int]bool{1: true, 2: false, 3: false} {
|
||||
m := &model.Media{
|
||||
LibraryID: libID, SeriesID: "series-1", Title: "剧一",
|
||||
SeasonNum: 1, EpisodeNum: episode,
|
||||
Path: "/media/tv/S1E" + string(rune('0'+episode)) + ".mkv",
|
||||
}
|
||||
if err := svc.Repo.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if watched {
|
||||
h := &model.PlaybackHistory{
|
||||
UserID: userID, MediaID: m.ID, PositionMs: 2000, DurationMs: 2000,
|
||||
WatchedAt: watchedAt, Completed: true, // 第 1 集已看完
|
||||
}
|
||||
if err := svc.Repo.DB.Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
w := embyGet(t, router, "/emby/Shows/NextUp", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
items := decodeItemsEnvelope(t, w.Body.Bytes())
|
||||
if len(items) != 1 {
|
||||
t.Fatalf("items = %d, want 1 (body=%s)", len(items), w.Body.String())
|
||||
}
|
||||
if index, ok := items[0]["IndexNumber"].(float64); !ok || int(index) != 2 {
|
||||
t.Fatalf("IndexNumber = %v, want 2 (body=%s)", items[0]["IndexNumber"], w.Body.String())
|
||||
}
|
||||
}
|
||||
|
||||
// 回归:用户在剧集详情页点播放、只看了几秒就退出(历史行 completed=false)后,
|
||||
// Yamby 再次进入详情页带的 NextUp 仍要指向那一集本身,否则「继续播放」会跳到下一集。
|
||||
func TestEmbyNextUpKeepsPartiallyWatchedEpisode(t *testing.T) {
|
||||
router, svc, userID := newEmbyDiscoveryEnv(t)
|
||||
libID := seedEmbyLibrary(t, svc, "tv")
|
||||
|
||||
episodeIDs := map[int]string{}
|
||||
for ep := 1; ep <= 3; ep++ {
|
||||
m := &model.Media{
|
||||
LibraryID: libID, SeriesID: "series-1", Title: "剧一",
|
||||
SeasonNum: 1, EpisodeNum: ep,
|
||||
Path: "/media/tv/S1E" + strconv.Itoa(ep) + ".mkv",
|
||||
}
|
||||
if err := svc.Repo.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
episodeIDs[ep] = m.ID
|
||||
}
|
||||
|
||||
// 第 2 集播放了 3 秒后退出:有进度、未标记看完。
|
||||
if err := svc.Repo.DB.Create(&model.PlaybackHistory{
|
||||
UserID: userID, MediaID: episodeIDs[2], PositionMs: 3582, DurationMs: 1440064,
|
||||
WatchedAt: time.Now(), Completed: false,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
w := embyGet(t, router, "/emby/Shows/NextUp?SeriesId=series-1&Limit=1", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
items := decodeItemsEnvelope(t, w.Body.Bytes())
|
||||
if len(items) != 1 {
|
||||
t.Fatalf("items = %d, want 1 (body=%s)", len(items), w.Body.String())
|
||||
}
|
||||
if id, _ := items[0]["Id"].(string); id != episodeIDs[2] {
|
||||
t.Fatalf("Id = %q, want the partially watched episode %q (body=%s)", id, episodeIDs[2], w.Body.String())
|
||||
}
|
||||
if index, ok := items[0]["IndexNumber"].(float64); !ok || int(index) != 2 {
|
||||
t.Fatalf("IndexNumber = %v, want 2 (body=%s)", items[0]["IndexNumber"], w.Body.String())
|
||||
}
|
||||
}
|
||||
|
||||
// 没有历史时必须返回合法空信封,不能 404/500。
|
||||
func TestEmbyNextUpEmptyWithoutHistory(t *testing.T) {
|
||||
router, _, _ := newEmbyDiscoveryEnv(t)
|
||||
|
||||
w := embyGet(t, router, "/emby/Shows/NextUp", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
if items := decodeItemsEnvelope(t, w.Body.Bytes()); len(items) != 0 {
|
||||
t.Fatalf("items = %d, want 0", len(items))
|
||||
}
|
||||
}
|
||||
|
||||
// 小写别名路由同样要走到真实实现(客户端路径大小写并不统一)。
|
||||
func TestEmbyNextUpLowercaseAlias(t *testing.T) {
|
||||
router, svc, _ := newEmbyDiscoveryEnv(t)
|
||||
_ = seedEmbyLibrary(t, svc, "tv")
|
||||
|
||||
w := embyGet(t, router, "/emby/shows/nextup", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
}
|
||||
|
||||
// Similar 对不存在的条目返回空列表(客户端详情页会无条件请求)。
|
||||
func TestEmbySimilarUnknownItemReturnsEmpty(t *testing.T) {
|
||||
router, _, _ := newEmbyDiscoveryEnv(t)
|
||||
|
||||
w := embyGet(t, router, "/emby/Items/does-not-exist/Similar", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
if items := decodeItemsEnvelope(t, w.Body.Bytes()); len(items) != 0 {
|
||||
t.Fatalf("items = %d, want 0", len(items))
|
||||
}
|
||||
}
|
||||
|
||||
func TestEmbySimilarReturnsCandidates(t *testing.T) {
|
||||
router, svc, _ := newEmbyDiscoveryEnv(t)
|
||||
libID := seedEmbyLibrary(t, svc, "movie")
|
||||
|
||||
source := &model.Media{
|
||||
LibraryID: libID, Title: "源片", Genres: "Action", Year: 2010, Rating: 8,
|
||||
Path: "/media/movie/source.mkv",
|
||||
}
|
||||
if err := svc.Repo.DB.Create(source).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
other := &model.Media{
|
||||
LibraryID: libID, Title: "同类片", Genres: "Action", Year: 2011, Rating: 8,
|
||||
Path: "/media/movie/other.mkv",
|
||||
}
|
||||
if err := svc.Repo.DB.Create(other).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
w := embyGet(t, router, "/emby/Items/"+source.ID+"/Similar", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
items := decodeItemsEnvelope(t, w.Body.Bytes())
|
||||
if len(items) != 1 {
|
||||
t.Fatalf("items = %d, want 1 (body=%s)", len(items), w.Body.String())
|
||||
}
|
||||
if name, _ := items[0]["Name"].(string); name != "同类片" {
|
||||
t.Fatalf("Name = %q, want 同类片", name)
|
||||
}
|
||||
}
|
||||
|
||||
// Genres 必须返回真实类型与计数。
|
||||
func TestEmbyGenresReturnsCounts(t *testing.T) {
|
||||
router, svc, _ := newEmbyDiscoveryEnv(t)
|
||||
libID := seedEmbyLibrary(t, svc, "movie")
|
||||
|
||||
for i, genres := range []string{"Action,Drama", "Action"} {
|
||||
m := &model.Media{
|
||||
LibraryID: libID, Title: "片" + string(rune('A'+i)), Genres: genres,
|
||||
Path: "/media/movie/m" + string(rune('0'+i)) + ".mkv",
|
||||
}
|
||||
if err := svc.Repo.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
w := embyGet(t, router, "/emby/Genres", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
items := decodeItemsEnvelope(t, w.Body.Bytes())
|
||||
if len(items) != 2 {
|
||||
t.Fatalf("items = %d, want 2 (body=%s)", len(items), w.Body.String())
|
||||
}
|
||||
// 排序按计数降序:Action(2) 在前。
|
||||
if name, _ := items[0]["Name"].(string); name != "Action" {
|
||||
t.Fatalf("first Name = %q, want Action", name)
|
||||
}
|
||||
if count, ok := items[0]["ItemCount"].(float64); !ok || int(count) != 2 {
|
||||
t.Fatalf("ItemCount = %v, want 2", items[0]["ItemCount"])
|
||||
}
|
||||
if id, _ := items[0]["Id"].(string); len(id) == 0 {
|
||||
t.Fatal("genre item must carry a stable Id")
|
||||
}
|
||||
}
|
||||
|
||||
// 按别人的 userId 请求 NextUp 不允许泄露他人历史。
|
||||
func TestEmbyNextUpRejectsForeignUserID(t *testing.T) {
|
||||
router, _, _ := newEmbyDiscoveryEnv(t)
|
||||
|
||||
w := embyGet(t, router, "/emby/Users/someone-else/Shows/NextUp", signedTestToken(t, "test-secret"))
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
if items := decodeItemsEnvelope(t, w.Body.Bytes()); len(items) != 0 {
|
||||
t.Fatalf("items = %d, want 0", len(items))
|
||||
}
|
||||
}
|
||||
|
||||
// YamBy 等客户端进入剧集详情会带 SeriesId 调 NextUp;必须只返回该剧的下一集,
|
||||
// 不能回落成全站「继续观看」第一条,否则详情页播放会串到别的片子。
|
||||
func TestEmbyNextUpFiltersBySeriesID(t *testing.T) {
|
||||
router, svc, userID := newEmbyDiscoveryEnv(t)
|
||||
libID := seedEmbyLibrary(t, svc, "tv")
|
||||
recent := time.Now().Add(-time.Minute)
|
||||
older := time.Now().Add(-2 * time.Hour)
|
||||
|
||||
seedSeries := func(seriesID, title string, watchedAt time.Time) (watchedID, nextID string) {
|
||||
t.Helper()
|
||||
for ep := 1; ep <= 3; ep++ {
|
||||
m := &model.Media{
|
||||
LibraryID: libID, SeriesID: seriesID, Title: title,
|
||||
SeasonNum: 1, EpisodeNum: ep,
|
||||
Path: "/media/tv/" + seriesID + "/S1E" + strconv.Itoa(ep) + ".mkv",
|
||||
}
|
||||
if err := svc.Repo.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
switch ep {
|
||||
case 1:
|
||||
watchedID = m.ID
|
||||
h := &model.PlaybackHistory{
|
||||
UserID: userID, MediaID: m.ID, PositionMs: 2000, DurationMs: 2000,
|
||||
WatchedAt: watchedAt, Completed: true, // 第 1 集已看完,下一集是 S1E2
|
||||
}
|
||||
if err := svc.Repo.DB.Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
case 2:
|
||||
nextID = m.ID
|
||||
}
|
||||
}
|
||||
return watchedID, nextID
|
||||
}
|
||||
|
||||
_, _ = seedSeries("series-hot", "热门剧", recent)
|
||||
_, wantNext := seedSeries("series-cold", "目标剧", older)
|
||||
|
||||
token := signedTestToken(t, "test-secret")
|
||||
global := embyGet(t, router, "/emby/Shows/NextUp?Limit=10", token)
|
||||
if global.Code != http.StatusOK {
|
||||
t.Fatalf("global status = %d body=%s", global.Code, global.Body.String())
|
||||
}
|
||||
if items := decodeItemsEnvelope(t, global.Body.Bytes()); len(items) < 2 {
|
||||
t.Fatalf("global items = %d, want >= 2 (body=%s)", len(items), global.Body.String())
|
||||
}
|
||||
|
||||
scoped := embyGet(t, router, "/emby/Shows/NextUp?SeriesId=series-cold&Limit=10", token)
|
||||
if scoped.Code != http.StatusOK {
|
||||
t.Fatalf("scoped status = %d body=%s", scoped.Code, scoped.Body.String())
|
||||
}
|
||||
items := decodeItemsEnvelope(t, scoped.Body.Bytes())
|
||||
if len(items) != 1 {
|
||||
t.Fatalf("scoped items = %d, want 1 (body=%s)", len(items), scoped.Body.String())
|
||||
}
|
||||
if id, _ := items[0]["Id"].(string); id != wantNext {
|
||||
t.Fatalf("scoped Id = %q, want %q (body=%s)", id, wantNext, scoped.Body.String())
|
||||
}
|
||||
if seriesID, _ := items[0]["SeriesId"].(string); seriesID != "series-cold" {
|
||||
t.Fatalf("scoped SeriesId = %q, want series-cold", seriesID)
|
||||
}
|
||||
|
||||
empty := embyGet(t, router, "/emby/Shows/NextUp?SeriesId=series-never-watched", token)
|
||||
if empty.Code != http.StatusOK {
|
||||
t.Fatalf("empty status = %d body=%s", empty.Code, empty.Body.String())
|
||||
}
|
||||
if items := decodeItemsEnvelope(t, empty.Body.Bytes()); len(items) != 0 {
|
||||
t.Fatalf("never-watched items = %d, want 0 (body=%s)", len(items), empty.Body.String())
|
||||
}
|
||||
|
||||
pathScoped := embyGet(t, router, "/emby/Shows/series-cold/NextUp?Limit=10", token)
|
||||
if pathScoped.Code != http.StatusOK {
|
||||
t.Fatalf("path scoped status = %d body=%s", pathScoped.Code, pathScoped.Body.String())
|
||||
}
|
||||
pathItems := decodeItemsEnvelope(t, pathScoped.Body.Bytes())
|
||||
if len(pathItems) != 1 {
|
||||
t.Fatalf("path scoped items = %d, want 1 (body=%s)", len(pathItems), pathScoped.Body.String())
|
||||
}
|
||||
if id, _ := pathItems[0]["Id"].(string); id != wantNext {
|
||||
t.Fatalf("path scoped Id = %q, want %q", id, wantNext)
|
||||
}
|
||||
}
|
||||
@@ -132,7 +132,10 @@ func embyResumeItemsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
uid := embyEffectiveUserID(c)
|
||||
limit, _ := strconv.Atoi(embyFirstNonEmptyString(firstQueryValue(c, "Limit", "limit"), "20"))
|
||||
out, err := svc.Emby.ResumeItems(c.Request.Context(), uid, limit)
|
||||
startIndex, _ := strconv.Atoi(embyFirstNonEmptyString(firstQueryValue(c, "StartIndex", "startIndex", "startindex"), "0"))
|
||||
// ParentId / SeriesId 收窄到当前库或当前剧,避免详情页继续播放串到全站历史。
|
||||
parentID := firstQueryValue(c, "ParentId", "parentId", "parentid", "SeriesId", "seriesId", "seriesid")
|
||||
out, err := svc.Emby.ResumeItems(c.Request.Context(), uid, parentID, limit, startIndex)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
|
||||
@@ -0,0 +1,151 @@
|
||||
// Package handler — Emby / Jellyfin 媒体分段(片头、片尾)兼容接口。
|
||||
//
|
||||
// GET /MediaSegments/{itemId}
|
||||
// GET /Items/{itemId}/MediaSegments
|
||||
// GET /Users/{userId}/Items/{itemId}/MediaSegments
|
||||
//
|
||||
// 契约对齐 Jellyfin 10.10 引入的 Media Segments API(Emby 采用同一形状),
|
||||
// 也是 TheIntroDB 官方 Jellyfin 插件走的同一条路:
|
||||
//
|
||||
// QueryResult<MediaSegmentDto> = {"Items": [...], "TotalRecordCount": N}
|
||||
// MediaSegmentDto = {"Id", "ItemId", "Type", "StartTicks", "EndTicks"}
|
||||
//
|
||||
// 时间是 .NET ticks(1 tick = 100ns,即每秒 10,000,000、每毫秒 10,000);
|
||||
// Type 是枚举名字符串 Intro / Outro / Recap / Preview / Commercial。
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"net/http"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// 第三方客户端会在起播前后同步请求分段,不能被一次外网抓取无限拖住。超时后
|
||||
// 退回已有缓存(可能为空),请求本身永远不失败。
|
||||
const embyMediaSegmentsFetchBudget = 5 * time.Second
|
||||
|
||||
// 1 秒 = 10,000,000 ticks => 1 毫秒 = 10,000 ticks。
|
||||
const embyTicksPerMillisecond int64 = 10_000
|
||||
|
||||
func embyMediaSegmentsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
// 未知条目、虚拟剧集/季、远程 Emby 挂载、以及当前不可见的内容一律返回
|
||||
// 空结果而不是 404:客户端会把 404 判成「条目损坏」(同 emby_routes.go
|
||||
// 里 AdditionalParts 的说明),而「没有可跳过的片段」本来就是个合法状态。
|
||||
empty := gin.H{"Items": []any{}, "TotalRecordCount": 0}
|
||||
if svc == nil || svc.Repo == nil || svc.Segments == nil {
|
||||
c.JSON(http.StatusOK, empty)
|
||||
return
|
||||
}
|
||||
id := c.Param("id")
|
||||
// 远程 Emby 挂载的条目是上游库的投影,本地没有可查询的外部 ID 关联。
|
||||
if service.IsEmbyRemoteID(id) {
|
||||
c.JSON(http.StatusOK, empty)
|
||||
return
|
||||
}
|
||||
m, err := svc.Repo.Media.FindByID(c.Request.Context(), id)
|
||||
if err != nil || m == nil || !mediaVisibleForRequest(c, svc, m) {
|
||||
c.JSON(http.StatusOK, empty)
|
||||
return
|
||||
}
|
||||
|
||||
ctx, cancel := context.WithTimeout(c.Request.Context(), embyMediaSegmentsFetchBudget)
|
||||
defer cancel()
|
||||
rows, listErr := svc.Segments.ListForPlayback(ctx, m)
|
||||
if listErr != nil && svc.Log != nil {
|
||||
svc.Log.Debug("emby media segments lookup failed",
|
||||
zap.String("media_id", m.ID), zap.Error(listErr))
|
||||
}
|
||||
|
||||
items := embySegmentItems(m, rows, embyRequestedSegmentTypes(c))
|
||||
c.JSON(http.StatusOK, gin.H{"Items": items, "TotalRecordCount": len(items)})
|
||||
}
|
||||
}
|
||||
|
||||
// embySegmentItems 把库内片段转换成 MediaSegmentDto 列表。
|
||||
func embySegmentItems(m *model.Media, rows []model.MediaSegment, want map[string]bool) []gin.H {
|
||||
// 末段在库内用 end_ms = 0 表示「一直到片尾」(TheIntroDB 对片尾返回 end_ms: null),
|
||||
// 这里必须换算成真实结束时间;拿不到时长就丢弃该分段,否则会给出一个零长度区间,
|
||||
// 客户端要么忽略要么画出一个错误的跳转点。
|
||||
durationMs := int64(m.DurationSec) * 1000
|
||||
items := make([]gin.H, 0, len(rows))
|
||||
for _, row := range rows {
|
||||
typeName := embySegmentTypeName(row.Kind)
|
||||
if typeName == "" {
|
||||
continue
|
||||
}
|
||||
if len(want) > 0 && !want[typeName] {
|
||||
continue
|
||||
}
|
||||
endMs := row.EndMs
|
||||
if endMs <= 0 {
|
||||
if durationMs <= 0 {
|
||||
continue
|
||||
}
|
||||
endMs = durationMs
|
||||
}
|
||||
if endMs <= row.StartMs {
|
||||
continue
|
||||
}
|
||||
items = append(items, gin.H{
|
||||
"Id": row.ID,
|
||||
"ItemId": m.ID,
|
||||
"Type": typeName,
|
||||
"StartTicks": row.StartMs * embyTicksPerMillisecond,
|
||||
"EndTicks": endMs * embyTicksPerMillisecond,
|
||||
})
|
||||
}
|
||||
return items
|
||||
}
|
||||
|
||||
// embySegmentTypeName 把库内 kind 映射成 Emby/Jellyfin 的 MediaSegmentType 名字。
|
||||
// 库内的 credits 取自 TheIntroDB 的字段名,在 Emby 一侧对应 Outro。
|
||||
func embySegmentTypeName(kind string) string {
|
||||
switch kind {
|
||||
case model.SegmentKindIntro:
|
||||
return "Intro"
|
||||
case model.SegmentKindRecap:
|
||||
return "Recap"
|
||||
case model.SegmentKindCredits:
|
||||
return "Outro"
|
||||
case model.SegmentKindPreview:
|
||||
return "Preview"
|
||||
default:
|
||||
return ""
|
||||
}
|
||||
}
|
||||
|
||||
// embyRequestedSegmentTypes 解析 includeSegmentTypes(Jellyfin 的过滤参数)。
|
||||
// 支持重复参数与逗号分隔两种写法;返回空集合表示不过滤。
|
||||
//
|
||||
// 只认枚举名字符串。数字枚举虽然 ASP.NET 模型绑定也接受,但各家定义的顺序并
|
||||
// 不一致,猜错会把过滤结果算错;认不出来时按「不过滤」处理,返回的是超集,
|
||||
// 客户端自己仍会再过滤一次。
|
||||
func embyRequestedSegmentTypes(c *gin.Context) map[string]bool {
|
||||
raw := make([]string, 0, 4)
|
||||
for _, key := range []string{"includeSegmentTypes", "IncludeSegmentTypes", "includesegmenttypes"} {
|
||||
raw = append(raw, c.QueryArray(key)...)
|
||||
}
|
||||
want := make(map[string]bool, len(raw))
|
||||
for _, value := range raw {
|
||||
for _, part := range strings.Split(value, ",") {
|
||||
part = strings.TrimSpace(part)
|
||||
if part == "" {
|
||||
continue
|
||||
}
|
||||
for _, name := range []string{"Intro", "Outro", "Recap", "Preview", "Commercial"} {
|
||||
if strings.EqualFold(part, name) {
|
||||
want[name] = true
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
return want
|
||||
}
|
||||
@@ -0,0 +1,217 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"sync/atomic"
|
||||
"testing"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"github.com/glebarez/sqlite"
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
type embySegmentsPayload struct {
|
||||
Items []struct {
|
||||
ID string `json:"Id"`
|
||||
ItemID string `json:"ItemId"`
|
||||
Type string `json:"Type"`
|
||||
StartTicks int64 `json:"StartTicks"`
|
||||
EndTicks int64 `json:"EndTicks"`
|
||||
} `json:"Items"`
|
||||
TotalRecordCount int `json:"TotalRecordCount"`
|
||||
}
|
||||
|
||||
// 电影:intro 有明确结束点;credits 的 end_ms 为 null(库内落成 0),
|
||||
// 必须用媒体时长补齐 —— 这是最容易写错的一处。
|
||||
const embySegmentsProviderBody = `{"tmdb_id":27205,"type":"movie","intro":[{"start_ms":null,"end_ms":38000}],"credits":[{"start_ms":6480000,"end_ms":null}]}`
|
||||
|
||||
const (
|
||||
embySegmentsMovieDurationSec = 8880
|
||||
embySegmentsTicksPerSecond = 10_000_000
|
||||
)
|
||||
|
||||
func newEmbySegmentsTestRouter(t *testing.T, durationSec int) (*gin.Engine, string, *int32) {
|
||||
t.Helper()
|
||||
gin.SetMode(gin.TestMode)
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := db.AutoMigrate(model.AllModels()...); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
if err := repos.User.Create(t.Context(), &model.User{
|
||||
Base: model.Base{ID: "user-1"},
|
||||
Username: "tester",
|
||||
PasswordHash: "x",
|
||||
Role: "admin",
|
||||
Tier: "plus",
|
||||
IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
lib := model.Library{Base: model.Base{ID: "lib-movies"}, Name: "电影", Path: "D:\\media\\movies", Type: "movie", Enabled: true}
|
||||
if err := repos.Library.Create(t.Context(), &lib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := db.Create(&model.Media{
|
||||
Base: model.Base{ID: "movie-1"},
|
||||
LibraryID: lib.ID,
|
||||
Title: "Inception",
|
||||
Path: "D:\\media\\movies\\Inception.mkv",
|
||||
DurationSec: durationSec,
|
||||
TMDbID: 27205,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
var calls int32
|
||||
provider := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
atomic.AddInt32(&calls, 1)
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(embySegmentsProviderBody))
|
||||
}))
|
||||
t.Cleanup(provider.Close)
|
||||
|
||||
segments := service.NewMediaSegmentService(zap.NewNop(), repos).
|
||||
SetIntroDB(service.NewIntroDBService(zap.NewNop()).SetBaseURL(provider.URL))
|
||||
|
||||
const secret = "test-secret"
|
||||
router := gin.New()
|
||||
registerEmbyRoutes(router, secret, &service.Container{
|
||||
Repo: repos,
|
||||
Emby: service.NewEmbyService(&config.Config{}, zap.NewNop(), repos),
|
||||
Segments: segments,
|
||||
Log: zap.NewNop(),
|
||||
})
|
||||
return router, secret, &calls
|
||||
}
|
||||
|
||||
func embySegmentsRequest(t *testing.T, router *gin.Engine, secret, path string) embySegmentsPayload {
|
||||
t.Helper()
|
||||
req := httptest.NewRequest(http.MethodGet, path, nil)
|
||||
req.Header.Set("X-Emby-Token", signedTestToken(t, secret))
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("%s status = %d body=%s", path, w.Code, w.Body.String())
|
||||
}
|
||||
var payload embySegmentsPayload
|
||||
if err := json.Unmarshal(w.Body.Bytes(), &payload); err != nil {
|
||||
t.Fatalf("%s decode: %v", path, err)
|
||||
}
|
||||
return payload
|
||||
}
|
||||
|
||||
func TestEmbyMediaSegmentsReturnsTicksAndMapsCreditsToOutro(t *testing.T) {
|
||||
router, secret, _ := newEmbySegmentsTestRouter(t, embySegmentsMovieDurationSec)
|
||||
|
||||
payload := embySegmentsRequest(t, router, secret, "/MediaSegments/movie-1")
|
||||
if payload.TotalRecordCount != 2 || len(payload.Items) != 2 {
|
||||
t.Fatalf("segments = %#v (total %d), want 2", payload.Items, payload.TotalRecordCount)
|
||||
}
|
||||
|
||||
intro := payload.Items[0]
|
||||
if intro.Type != "Intro" || intro.ItemID != "movie-1" || intro.ID == "" {
|
||||
t.Fatalf("intro segment = %#v", intro)
|
||||
}
|
||||
// start_ms null 表示从片头开始。
|
||||
if intro.StartTicks != 0 || intro.EndTicks != 38*embySegmentsTicksPerSecond {
|
||||
t.Fatalf("intro ticks = %d..%d, want 0..%d",
|
||||
intro.StartTicks, intro.EndTicks, 38*embySegmentsTicksPerSecond)
|
||||
}
|
||||
|
||||
// 库内 credits 在 Emby 一侧是 Outro;end_ms = 0 必须按媒体时长补齐,
|
||||
// 否则客户端会拿到一个零长度区间。
|
||||
outro := payload.Items[1]
|
||||
if outro.Type != "Outro" {
|
||||
t.Fatalf("credits should map to Outro, got %q", outro.Type)
|
||||
}
|
||||
if outro.StartTicks != 6480*embySegmentsTicksPerSecond {
|
||||
t.Fatalf("outro StartTicks = %d, want %d", outro.StartTicks, 6480*embySegmentsTicksPerSecond)
|
||||
}
|
||||
if outro.EndTicks != embySegmentsMovieDurationSec*embySegmentsTicksPerSecond {
|
||||
t.Fatalf("outro EndTicks = %d, want the media duration %d",
|
||||
outro.EndTicks, embySegmentsMovieDurationSec*embySegmentsTicksPerSecond)
|
||||
}
|
||||
}
|
||||
|
||||
func TestEmbyMediaSegmentsIsServedFromTheSameCacheAsTheWebPlayer(t *testing.T) {
|
||||
router, secret, calls := newEmbySegmentsTestRouter(t, embySegmentsMovieDurationSec)
|
||||
|
||||
// 多条路径 + 大小写变体都应命中同一份缓存,而不是各自再打一次外网。
|
||||
for _, path := range []string{
|
||||
"/MediaSegments/movie-1",
|
||||
"/mediasegments/movie-1",
|
||||
"/Items/movie-1/MediaSegments",
|
||||
"/items/movie-1/mediasegments",
|
||||
"/Users/user-1/Items/movie-1/MediaSegments",
|
||||
} {
|
||||
payload := embySegmentsRequest(t, router, secret, path)
|
||||
if len(payload.Items) != 2 {
|
||||
t.Fatalf("%s returned %#v, want 2 segments", path, payload.Items)
|
||||
}
|
||||
}
|
||||
if got := atomic.LoadInt32(calls); got != 1 {
|
||||
t.Fatalf("provider calls = %d, want 1 (all routes share the cached rows)", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestEmbyMediaSegmentsHonoursIncludeSegmentTypes(t *testing.T) {
|
||||
router, secret, _ := newEmbySegmentsTestRouter(t, embySegmentsMovieDurationSec)
|
||||
|
||||
payload := embySegmentsRequest(t, router, secret, "/MediaSegments/movie-1?includeSegmentTypes=Intro")
|
||||
if payload.TotalRecordCount != 1 || len(payload.Items) != 1 {
|
||||
t.Fatalf("filtered segments = %#v (total %d), want only Intro", payload.Items, payload.TotalRecordCount)
|
||||
}
|
||||
if payload.Items[0].Type != "Intro" {
|
||||
t.Fatalf("filtered type = %q, want Intro", payload.Items[0].Type)
|
||||
}
|
||||
|
||||
// 认不出的枚举名按「不过滤」处理:返回超集比返回空集安全。
|
||||
payload = embySegmentsRequest(t, router, secret, "/MediaSegments/movie-1?includeSegmentTypes=NotAType")
|
||||
if payload.TotalRecordCount != 2 {
|
||||
t.Fatalf("unknown filter returned %d segments, want the unfiltered set", payload.TotalRecordCount)
|
||||
}
|
||||
}
|
||||
|
||||
func TestEmbyMediaSegmentsDropsOpenEndedRangeWhenDurationUnknown(t *testing.T) {
|
||||
// 时长未知(STRM/云盘媒体探测前)时,credits 无法换算成真实结束点,
|
||||
// 只能丢弃;有明确结束点的 intro 必须保留。
|
||||
router, secret, _ := newEmbySegmentsTestRouter(t, 0)
|
||||
|
||||
payload := embySegmentsRequest(t, router, secret, "/MediaSegments/movie-1")
|
||||
if payload.TotalRecordCount != 1 || len(payload.Items) != 1 {
|
||||
t.Fatalf("segments = %#v (total %d), want only the intro", payload.Items, payload.TotalRecordCount)
|
||||
}
|
||||
if payload.Items[0].Type != "Intro" {
|
||||
t.Fatalf("kept segment = %#v, want Intro", payload.Items[0])
|
||||
}
|
||||
}
|
||||
|
||||
func TestEmbyMediaSegmentsReturnsEmptyInsteadOfNotFound(t *testing.T) {
|
||||
router, secret, calls := newEmbySegmentsTestRouter(t, embySegmentsMovieDurationSec)
|
||||
|
||||
// 未知条目必须 200 + 空数组:客户端会把 404 判成「条目损坏」。
|
||||
payload := embySegmentsRequest(t, router, secret, "/MediaSegments/does-not-exist")
|
||||
if payload.Items == nil || len(payload.Items) != 0 || payload.TotalRecordCount != 0 {
|
||||
t.Fatalf("unknown item payload = %#v", payload)
|
||||
}
|
||||
// 远程 Emby 条目同理(本地没有可查询的外部 ID 关联)。
|
||||
payload = embySegmentsRequest(t, router, secret, "/MediaSegments/embyremote~acct1~item1")
|
||||
if len(payload.Items) != 0 {
|
||||
t.Fatalf("remote emby item payload = %#v, want empty", payload.Items)
|
||||
}
|
||||
if got := atomic.LoadInt32(calls); got != 0 {
|
||||
t.Fatalf("provider calls = %d, want 0 for unresolvable items", got)
|
||||
}
|
||||
}
|
||||
@@ -1,10 +1,13 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"net/http"
|
||||
"net/url"
|
||||
"strings"
|
||||
"sync"
|
||||
"time"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
|
||||
@@ -24,10 +27,98 @@ func embyPlaybackInfoHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return
|
||||
}
|
||||
embyAttachRequestTokenToMediaSources(c, out)
|
||||
// 在后台把本次条目的云盘直链换好:播放器拿到 PlaybackInfo 后通常还要
|
||||
// 1–2 秒才请求 /Videos/{id}/stream,把换链开销落在这段等待里。
|
||||
embyPrewarmPlaybackTargets(svc, c, out)
|
||||
c.JSON(http.StatusOK, out)
|
||||
}
|
||||
}
|
||||
|
||||
// embyPrewarmTimeout 是单次预热的等待上限。115 开放平台在跨太平洋线路上单次
|
||||
// 换链实测 0.4–1.1s,这里给足余量;超时只是没预热成功,不影响后续播放。
|
||||
const embyPrewarmTimeout = 10 * time.Second
|
||||
|
||||
// embyPrewarmInFlight 去重同一个条目的并发预热(首页刷新会并发请求多个接口,
|
||||
// 同一条目可能在短时间内被多次请求)。
|
||||
var embyPrewarmInFlight sync.Map
|
||||
|
||||
// embyPrewarmSlots 限制同时进行的预热数量。客户端可能批量预取 PlaybackInfo
|
||||
// (逐个剧集的预取请求),预热只是优化,不能反过来把 115 换链接口打出突发。
|
||||
// 名额满时直接跳过:排队等待的预热往往等真正播放时已经没意义了。
|
||||
var embyPrewarmSlots = make(chan struct{}, 4)
|
||||
|
||||
// embyPrewarmPlaybackTargets 在后台预热本次 PlaybackInfo 涉及条目的云盘直链。
|
||||
//
|
||||
// 起播链路里最贵的一步是「服务端拿 pickcode 去 115 开放平台换直链」:服务器在
|
||||
// 洛杉矶、115 接口在国内,冷启动实测 0.4–1.1s;之后 45 分钟内命中进程内缓存。
|
||||
// 播放器在 PlaybackInfo 与真正拉流之间有几秒间隔,这里把换链放到那段间隔里,
|
||||
// 起播时就只剩纯网络耗时。
|
||||
//
|
||||
// 只处理云盘/strm 条目,且失败一律静默忽略:预热是尽力而为的优化,不能影响
|
||||
// PlaybackInfo 的正常返回。
|
||||
func embyPrewarmPlaybackTargets(svc *service.Container, c *gin.Context, out map[string]any) {
|
||||
if svc == nil || svc.Strm == nil || svc.Repo == nil || svc.Repo.Media == nil || out == nil {
|
||||
return
|
||||
}
|
||||
ids := embyPrewarmMediaIDs(out)
|
||||
if len(ids) == 0 {
|
||||
return
|
||||
}
|
||||
userAgent := c.GetHeader("User-Agent")
|
||||
// 预热是给「后续请求」用的:即便本次 PlaybackInfo 的连接断开,
|
||||
// 也要把换链跑完。
|
||||
base := context.WithoutCancel(c.Request.Context())
|
||||
for _, mediaID := range ids {
|
||||
if _, loaded := embyPrewarmInFlight.LoadOrStore(mediaID, struct{}{}); loaded {
|
||||
continue
|
||||
}
|
||||
go func(id string) {
|
||||
defer embyPrewarmInFlight.Delete(id)
|
||||
select {
|
||||
case embyPrewarmSlots <- struct{}{}:
|
||||
defer func() { <-embyPrewarmSlots }()
|
||||
default:
|
||||
return
|
||||
}
|
||||
ctx, cancel := context.WithTimeout(base, embyPrewarmTimeout)
|
||||
defer cancel()
|
||||
m, err := svc.Repo.Media.FindByID(ctx, id)
|
||||
if err != nil || m == nil {
|
||||
return
|
||||
}
|
||||
raw := strings.TrimSpace(m.STRMURL)
|
||||
if raw == "" || !service.IsStrmMediaRow(m) {
|
||||
return
|
||||
}
|
||||
// 解析结果由 strm 层按 pickcode+UA 缓存;已缓存时这里是空转。
|
||||
_, _ = svc.Strm.ResolvePlayTargetWithUA(ctx, raw, userAgent)
|
||||
}(mediaID)
|
||||
}
|
||||
}
|
||||
|
||||
// embyPrewarmMediaIDs 取出 PlaybackInfo 载荷里 MediaSources 的条目 ID。
|
||||
func embyPrewarmMediaIDs(out map[string]any) []string {
|
||||
sources, ok := out["MediaSources"].([]map[string]any)
|
||||
if !ok || len(sources) == 0 {
|
||||
return nil
|
||||
}
|
||||
ids := make([]string, 0, len(sources))
|
||||
seen := make(map[string]struct{}, len(sources))
|
||||
for _, src := range sources {
|
||||
id, _ := src["Id"].(string)
|
||||
id = strings.TrimSpace(id)
|
||||
if id == "" {
|
||||
continue
|
||||
}
|
||||
if _, dup := seen[id]; dup {
|
||||
continue
|
||||
}
|
||||
seen[id] = struct{}{}
|
||||
ids = append(ids, id)
|
||||
}
|
||||
return ids
|
||||
}
|
||||
|
||||
// embySubtitleStreamHandler serves an external subtitle track advertised in a
|
||||
// MediaSource's MediaStreams via its Emby index
|
||||
// (/Videos/:id/Subtitles/:index/Stream). The index maps to a discovered
|
||||
|
||||
@@ -0,0 +1,159 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"github.com/glebarez/sqlite"
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
func newPrewarmTestContainer(t *testing.T) *service.Container {
|
||||
t.Helper()
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatalf("open db: %v", err)
|
||||
}
|
||||
if err := db.AutoMigrate(&model.Media{}, &model.Setting{}, &model.StrmAccount{}); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
if sqlDB, err := db.DB(); err == nil {
|
||||
// 内存库 + 后台预热协程:限制单连接,避免新连接拿到空白的 :memory:。
|
||||
sqlDB.SetMaxOpenConns(1)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
return &service.Container{
|
||||
Log: zap.NewNop(),
|
||||
Repo: repos,
|
||||
Strm: service.NewStrmService(&config.Config{}, zap.NewNop(), repos, nil),
|
||||
}
|
||||
}
|
||||
|
||||
func newPrewarmTestContext() *gin.Context {
|
||||
gin.SetMode(gin.TestMode)
|
||||
c, _ := gin.CreateTestContext(httptest.NewRecorder())
|
||||
c.Request = httptest.NewRequest(http.MethodPost, "/emby/Items/media-1/PlaybackInfo", nil)
|
||||
c.Request.Header.Set("User-Agent", "RodelPlayer/2.2607.7.0")
|
||||
return c
|
||||
}
|
||||
|
||||
func TestEmbyPrewarmMediaIDsExtractsDeduplicates(t *testing.T) {
|
||||
out := map[string]any{
|
||||
"MediaSources": []map[string]any{
|
||||
{"Id": "src-1"},
|
||||
{"Id": " src-1 "},
|
||||
{"Id": "src-2"},
|
||||
{"Id": ""},
|
||||
{"Name": "no id"},
|
||||
},
|
||||
}
|
||||
got := embyPrewarmMediaIDs(out)
|
||||
if len(got) != 2 || got[0] != "src-1" || got[1] != "src-2" {
|
||||
t.Fatalf("ids = %v, want [src-1 src-2]", got)
|
||||
}
|
||||
if got := embyPrewarmMediaIDs(map[string]any{}); len(got) != 0 {
|
||||
t.Fatalf("missing MediaSources should yield no ids, got %v", got)
|
||||
}
|
||||
if got := embyPrewarmMediaIDs(map[string]any{"MediaSources": []any{}}); len(got) != 0 {
|
||||
t.Fatalf("foreign payload shape should yield no ids, got %v", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 预热是异步的:调用必须立即返回,并且协程结束后不能残留去重标记。
|
||||
func TestEmbyPrewarmPlaybackTargetsRunsAsyncAndCleansUp(t *testing.T) {
|
||||
svc := newPrewarmTestContainer(t)
|
||||
if err := svc.Repo.DB.Create(&model.Media{
|
||||
Base: model.Base{ID: "media-1"},
|
||||
Title: "Cloud",
|
||||
Path: "cloud://cloud115/Movie.mkv",
|
||||
Container: "strm",
|
||||
STRMURL: "/api/strm/play/cloud115/video.mkv?acct=missing&pickcode=pc1",
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
embyPrewarmInFlight.Delete("media-1")
|
||||
out := map[string]any{"MediaSources": []map[string]any{{"Id": "media-1"}}}
|
||||
|
||||
done := make(chan struct{})
|
||||
go func() {
|
||||
embyPrewarmPlaybackTargets(svc, newPrewarmTestContext(), out)
|
||||
close(done)
|
||||
}()
|
||||
select {
|
||||
case <-done:
|
||||
case <-time.After(2 * time.Second):
|
||||
t.Fatal("embyPrewarmPlaybackTargets blocked the caller")
|
||||
}
|
||||
|
||||
// 后台协程应很快跑完并释放去重标记,否则同一条目后续再也预热不了。
|
||||
deadline := time.Now().Add(3 * time.Second)
|
||||
for time.Now().Before(deadline) {
|
||||
if _, busy := embyPrewarmInFlight.Load("media-1"); !busy {
|
||||
return
|
||||
}
|
||||
time.Sleep(10 * time.Millisecond)
|
||||
}
|
||||
t.Fatal("prewarm in-flight marker leaked")
|
||||
}
|
||||
|
||||
// 各种缺数据的情况都不允许 panic 或阻塞:预热只是尽力而为的优化。
|
||||
func TestEmbyPrewarmPlaybackTargetsIsNilSafe(t *testing.T) {
|
||||
svc := newPrewarmTestContainer(t)
|
||||
c := newPrewarmTestContext()
|
||||
out := map[string]any{"MediaSources": []map[string]any{{"Id": "media-1"}}}
|
||||
|
||||
cases := []struct {
|
||||
name string
|
||||
svc *service.Container
|
||||
out map[string]any
|
||||
}{
|
||||
{name: "空容器", svc: &service.Container{}, out: out},
|
||||
{name: "无 Strm", svc: &service.Container{Repo: svc.Repo}, out: out},
|
||||
{name: "无 Repo", svc: &service.Container{Strm: svc.Strm}, out: out},
|
||||
{name: "nil 载荷", svc: svc, out: nil},
|
||||
{name: "无 MediaSources", svc: svc, out: map[string]any{}},
|
||||
{name: "条目不存在", svc: svc, out: out},
|
||||
}
|
||||
for _, tc := range cases {
|
||||
t.Run(tc.name, func(t *testing.T) {
|
||||
embyPrewarmPlaybackTargets(tc.svc, c, tc.out)
|
||||
})
|
||||
}
|
||||
}
|
||||
|
||||
// 本地文件条目不该触发换链预热(没有云盘直链可预热)。
|
||||
func TestEmbyPrewarmSkipsLocalMedia(t *testing.T) {
|
||||
svc := newPrewarmTestContainer(t)
|
||||
if err := svc.Repo.DB.Create(&model.Media{
|
||||
Base: model.Base{ID: "local-1"},
|
||||
Title: "Local",
|
||||
Path: "/media/movies/Local.mkv",
|
||||
LibraryID: "lib-1",
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
embyPrewarmInFlight.Delete("local-1")
|
||||
embyPrewarmPlaybackTargets(svc, newPrewarmTestContext(),
|
||||
map[string]any{"MediaSources": []map[string]any{{"Id": "local-1"}}})
|
||||
|
||||
// 协程要么已经跑完(标记被清掉),要么根本没起;两种都不该留下标记。
|
||||
deadline := time.Now().Add(2 * time.Second)
|
||||
for time.Now().Before(deadline) {
|
||||
if _, busy := embyPrewarmInFlight.Load("local-1"); !busy {
|
||||
return
|
||||
}
|
||||
time.Sleep(10 * time.Millisecond)
|
||||
}
|
||||
t.Fatal("local media must not leave a prewarm marker")
|
||||
}
|
||||
@@ -196,15 +196,20 @@ func registerEmbyAuthenticatedItemRoutes(auth *gin.RouterGroup, svc *service.Con
|
||||
auth.GET("/Shows/:id/Episodes", embyShowEpisodesHandler(svc))
|
||||
auth.GET("/Users/:userId/Shows/:id/Seasons", embyShowSeasonsHandler(svc))
|
||||
auth.GET("/Users/:userId/Shows/:id/Episodes", embyShowEpisodesHandler(svc))
|
||||
auth.GET("/Shows/NextUp", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Users/:userId/Shows/NextUp", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/MediaSegments/:id", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Shows/NextUp", embyNextUpHandler(svc))
|
||||
auth.GET("/Users/:userId/Shows/NextUp", embyNextUpHandler(svc))
|
||||
// 部分客户端用路径形式 /Shows/{seriesId}/NextUp,而不是 query SeriesId。
|
||||
auth.GET("/Shows/:id/NextUp", embyShowNextUpHandler(svc))
|
||||
auth.GET("/Users/:userId/Shows/:id/NextUp", embyShowNextUpHandler(svc))
|
||||
auth.GET("/MediaSegments/:id", embyMediaSegmentsHandler(svc))
|
||||
auth.GET("/Items/:id/MediaSegments", embyMediaSegmentsHandler(svc))
|
||||
auth.GET("/Users/:userId/Items/:id/MediaSegments", embyMediaSegmentsHandler(svc))
|
||||
auth.GET("/Artists", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Persons", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Genres", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Genres", embyGenresHandler(svc))
|
||||
auth.GET("/Shows/Upcoming", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Users/:userId/Shows/Upcoming", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Items/:id/Similar", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Items/:id/Similar", embySimilarHandler(svc))
|
||||
auth.GET("/Items/:id/ThumbnailSet", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/Items/:id/ThemeMedia", embyThemeMediaHandler(svc))
|
||||
auth.GET("/Users/:userId/Items/:id/SpecialFeatures", embyEmptyItemsHandler(svc))
|
||||
|
||||
@@ -40,15 +40,19 @@ func registerLowercaseEmbyItemRoutes(auth *gin.RouterGroup, svc *service.Contain
|
||||
auth.GET("/shows/:id/episodes", embyShowEpisodesHandler(svc))
|
||||
auth.GET("/users/:userId/shows/:id/seasons", embyShowSeasonsHandler(svc))
|
||||
auth.GET("/users/:userId/shows/:id/episodes", embyShowEpisodesHandler(svc))
|
||||
auth.GET("/shows/nextup", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/users/:userId/shows/nextup", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/mediasegments/:id", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/shows/nextup", embyNextUpHandler(svc))
|
||||
auth.GET("/users/:userId/shows/nextup", embyNextUpHandler(svc))
|
||||
auth.GET("/shows/:id/nextup", embyShowNextUpHandler(svc))
|
||||
auth.GET("/users/:userId/shows/:id/nextup", embyShowNextUpHandler(svc))
|
||||
auth.GET("/mediasegments/:id", embyMediaSegmentsHandler(svc))
|
||||
auth.GET("/items/:id/mediasegments", embyMediaSegmentsHandler(svc))
|
||||
auth.GET("/users/:userId/items/:id/mediasegments", embyMediaSegmentsHandler(svc))
|
||||
auth.GET("/artists", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/persons", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/genres", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/genres", embyGenresHandler(svc))
|
||||
auth.GET("/shows/upcoming", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/users/:userId/shows/upcoming", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/items/:id/similar", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/items/:id/similar", embySimilarHandler(svc))
|
||||
auth.GET("/items/:id/thumbnailset", embyEmptyItemsHandler(svc))
|
||||
auth.GET("/items/:id/thememedia", embyThemeMediaHandler(svc))
|
||||
auth.GET("/users/:userId/items/:id/specialfeatures", embyEmptyItemsHandler(svc))
|
||||
|
||||
@@ -0,0 +1,55 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"net/http"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// 媒体库筛选面板接口:facets 提供可选项,random 提供「随便看看」。
|
||||
//
|
||||
// 两者都走与列表完全相同的可见性判定(mediaVisibilityForRequest)与筛选解析
|
||||
// (parseLibraryFilters),因此不会出现「列表里有、facets 里没有」或「随机跳
|
||||
// 到了筛选条件之外的条目」这类不一致。
|
||||
|
||||
func libraryFacetsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
libraryID := c.Param("id")
|
||||
facets, err := svc.Media.LibraryFacets(
|
||||
c.Request.Context(),
|
||||
libraryID,
|
||||
mediaVisibilityForRequest(c, svc),
|
||||
svc.Discovery,
|
||||
)
|
||||
if err != nil {
|
||||
writeInternalOrCanceled(c, err)
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, facets)
|
||||
}
|
||||
}
|
||||
|
||||
func libraryRandomHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
libraryID := c.Param("id")
|
||||
filters := parseLibraryFilters(c)
|
||||
// 随机只取一条,因此不带分页参数;未观看筛选仍需要会话用户。
|
||||
media, err := svc.Media.RandomMedia(
|
||||
c.Request.Context(),
|
||||
libraryID,
|
||||
mediaVisibilityForRequest(c, svc),
|
||||
filters,
|
||||
)
|
||||
if err != nil {
|
||||
writeInternalOrCanceled(c, err)
|
||||
return
|
||||
}
|
||||
if media == nil {
|
||||
c.JSON(http.StatusNotFound, gin.H{"error": "no media matches the current filters"})
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, media)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,283 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"testing"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"github.com/glebarez/sqlite"
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/middleware"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
func newLibraryFilterEnv(t *testing.T) (*gin.Engine, *service.Container, string, string) {
|
||||
t.Helper()
|
||||
gin.SetMode(gin.TestMode)
|
||||
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatalf("open db: %v", err)
|
||||
}
|
||||
if err := db.AutoMigrate(
|
||||
&model.User{}, &model.Library{}, &model.Media{}, &model.PlaybackHistory{}, &model.Setting{},
|
||||
); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
svc := &service.Container{Repo: repos, Log: zap.NewNop()}
|
||||
svc.Media = service.NewMediaService(nil, zap.NewNop(), repos)
|
||||
svc.Discovery = service.NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
|
||||
const userID = "user-1"
|
||||
if err := repos.User.Create(context.Background(), &model.User{
|
||||
Base: model.Base{ID: userID}, Username: "tester", PasswordHash: "x", Role: "user", IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
lib := &model.Library{Name: "电影", Path: "/media/movies", Type: "movie", Enabled: true}
|
||||
if err := repos.Library.Create(context.Background(), lib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
router := gin.New()
|
||||
authed := router.Group("/api", func(c *gin.Context) {
|
||||
c.Set(middleware.CtxUserID, userID)
|
||||
c.Set(middleware.CtxUserRole, "user")
|
||||
c.Next()
|
||||
})
|
||||
authed.GET("/libraries/:id/media", listMediaHandler(svc))
|
||||
authed.GET("/libraries/:id/facets", libraryFacetsHandler(svc))
|
||||
authed.GET("/libraries/:id/random", libraryRandomHandler(svc))
|
||||
return router, svc, userID, lib.ID
|
||||
}
|
||||
|
||||
func seedLibraryMedia(t *testing.T, svc *service.Container, rows ...*model.Media) {
|
||||
t.Helper()
|
||||
for _, row := range rows {
|
||||
if err := svc.Repo.DB.Create(row).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func getJSON(t *testing.T, router *gin.Engine, path string) (int, []byte) {
|
||||
t.Helper()
|
||||
req := httptest.NewRequest(http.MethodGet, path, nil)
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
return w.Code, w.Body.Bytes()
|
||||
}
|
||||
|
||||
func TestLibraryFacetsReturnGenresAndYears(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "A", Genres: "Action,Drama", Year: 1999, Path: "/a.mkv"},
|
||||
&model.Media{LibraryID: libID, Title: "B", Genres: "Action", Year: 2021, Path: "/b.mkv"},
|
||||
)
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/facets")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
var facets struct {
|
||||
Genres []struct {
|
||||
Name string `json:"name"`
|
||||
Count int `json:"count"`
|
||||
} `json:"genres"`
|
||||
YearMin int `json:"year_min"`
|
||||
YearMax int `json:"year_max"`
|
||||
}
|
||||
if err := json.Unmarshal(body, &facets); err != nil {
|
||||
t.Fatalf("decode %s: %v", body, err)
|
||||
}
|
||||
if facets.YearMin != 1999 || facets.YearMax != 2021 {
|
||||
t.Fatalf("year range = %d..%d, want 1999..2021", facets.YearMin, facets.YearMax)
|
||||
}
|
||||
if len(facets.Genres) != 2 {
|
||||
t.Fatalf("genres = %+v, want 2 entries", facets.Genres)
|
||||
}
|
||||
if facets.Genres[0].Name != "Action" || facets.Genres[0].Count != 2 {
|
||||
t.Fatalf("first genre = %+v, want Action:2", facets.Genres[0])
|
||||
}
|
||||
}
|
||||
|
||||
// 空库时 facets 必须返回空数组而不是 null,前端无需额外判空。
|
||||
func TestLibraryFacetsEmptyLibrary(t *testing.T) {
|
||||
router, _, _, libID := newLibraryFilterEnv(t)
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/facets")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
if !containsSubstring(string(body), `"genres":[]`) {
|
||||
t.Fatalf("body = %s, want genres:[]", body)
|
||||
}
|
||||
}
|
||||
|
||||
// 列表筛选:按类型过滤后只返回命中的条目。
|
||||
func TestListMediaAppliesGenreFilter(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "动作", Genres: "Action", Path: "/a.mkv"},
|
||||
&model.Media{LibraryID: libID, Title: "喜剧", Genres: "Comedy", Path: "/b.mkv"},
|
||||
)
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/media?group_versions=0&genre=Action")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
var payload struct {
|
||||
Items []model.Media `json:"items"`
|
||||
Total int64 `json:"total"`
|
||||
}
|
||||
if err := json.Unmarshal(body, &payload); err != nil {
|
||||
t.Fatalf("decode %s: %v", body, err)
|
||||
}
|
||||
if payload.Total != 1 || len(payload.Items) != 1 || payload.Items[0].Title != "动作" {
|
||||
t.Fatalf("payload = %+v, want only 动作", payload)
|
||||
}
|
||||
}
|
||||
|
||||
// 筛选条件必须进入缓存键:先请求未筛选列表、再筛选时不能命中旧缓存。
|
||||
func TestListMediaFilterBypassesUnfilteredCache(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "动作", Genres: "Action", Path: "/a.mkv"},
|
||||
&model.Media{LibraryID: libID, Title: "喜剧", Genres: "Comedy", Path: "/b.mkv"},
|
||||
)
|
||||
|
||||
// 先拉全量(可能写缓存),再拉筛选结果。
|
||||
if code, body := getJSON(t, router, "/api/libraries/"+libID+"/media?group_versions=0"); code != http.StatusOK {
|
||||
t.Fatalf("unfiltered status = %d body=%s", code, body)
|
||||
}
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/media?group_versions=0&genre=Comedy")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("filtered status = %d body=%s", code, body)
|
||||
}
|
||||
var payload struct {
|
||||
Total int64 `json:"total"`
|
||||
}
|
||||
if err := json.Unmarshal(body, &payload); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if payload.Total != 1 {
|
||||
t.Fatalf("total = %d, want 1 (filtered response must not be served from the unfiltered cache)", payload.Total)
|
||||
}
|
||||
}
|
||||
|
||||
// 未观看筛选:已看完的不出现,看了一半的仍出现。
|
||||
func TestListMediaUnwatchedFilter(t *testing.T) {
|
||||
router, svc, userID, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{Base: model.Base{ID: "m-done"}, LibraryID: libID, Title: "看完", Path: "/a.mkv"},
|
||||
&model.Media{Base: model.Base{ID: "m-half"}, LibraryID: libID, Title: "看一半", Path: "/b.mkv"},
|
||||
)
|
||||
for _, h := range []*model.PlaybackHistory{
|
||||
{UserID: userID, MediaID: "m-done", Completed: true},
|
||||
{UserID: userID, MediaID: "m-half", Completed: false},
|
||||
} {
|
||||
if err := svc.Repo.DB.Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/media?group_versions=0&unwatched=1")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
var payload struct {
|
||||
Items []model.Media `json:"items"`
|
||||
}
|
||||
if err := json.Unmarshal(body, &payload); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(payload.Items) != 1 || payload.Items[0].Title != "看一半" {
|
||||
t.Fatalf("items = %+v, want only 看一半", payload.Items)
|
||||
}
|
||||
}
|
||||
|
||||
func TestLibraryRandomReturnsMedia(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "唯一", Genres: "Action", Path: "/a.mkv"},
|
||||
)
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/random")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
var media model.Media
|
||||
if err := json.Unmarshal(body, &media); err != nil {
|
||||
t.Fatalf("decode %s: %v", body, err)
|
||||
}
|
||||
if media.Title != "唯一" {
|
||||
t.Fatalf("title = %q, want 唯一", media.Title)
|
||||
}
|
||||
}
|
||||
|
||||
// 筛选后没有命中时返回 404,前端据此提示「没有符合条件的媒体」。
|
||||
func TestLibraryRandomEmptyResultIs404(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "动作", Genres: "Action", Path: "/a.mkv"},
|
||||
)
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/random?genre=Nonexistent")
|
||||
if code != http.StatusNotFound {
|
||||
t.Fatalf("status = %d body=%s, want 404", code, body)
|
||||
}
|
||||
}
|
||||
|
||||
// axios 默认把数组序列化为 genre[]=Action 格式;后端必须把它当作 genre=Action 处理。
|
||||
func TestListMediaAcceptsBracketGenreParam(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "动作", Genres: "Action", Path: "/a.mkv"},
|
||||
&model.Media{LibraryID: libID, Title: "喜剧", Genres: "Comedy", Path: "/b.mkv"},
|
||||
)
|
||||
|
||||
// genre[]=Action — axios bracket format without custom paramsSerializer
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/media?group_versions=0&genre[]=Action")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
var payload struct {
|
||||
Items []model.Media `json:"items"`
|
||||
Total int64 `json:"total"`
|
||||
}
|
||||
if err := json.Unmarshal(body, &payload); err != nil {
|
||||
t.Fatalf("decode %s: %v", body, err)
|
||||
}
|
||||
if payload.Total != 1 || len(payload.Items) != 1 || payload.Items[0].Title != "动作" {
|
||||
t.Fatalf("payload = %+v, want only 动作 for genre[]=Action", payload)
|
||||
}
|
||||
}
|
||||
|
||||
// 随机也遵守筛选:只命中 Action 时,带 Comedy 筛选必须 404。
|
||||
func TestLibraryRandomHonoursFilters(t *testing.T) {
|
||||
router, svc, _, libID := newLibraryFilterEnv(t)
|
||||
seedLibraryMedia(t, svc,
|
||||
&model.Media{LibraryID: libID, Title: "A", Genres: "Action", Year: 2001, Path: "/a.mkv"},
|
||||
&model.Media{LibraryID: libID, Title: "B", Genres: "Comedy", Year: 2002, Path: "/b.mkv"},
|
||||
)
|
||||
|
||||
code, body := getJSON(t, router, "/api/libraries/"+libID+"/random?genre=Comedy&year_min=2002")
|
||||
if code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", code, body)
|
||||
}
|
||||
var media model.Media
|
||||
if err := json.Unmarshal(body, &media); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if media.Title != "B" {
|
||||
t.Fatalf("title = %q, want B", media.Title)
|
||||
}
|
||||
}
|
||||
@@ -4,6 +4,7 @@ package handler
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"math"
|
||||
"net/http"
|
||||
"strconv"
|
||||
"strings"
|
||||
@@ -407,6 +408,92 @@ func deleteLibraryHandler(svc *service.Container) gin.HandlerFunc {
|
||||
}
|
||||
}
|
||||
|
||||
// parseLibraryFilters 解析媒体库列表的筛选查询参数。
|
||||
//
|
||||
// 全部参数都是可选的:缺省时返回零值,`MediaListFilters.empty()` 为真,列表
|
||||
// 行为与此前完全一致(不引入任何默认筛选)。
|
||||
//
|
||||
// 参数约定:
|
||||
// - genre=Action&genre=Comedy 类型多选(或关系,整词匹配)
|
||||
// - year_min / year_max 年份区间,0 或非法值表示不限
|
||||
// - rating_min 评分下限(浮点)
|
||||
// - unwatched=1 仅显示未看完;用户 ID 取自会话
|
||||
func parseLibraryFilters(c *gin.Context) service.MediaListFilters {
|
||||
filters := service.MediaListFilters{
|
||||
Genres: parseRepeatedQueryValues(c, "genre"),
|
||||
YearMin: parseNonNegativeInt(firstQueryValue(c, "year_min", "yearMin")),
|
||||
YearMax: parseNonNegativeInt(firstQueryValue(c, "year_max", "yearMax")),
|
||||
RatingMin: parseNonNegativeFloat(firstQueryValue(c, "rating_min", "ratingMin")),
|
||||
}
|
||||
if isTruthyQuery(firstQueryValue(c, "unwatched", "unwatched_only", "unwatchedOnly")) {
|
||||
filters.Unwatched = true
|
||||
filters.UserID = toString(mustSessionUserID(c))
|
||||
}
|
||||
return filters
|
||||
}
|
||||
|
||||
// parseRepeatedQueryValues 读取可重复出现的查询参数,去重并丢弃空值。
|
||||
// 同时接受 key[] 括号格式(axios 1.x 默认序列化方式)作为向后兼容回退,
|
||||
// 在前端 paramsSerializer 未正确配置时不会静默返回空结果。
|
||||
func parseRepeatedQueryValues(c *gin.Context, key string) []string {
|
||||
raw := c.QueryArray(key)
|
||||
if len(raw) == 0 {
|
||||
// fallback: axios bracket format (e.g. genre[]=Action&genre[]=Comedy)
|
||||
raw = c.QueryArray(key + "[]")
|
||||
}
|
||||
if len(raw) == 0 {
|
||||
return nil
|
||||
}
|
||||
seen := make(map[string]struct{}, len(raw))
|
||||
out := make([]string, 0, len(raw))
|
||||
for _, value := range raw {
|
||||
// 客户端可能把多值拼成一次逗号分隔,两种形式都要接受。
|
||||
for _, part := range strings.Split(value, ",") {
|
||||
trimmed := strings.TrimSpace(part)
|
||||
if trimmed == "" {
|
||||
continue
|
||||
}
|
||||
if _, ok := seen[trimmed]; ok {
|
||||
continue
|
||||
}
|
||||
seen[trimmed] = struct{}{}
|
||||
out = append(out, trimmed)
|
||||
}
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
func parseNonNegativeInt(raw string) int {
|
||||
value, err := strconv.Atoi(strings.TrimSpace(raw))
|
||||
if err != nil || value < 0 {
|
||||
return 0
|
||||
}
|
||||
return value
|
||||
}
|
||||
|
||||
func parseNonNegativeFloat(raw string) float64 {
|
||||
value, err := strconv.ParseFloat(strings.TrimSpace(raw), 64)
|
||||
if err != nil || value < 0 || math.IsNaN(value) {
|
||||
return 0
|
||||
}
|
||||
return value
|
||||
}
|
||||
|
||||
func isTruthyQuery(raw string) bool {
|
||||
switch strings.ToLower(strings.TrimSpace(raw)) {
|
||||
case "1", "true", "yes", "on":
|
||||
return true
|
||||
default:
|
||||
return false
|
||||
}
|
||||
}
|
||||
|
||||
// mustSessionUserID 取会话用户 ID,缺失时返回空串(筛选逻辑会忽略它)。
|
||||
func mustSessionUserID(c *gin.Context) any {
|
||||
uid, _ := c.Get(middleware.CtxUserID)
|
||||
return uid
|
||||
}
|
||||
|
||||
func listMediaHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
id := c.Param("id")
|
||||
@@ -450,9 +537,10 @@ func listMediaHandler(svc *service.Container) gin.HandlerFunc {
|
||||
if sortSpec.Field == "last_played" {
|
||||
history = mediaHistoryMap(c, svc)
|
||||
}
|
||||
filters := parseLibraryFilters(c)
|
||||
groupVersions := c.DefaultQuery("group_versions", "1") != "0"
|
||||
if !groupVersions {
|
||||
items, total, err := svc.Media.ListMediaVisible(ctx, id, page, size, mediaVisibilityForRequest(c, svc))
|
||||
items, total, err := svc.Media.ListMediaVisibleFiltered(ctx, id, page, size, mediaVisibilityForRequest(c, svc), filters)
|
||||
if err != nil {
|
||||
writeInternalOrCanceled(c, err)
|
||||
return
|
||||
@@ -468,7 +556,7 @@ func listMediaHandler(svc *service.Container) gin.HandlerFunc {
|
||||
})
|
||||
return
|
||||
}
|
||||
grouped, err := svc.Media.GroupedMediaVisible(ctx, id, mediaVisibilityForRequest(c, svc))
|
||||
grouped, err := svc.Media.GroupedMediaVisibleFiltered(ctx, id, mediaVisibilityForRequest(c, svc), filters)
|
||||
if err != nil {
|
||||
writeInternalOrCanceled(c, err)
|
||||
return
|
||||
|
||||
@@ -346,6 +346,9 @@ func newPlaybackScopeTestRouter(t *testing.T) (*gin.Engine, *service.Container,
|
||||
&model.Library{},
|
||||
&model.Media{},
|
||||
&model.PlayProfile{},
|
||||
&model.Series{},
|
||||
&model.MediaSegment{},
|
||||
&model.MediaSegmentFetch{},
|
||||
); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
@@ -408,6 +411,7 @@ func newPlaybackScopeTestRouter(t *testing.T) (*gin.Engine, *service.Container,
|
||||
api := router.Group("/api")
|
||||
api.Use(middleware.AuthRequired(cfg.Secrets.JWTSecret))
|
||||
api.GET("/playback/:id/info", playbackInfoHandler(svc))
|
||||
api.GET("/playback/:id/segments", playbackSegmentsHandler(svc))
|
||||
api.GET("/playback/:id/external-url", externalURLHandler(svc))
|
||||
api.GET("/playback/:id/external-players", externalPlayersHandler(svc))
|
||||
api.GET("/stream/:id", streamHandler(svc))
|
||||
|
||||
@@ -0,0 +1,55 @@
|
||||
// Package handler — 片头/片尾片段接口。
|
||||
//
|
||||
// GET /playback/:id/segments
|
||||
//
|
||||
// 单独开一个接口而不是塞进 /media/:id/playback,有两个原因:一是抓取外部数据
|
||||
// 可能要几秒,不能拖慢决定能否起播的那个请求;二是片段与播放来源(本地 / 云盘 /
|
||||
// 远程 Emby)无关,独立出来对所有媒体一致。
|
||||
package handler
|
||||
|
||||
import (
|
||||
"net/http"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// playbackSegmentsHandler returns the skippable ranges for one media item.
|
||||
// The client calls it after playback has already started, so the provider
|
||||
// lookup never delays a play.
|
||||
func playbackSegmentsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
autoSkip := resolveAutoSkipFlag(c, svc)
|
||||
segments := []service.SegmentView{}
|
||||
|
||||
m, err := findMediaForPlaybackEndpoint(c, svc, c.Param("id"))
|
||||
if err != nil || m == nil || !mediaVisibleForRequest(c, svc, m) {
|
||||
c.JSON(http.StatusNotFound, gin.H{"error": "media not found"})
|
||||
return
|
||||
}
|
||||
// 远程 Emby 挂载的条目是上游库的投影,本地没有可查询的外部 ID 关联。
|
||||
if svc.Segments != nil && !service.IsEmbyRemoteID(m.ID) {
|
||||
rows, listErr := svc.Segments.ListForPlayback(c.Request.Context(), m)
|
||||
if listErr != nil && svc.Log != nil {
|
||||
svc.Log.Debug("list media segments failed",
|
||||
zap.String("media_id", m.ID), zap.Error(listErr))
|
||||
}
|
||||
segments = service.ToSegmentViews(rows)
|
||||
}
|
||||
c.JSON(http.StatusOK, gin.H{"segments": segments, "auto_skip": autoSkip})
|
||||
}
|
||||
}
|
||||
|
||||
// resolveAutoSkipFlag reads the「自动跳过片头」switch off whichever profile is
|
||||
// currently in effect. It reuses selectedPlayProfile so the server agrees with
|
||||
// the UI about which profile is active (explicit header first, then the user's
|
||||
// default profile), and a PIN-locked profile never silently skips for the user.
|
||||
func resolveAutoSkipFlag(c *gin.Context, svc *service.Container) bool {
|
||||
profile, locked := selectedPlayProfile(c, svc)
|
||||
if locked || profile == nil {
|
||||
return false
|
||||
}
|
||||
return profile.SkipIntro
|
||||
}
|
||||
@@ -0,0 +1,134 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"sync/atomic"
|
||||
"testing"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
type segmentPayload struct {
|
||||
Segments []struct {
|
||||
Kind string `json:"kind"`
|
||||
StartMs int64 `json:"start_ms"`
|
||||
EndMs int64 `json:"end_ms"`
|
||||
} `json:"segments"`
|
||||
AutoSkip bool `json:"auto_skip"`
|
||||
}
|
||||
|
||||
const segmentsProviderBody = `{"tmdb_id":27205,"type":"movie","intro":[{"start_ms":null,"end_ms":38000}],"credits":[{"start_ms":6480000,"end_ms":null}]}`
|
||||
|
||||
func TestPlaybackSegmentsReturnsProviderDataAndAutoSkip(t *testing.T) {
|
||||
router, svc, secret := newPlaybackScopeTestRouter(t)
|
||||
// 片段数据与播放来源无关,云盘媒体同样适用,只要它能解析出外部 ID。
|
||||
// 注意列名是 tm_db_id(GORM 对 TMDbID 的默认命名)。
|
||||
if err := svc.Repo.DB.Model(&model.Media{}).
|
||||
Where("id = ?", "media-1").Update("tm_db_id", 27205).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
var calls int32
|
||||
provider := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
atomic.AddInt32(&calls, 1)
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(segmentsProviderBody))
|
||||
}))
|
||||
defer provider.Close()
|
||||
svc.Segments = service.NewMediaSegmentService(zap.NewNop(), svc.Repo).
|
||||
SetIntroDB(service.NewIntroDBService(zap.NewNop()).SetBaseURL(provider.URL))
|
||||
|
||||
// 默认档案打开「自动跳过片头」,接口应把开关原样带出来。
|
||||
if err := svc.Repo.DB.Create(&model.PlayProfile{
|
||||
Base: model.Base{ID: "profile-1"},
|
||||
UserID: "user-1",
|
||||
Name: "主档案",
|
||||
IsDefault: true,
|
||||
SkipIntro: true,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
loginToken := signedTestToken(t, secret)
|
||||
fetch := func() segmentPayload {
|
||||
t.Helper()
|
||||
req := httptest.NewRequest(http.MethodGet, "http://nas.local/api/playback/media-1/segments", nil)
|
||||
req.Header.Set("Authorization", "Bearer "+loginToken)
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
var payload segmentPayload
|
||||
if err := json.Unmarshal(w.Body.Bytes(), &payload); err != nil {
|
||||
t.Fatalf("decode: %v", err)
|
||||
}
|
||||
return payload
|
||||
}
|
||||
|
||||
first := fetch()
|
||||
if !first.AutoSkip {
|
||||
t.Fatal("auto_skip should reflect the active profile's skip_intro switch")
|
||||
}
|
||||
if len(first.Segments) != 2 {
|
||||
t.Fatalf("segments = %#v, want 2", first.Segments)
|
||||
}
|
||||
// start_ms: null -> 0;end_ms: null -> 0(延续到片尾,由客户端按时长补齐)。
|
||||
if first.Segments[0].Kind != "intro" || first.Segments[0].StartMs != 0 || first.Segments[0].EndMs != 38_000 {
|
||||
t.Fatalf("intro segment = %#v", first.Segments[0])
|
||||
}
|
||||
if first.Segments[1].Kind != "credits" || first.Segments[1].StartMs != 6_480_000 || first.Segments[1].EndMs != 0 {
|
||||
t.Fatalf("credits segment = %#v", first.Segments[1])
|
||||
}
|
||||
|
||||
// 第二次播放必须走本地缓存,不再打外网。
|
||||
if second := fetch(); len(second.Segments) != 2 {
|
||||
t.Fatalf("second fetch segments = %#v", second.Segments)
|
||||
}
|
||||
if got := atomic.LoadInt32(&calls); got != 1 {
|
||||
t.Fatalf("provider calls = %d, want 1", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestPlaybackSegmentsAutoSkipIsFalseWithoutProfile(t *testing.T) {
|
||||
router, svc, secret := newPlaybackScopeTestRouter(t)
|
||||
svc.Segments = service.NewMediaSegmentService(zap.NewNop(), svc.Repo)
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "http://nas.local/api/playback/media-1/segments", nil)
|
||||
req.Header.Set("Authorization", "Bearer "+signedTestToken(t, secret))
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
var payload segmentPayload
|
||||
if err := json.Unmarshal(w.Body.Bytes(), &payload); err != nil {
|
||||
t.Fatalf("decode: %v", err)
|
||||
}
|
||||
if payload.AutoSkip {
|
||||
t.Fatal("auto_skip must default to false")
|
||||
}
|
||||
// 即使一条片段都没有,也必须返回空数组而不是 null,前端才能无条件遍历。
|
||||
if payload.Segments == nil {
|
||||
t.Fatal("segments must serialise as an empty array, not null")
|
||||
}
|
||||
}
|
||||
|
||||
func TestPlaybackSegmentsForUnknownMediaReturnsNotFound(t *testing.T) {
|
||||
router, svc, secret := newPlaybackScopeTestRouter(t)
|
||||
svc.Segments = service.NewMediaSegmentService(zap.NewNop(), svc.Repo)
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "http://nas.local/api/playback/does-not-exist/segments", nil)
|
||||
req.Header.Set("Authorization", "Bearer "+signedTestToken(t, secret))
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
|
||||
if w.Code != http.StatusNotFound {
|
||||
t.Fatalf("status = %d body=%s, want 404", w.Code, w.Body.String())
|
||||
}
|
||||
}
|
||||
@@ -116,8 +116,13 @@ func registerAdminUserRoutes(admin *gin.RouterGroup, svc *service.Container) {
|
||||
admin.PATCH("/users/:id/role", adminUpdateRoleHandler(svc))
|
||||
admin.PATCH("/users/:id/libraries", updateUserLibrariesHandler(svc))
|
||||
admin.DELETE("/users/:id", deleteUserHandler(svc))
|
||||
// 设备代管:管理员可查看并踢掉任意用户的设备。
|
||||
admin.GET("/users/:id/devices", adminUserDevicesHandler(svc))
|
||||
admin.POST("/users/:id/devices/kick-all", adminKickAllUserDevicesHandler(svc))
|
||||
admin.POST("/users/:id/devices/:deviceID/kick", adminKickUserDeviceHandler(svc))
|
||||
admin.GET("/settings", listSettingsHandler(svc))
|
||||
admin.PUT("/settings", updateSettingHandler(svc))
|
||||
admin.POST("/telegram/test", testTelegramHandler(svc))
|
||||
admin.POST("/adult/test-scraper", testAdultScraperHandler(svc))
|
||||
admin.GET("/logs", recentLogsHandler(svc))
|
||||
}
|
||||
|
||||
@@ -19,6 +19,16 @@ func registerAuthedUserAndLicenseRoutes(authed *gin.RouterGroup, svc *service.Co
|
||||
authed.GET("/me/temporary-password", temporaryPasswordHandler(svc))
|
||||
authed.POST("/me/temporary-password", temporaryPasswordHandler(svc))
|
||||
|
||||
// 设备管理:路由挂在 /me 下,用户 ID 一律取自会话,天然只能管自己的设备。
|
||||
authed.GET("/me/devices", myDevicesHandler(svc))
|
||||
authed.POST("/me/devices/kick-all", myKickAllDevicesHandler(svc))
|
||||
authed.POST("/me/devices/:deviceID/kick", myKickDeviceHandler(svc))
|
||||
|
||||
// Telegram 通知绑定:一次性码 + Bot /bind <code>。
|
||||
authed.GET("/me/telegram", getTelegramStatusHandler(svc))
|
||||
authed.POST("/me/telegram/bind-code", startTelegramBindHandler(svc))
|
||||
authed.DELETE("/me/telegram", unbindTelegramHandler(svc))
|
||||
|
||||
authed.GET("/auth/permissions", getMyPermissionsHandler(svc))
|
||||
}
|
||||
|
||||
@@ -38,6 +48,8 @@ func registerAuthedLibraryRoutes(authed *gin.RouterGroup, svc *service.Container
|
||||
authed.POST("/libraries/:id/scrape", middleware.AdminRequired(), scrapeLibraryHandler(svc))
|
||||
|
||||
authed.GET("/libraries/:id/media", listMediaHandler(svc))
|
||||
authed.GET("/libraries/:id/facets", libraryFacetsHandler(svc))
|
||||
authed.GET("/libraries/:id/random", libraryRandomHandler(svc))
|
||||
authed.GET("/libraries/:id/series", listLibrarySeriesHandler(svc))
|
||||
authed.GET("/libraries/:id/series/episodes", listLibrarySeriesEpisodesHandler(svc))
|
||||
authed.GET("/libraries/:id/seasons", listSeasonsHandler(svc))
|
||||
|
||||
@@ -15,7 +15,7 @@ func registerAuthedUISurfaceRoutes(authed *gin.RouterGroup, svc *service.Contain
|
||||
authed.PUT("/danmaku/settings", updateDanmakuSettingsHandler(svc))
|
||||
|
||||
authed.GET("/watch-history", historyListHandler(svc))
|
||||
authed.GET("/watch-history/stats", historyStatsHandler(svc))
|
||||
authed.GET("/watch-history/stats", requirePermission(svc, "can_view_history"), historyStatsHandler(svc))
|
||||
authed.GET("/watch-history/continue", historyContinueHandler(svc))
|
||||
authed.DELETE("/watch-history", historyDeleteHandler(svc))
|
||||
authed.DELETE("/watch-history/:id", historyDeleteOneHandler(svc))
|
||||
@@ -73,6 +73,7 @@ func registerAuthedFavoriteAndMediaActionRoutes(authed *gin.RouterGroup, svc *se
|
||||
func registerAuthedPlaybackExtraRoutes(authed *gin.RouterGroup, svc *service.Container) {
|
||||
authed.GET("/playback/:id/info", playbackInfoHandler(svc))
|
||||
authed.GET("/playback/:id/resume", playbackResumeHandler(svc))
|
||||
authed.GET("/playback/:id/segments", playbackSegmentsHandler(svc))
|
||||
authed.POST("/playback/:id/progress", playbackProgressHandler(svc))
|
||||
authed.GET("/playback/:id/external-players", externalPlayersHandler(svc))
|
||||
authed.GET("/playback/:id/external-url", externalURLHandler(svc))
|
||||
|
||||
@@ -36,6 +36,7 @@ func TestAuthenticatedRouteSurfacesAreRegistered(t *testing.T) {
|
||||
"GET /api/storage",
|
||||
"GET /api/watch-history",
|
||||
"GET /api/playback/:id/info",
|
||||
"GET /api/playback/:id/segments",
|
||||
} {
|
||||
if !routes[want] {
|
||||
t.Fatalf("%s route is not registered", want)
|
||||
|
||||
@@ -124,7 +124,9 @@ func listLibrarySeriesHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return
|
||||
}
|
||||
}
|
||||
items, total, err := svc.Media.ListLibrarySeriesCards(c.Request.Context(), libID, mediaVisibilityForRequest(c, svc))
|
||||
items, total, err := svc.Media.ListLibrarySeriesCardsFiltered(
|
||||
c.Request.Context(), libID, mediaVisibilityForRequest(c, svc), parseLibraryFilters(c),
|
||||
)
|
||||
if err != nil {
|
||||
writeInternalOrCanceled(c, err)
|
||||
return
|
||||
|
||||
@@ -0,0 +1,89 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"net/http"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
// Telegram 绑定与测试接口。
|
||||
//
|
||||
// 绑定刻意做成「网页生成一次性码 → 用户在 Bot 里发 /bind <码>」:服务端不需要
|
||||
// 用户手工填写 chat id,也不需要站点暴露 Bot 命令以外任何能力。
|
||||
|
||||
type telegramBindCodePayload struct {
|
||||
Code string `json:"code"`
|
||||
ExpiresIn int `json:"expires_in_seconds"`
|
||||
}
|
||||
|
||||
// startTelegramBindHandler 生成一次性绑定码。同一用户重复调用时旧码作废。
|
||||
func startTelegramBindHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
if svc.Telegram == nil {
|
||||
c.JSON(http.StatusServiceUnavailable, gin.H{"error": "telegram service unavailable"})
|
||||
return
|
||||
}
|
||||
userID := sessionUserID(c)
|
||||
code, err := svc.Telegram.StartBind(c.Request.Context(), userID)
|
||||
if err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, telegramBindCodePayload{Code: code, ExpiresIn: 300})
|
||||
}
|
||||
}
|
||||
|
||||
// getTelegramStatusHandler 返回绑定状态与脱敏会话 ID。
|
||||
func getTelegramStatusHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
if svc.Telegram == nil {
|
||||
c.JSON(http.StatusOK, gin.H{"bound": false})
|
||||
return
|
||||
}
|
||||
bound, masked := svc.Telegram.Status(c.Request.Context(), sessionUserID(c))
|
||||
payload := gin.H{"bound": bound}
|
||||
if bound {
|
||||
payload["chat_id_masked"] = masked
|
||||
}
|
||||
c.JSON(http.StatusOK, payload)
|
||||
}
|
||||
}
|
||||
|
||||
// unbindTelegramHandler 解除当前用户的 Telegram 绑定。
|
||||
func unbindTelegramHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
if svc.Telegram == nil {
|
||||
c.Status(http.StatusNoContent)
|
||||
return
|
||||
}
|
||||
if err := svc.Telegram.Unbind(c.Request.Context(), sessionUserID(c)); err != nil {
|
||||
c.JSON(http.StatusInternalServerError, gin.H{"error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.Status(http.StatusNoContent)
|
||||
}
|
||||
}
|
||||
|
||||
// testTelegramHandler 向管理员会话发送一条测试消息,用于验证 Token/会话 ID。
|
||||
func testTelegramHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
if svc.Telegram == nil {
|
||||
c.JSON(http.StatusServiceUnavailable, gin.H{"error": "telegram service unavailable"})
|
||||
return
|
||||
}
|
||||
if !svc.Telegram.Configured(c.Request.Context()) {
|
||||
c.JSON(http.StatusBadRequest, gin.H{
|
||||
"success": false,
|
||||
"error": "请先启用 Telegram 通知并填写 Bot Token 与管理员 Chat ID",
|
||||
})
|
||||
return
|
||||
}
|
||||
if err := svc.Telegram.SendToAdminChecked(c.Request.Context(), "✅ MeBox 测试消息:通知通道工作正常。"); err != nil {
|
||||
c.JSON(http.StatusOK, gin.H{"success": false, "error": err.Error()})
|
||||
return
|
||||
}
|
||||
c.JSON(http.StatusOK, gin.H{"success": true})
|
||||
}
|
||||
}
|
||||
@@ -11,8 +11,11 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"net/http"
|
||||
"sort"
|
||||
"strconv"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
@@ -48,11 +51,16 @@ func historyListHandler(svc *service.Container) gin.HandlerFunc {
|
||||
}
|
||||
|
||||
// historyStatsHandler returns aggregate watch time + completion counts
|
||||
// for the caller. Used by the WatchHistoryPage hero card.
|
||||
// for the caller. Used by the WatchHistoryPage hero card and the dedicated
|
||||
// personal statistics page.
|
||||
//
|
||||
// 统计口径全部来自 PlaybackHistory 本身,不新增统计表:position_ms 是「已看
|
||||
// 时长」的近似值,足以支撑趋势图;精确到秒的播放时长另有会话统计负责。
|
||||
func historyStatsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
return func(c *gin.Context) {
|
||||
uid, _ := c.Get(middleware.CtxUserID)
|
||||
userID := toString(uid)
|
||||
ctx := c.Request.Context()
|
||||
|
||||
var total int64
|
||||
_ = svc.Repo.DB.Model(&model.PlaybackHistory{}).
|
||||
@@ -77,16 +85,196 @@ func historyStatsHandler(svc *service.Container) gin.HandlerFunc {
|
||||
last = &lastT
|
||||
}
|
||||
|
||||
visibility := mediaVisibilityForRequest(c, svc)
|
||||
daily, byType, recent := historyStatsBreakdowns(ctx, svc, userID, visibility)
|
||||
|
||||
inProgress := total - completed
|
||||
if inProgress < 0 {
|
||||
inProgress = 0
|
||||
}
|
||||
|
||||
c.JSON(http.StatusOK, gin.H{
|
||||
"total": total,
|
||||
"completed": completed,
|
||||
"watched_ms": watchedMs,
|
||||
"watched_hours": float64(watchedMs) / 1000.0 / 3600.0,
|
||||
"last_watched": last,
|
||||
"total": total,
|
||||
"completed": completed,
|
||||
"in_progress": inProgress,
|
||||
"watched_ms": watchedMs,
|
||||
"watched_hours": float64(watchedMs) / 1000.0 / 3600.0,
|
||||
"last_watched": last,
|
||||
"daily": daily,
|
||||
"by_library_type": byType,
|
||||
"recent": recent,
|
||||
})
|
||||
}
|
||||
}
|
||||
|
||||
// historyStatsDailyDays 是趋势图回看的天数。
|
||||
const historyStatsDailyDays = 30
|
||||
|
||||
// historyStatsRecentLimit 是「最近看过」返回的条数。
|
||||
const historyStatsRecentLimit = 8
|
||||
|
||||
type historyDailyStat struct {
|
||||
Day string `json:"day"`
|
||||
WatchMs int64 `json:"watch_ms"`
|
||||
Plays int64 `json:"plays"`
|
||||
}
|
||||
|
||||
type historyTypeStat struct {
|
||||
Type string `json:"type"`
|
||||
WatchMs int64 `json:"watch_ms"`
|
||||
Count int64 `json:"count"`
|
||||
}
|
||||
|
||||
// historyStatsBreakdowns 产出每日趋势、按媒体库类型分布与最近记录。
|
||||
//
|
||||
// 分桶在 Go 里做而不是用 SQL 的日期函数:SQLite 的 strftime 与 PostgreSQL 的
|
||||
// to_char 语法不同,写两份 SQL 会在方言差异上长期出错,而历史行数受用户规模
|
||||
// 约束(每人一行一部媒体),一次全量读取是可以接受的。
|
||||
//
|
||||
// visibility 控制哪些媒体对调用者可见(播放档案、成人锁等)。
|
||||
func historyStatsBreakdowns(ctx context.Context, svc *service.Container, userID string, visibility service.MediaVisibility) ([]historyDailyStat, []historyTypeStat, []map[string]any) {
|
||||
daily := make([]historyDailyStat, 0, historyStatsDailyDays)
|
||||
byType := make([]historyTypeStat, 0)
|
||||
recent := make([]map[string]any, 0, historyStatsRecentLimit)
|
||||
|
||||
var rows []model.PlaybackHistory
|
||||
if err := svc.Repo.DB.WithContext(ctx).
|
||||
Where("user_id = ?", userID).
|
||||
Order("watched_at desc").
|
||||
Find(&rows).Error; err != nil || len(rows) == 0 {
|
||||
return daily, byType, recent
|
||||
}
|
||||
|
||||
// 每日趋势:只回看最近 N 天,且按「本地日」分桶,避免跨时区偏移。
|
||||
now := time.Now()
|
||||
cutoff := now.AddDate(0, 0, -(historyStatsDailyDays - 1))
|
||||
startOfDay := func(t time.Time) time.Time {
|
||||
local := t.In(time.Local)
|
||||
return time.Date(local.Year(), local.Month(), local.Day(), 0, 0, 0, 0, time.Local)
|
||||
}
|
||||
buckets := make(map[string]*historyDailyStat, historyStatsDailyDays)
|
||||
for i := 0; i < historyStatsDailyDays; i++ {
|
||||
day := startOfDay(cutoff).AddDate(0, 0, i).Format("2006-01-02")
|
||||
buckets[day] = &historyDailyStat{Day: day}
|
||||
}
|
||||
for _, r := range rows {
|
||||
watched := r.WatchedAt.In(time.Local)
|
||||
if watched.Before(startOfDay(cutoff)) {
|
||||
continue
|
||||
}
|
||||
if bucket, ok := buckets[watched.Format("2006-01-02")]; ok {
|
||||
bucket.WatchMs += r.PositionMs
|
||||
bucket.Plays++
|
||||
}
|
||||
}
|
||||
for i := 0; i < historyStatsDailyDays; i++ {
|
||||
day := startOfDay(cutoff).AddDate(0, 0, i).Format("2006-01-02")
|
||||
if bucket, ok := buckets[day]; ok && bucket.Plays > 0 {
|
||||
daily = append(daily, *bucket)
|
||||
}
|
||||
}
|
||||
|
||||
mediaIDs := make([]string, 0, len(rows))
|
||||
for _, r := range rows {
|
||||
mediaIDs = append(mediaIDs, r.MediaID)
|
||||
}
|
||||
var medias []model.Media
|
||||
_ = svc.Repo.DB.WithContext(ctx).Where("id IN ?", mediaIDs).Find(&medias).Error
|
||||
mediaByID := make(map[string]*model.Media, len(medias))
|
||||
for i := range medias {
|
||||
mediaByID[medias[i].ID] = &medias[i]
|
||||
}
|
||||
|
||||
libraryTypes := make(map[string]string)
|
||||
var libraries []model.Library
|
||||
if svc.Repo.Library != nil {
|
||||
if libs, err := svc.Repo.Library.List(ctx); err == nil {
|
||||
libraries = libs
|
||||
}
|
||||
}
|
||||
for _, lib := range libraries {
|
||||
libraryTypes[lib.ID] = lib.Type
|
||||
}
|
||||
|
||||
typeAcc := make(map[string]*historyTypeStat)
|
||||
order := make([]string, 0, 4)
|
||||
for _, r := range rows {
|
||||
media := mediaByID[r.MediaID]
|
||||
var key string
|
||||
if media == nil {
|
||||
// 媒体记录已删除(含 Emby 远程缓存失效):计入 "other" 桶而非丢弃,
|
||||
// 这样类型分布总数才能与播放历史总数吻合。
|
||||
key = "other"
|
||||
} else {
|
||||
// 如果调用者的可见性策略排除了该媒体,则跳过统计(visibility leak fix)。
|
||||
if !visibility.Allows(media) {
|
||||
continue
|
||||
}
|
||||
key = strings.TrimSpace(libraryTypes[media.LibraryID])
|
||||
if key == "" {
|
||||
key = "other"
|
||||
}
|
||||
}
|
||||
acc, ok := typeAcc[key]
|
||||
if !ok {
|
||||
acc = &historyTypeStat{Type: key}
|
||||
typeAcc[key] = acc
|
||||
order = append(order, key)
|
||||
}
|
||||
acc.WatchMs += r.PositionMs
|
||||
acc.Count++
|
||||
}
|
||||
// 顺序按观看时长降序,让「我主要在看什么」一眼可见。
|
||||
for _, key := range order {
|
||||
byType = append(byType, *typeAcc[key])
|
||||
}
|
||||
sort.SliceStable(byType, func(i, j int) bool {
|
||||
if byType[i].WatchMs != byType[j].WatchMs {
|
||||
return byType[i].WatchMs > byType[j].WatchMs
|
||||
}
|
||||
return byType[i].Type < byType[j].Type
|
||||
})
|
||||
|
||||
for _, r := range rows {
|
||||
if len(recent) >= historyStatsRecentLimit {
|
||||
break
|
||||
}
|
||||
entry := map[string]any{"history": r}
|
||||
if media := mediaByID[r.MediaID]; media != nil {
|
||||
// 可见性检查:隐藏库或受档案限制的媒体不进入最近记录(visibility leak fix)。
|
||||
if !visibility.Allows(media) {
|
||||
continue
|
||||
}
|
||||
entry["media"] = media
|
||||
} else if svc.EmbyRemote != nil && service.IsEmbyRemoteID(r.MediaID) {
|
||||
// 尝试从 Emby 远端补全媒体详情,与 historyContinueHandler 保持相同策略。
|
||||
mountID, remoteID, _ := service.DecodeEmbyRemoteID(r.MediaID)
|
||||
mount, acct, resolveErr := svc.EmbyRemote.ResolveMount(ctx, mountID)
|
||||
if resolveErr == nil && mount != nil && acct != nil {
|
||||
remoteMedia, detailErr := svc.EmbyRemote.RemoteMediaDetail(ctx, mount, acct, remoteID)
|
||||
if detailErr == nil && remoteMedia != nil {
|
||||
if !visibility.Allows(remoteMedia) {
|
||||
continue
|
||||
}
|
||||
entry["media"] = *remoteMedia
|
||||
} else {
|
||||
// 无法获取 Emby 媒体详情,跳过此条记录。
|
||||
continue
|
||||
}
|
||||
} else {
|
||||
// 挂载不可用,跳过。
|
||||
continue
|
||||
}
|
||||
} else {
|
||||
// 媒体记录不存在且无法 Emby 补全,跳过。
|
||||
continue
|
||||
}
|
||||
recent = append(recent, entry)
|
||||
}
|
||||
|
||||
return daily, byType, recent
|
||||
}
|
||||
|
||||
// historyContinueHandler returns "Continue Watching" rows: incomplete
|
||||
// items, most recent first.
|
||||
func historyContinueHandler(svc *service.Container) gin.HandlerFunc {
|
||||
|
||||
@@ -0,0 +1,349 @@
|
||||
package handler
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"github.com/gin-gonic/gin"
|
||||
"github.com/glebarez/sqlite"
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/middleware"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service"
|
||||
)
|
||||
|
||||
func newHistoryStatsEnv(t *testing.T) (*gin.Engine, *service.Container, string) {
|
||||
t.Helper()
|
||||
gin.SetMode(gin.TestMode)
|
||||
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatalf("open db: %v", err)
|
||||
}
|
||||
if err := db.AutoMigrate(&model.User{}, &model.Library{}, &model.Media{}, &model.PlaybackHistory{}, &model.UserPermission{}); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
svc := &service.Container{Repo: repos, Log: zap.NewNop()}
|
||||
svc.Permissions = service.NewPermissionService(zap.NewNop(), repos)
|
||||
|
||||
const userID = "user-1"
|
||||
if err := repos.User.Create(context.Background(), &model.User{
|
||||
Base: model.Base{ID: userID}, Username: "tester", PasswordHash: "x", Role: "user", IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
router := gin.New()
|
||||
authed := router.Group("/api", func(c *gin.Context) {
|
||||
c.Set(middleware.CtxUserID, userID)
|
||||
c.Next()
|
||||
})
|
||||
authed.GET("/watch-history/stats", historyStatsHandler(svc))
|
||||
return router, svc, userID
|
||||
}
|
||||
|
||||
type historyStatsPayload struct {
|
||||
Total int64 `json:"total"`
|
||||
Completed int64 `json:"completed"`
|
||||
InProgress int64 `json:"in_progress"`
|
||||
WatchedMs int64 `json:"watched_ms"`
|
||||
WatchedHours float64 `json:"watched_hours"`
|
||||
Daily []struct {
|
||||
Day string `json:"day"`
|
||||
WatchMs int64 `json:"watch_ms"`
|
||||
Plays int64 `json:"plays"`
|
||||
} `json:"daily"`
|
||||
ByLibraryType []struct {
|
||||
Type string `json:"type"`
|
||||
WatchMs int64 `json:"watch_ms"`
|
||||
Count int64 `json:"count"`
|
||||
} `json:"by_library_type"`
|
||||
Recent []struct {
|
||||
Media *model.Media `json:"media"`
|
||||
} `json:"recent"`
|
||||
}
|
||||
|
||||
func fetchHistoryStats(t *testing.T, router *gin.Engine) historyStatsPayload {
|
||||
t.Helper()
|
||||
req := httptest.NewRequest(http.MethodGet, "/api/watch-history/stats", nil)
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
if w.Code != http.StatusOK {
|
||||
t.Fatalf("status = %d body=%s", w.Code, w.Body.String())
|
||||
}
|
||||
var payload historyStatsPayload
|
||||
if err := json.Unmarshal(w.Body.Bytes(), &payload); err != nil {
|
||||
t.Fatalf("decode %s: %v", w.Body.String(), err)
|
||||
}
|
||||
return payload
|
||||
}
|
||||
|
||||
// 新字段必须提供每日聚合、库类型分布与在看数量,供个人统计页绘图。
|
||||
func TestHistoryStatsIncludesDailyAndTypes(t *testing.T) {
|
||||
router, svc, userID := newHistoryStatsEnv(t)
|
||||
ctx := context.Background()
|
||||
|
||||
movieLib := &model.Library{Name: "电影", Path: "/media/movies", Type: "movie", Enabled: true}
|
||||
if err := svc.Repo.Library.Create(ctx, movieLib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
tvLib := &model.Library{Name: "剧集", Path: "/media/tv", Type: "tv", Enabled: true}
|
||||
if err := svc.Repo.Library.Create(ctx, tvLib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
yesterday := time.Now().Add(-24 * time.Hour)
|
||||
today := time.Now().Add(-time.Hour)
|
||||
|
||||
rows := []struct {
|
||||
media *model.Media
|
||||
watchedAt time.Time
|
||||
position int64
|
||||
completed bool
|
||||
}{
|
||||
{
|
||||
media: &model.Media{LibraryID: movieLib.ID, Title: "电影A", Path: "/media/movies/a.mkv"},
|
||||
watchedAt: yesterday, position: 60000, completed: true,
|
||||
},
|
||||
{
|
||||
media: &model.Media{LibraryID: tvLib.ID, Title: "剧B", Path: "/media/tv/b.mkv"},
|
||||
watchedAt: today, position: 30000, completed: false,
|
||||
},
|
||||
}
|
||||
for _, row := range rows {
|
||||
if err := svc.Repo.DB.Create(row.media).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
h := &model.PlaybackHistory{
|
||||
UserID: userID, MediaID: row.media.ID, PositionMs: row.position,
|
||||
DurationMs: 120000, WatchedAt: row.watchedAt, Completed: row.completed,
|
||||
}
|
||||
if err := svc.Repo.DB.Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
payload := fetchHistoryStats(t, router)
|
||||
|
||||
if payload.Total != 2 {
|
||||
t.Fatalf("total = %d, want 2", payload.Total)
|
||||
}
|
||||
if payload.Completed != 1 {
|
||||
t.Fatalf("completed = %d, want 1", payload.Completed)
|
||||
}
|
||||
if payload.InProgress != 1 {
|
||||
t.Fatalf("in_progress = %d, want 1", payload.InProgress)
|
||||
}
|
||||
if payload.WatchedMs != 90000 {
|
||||
t.Fatalf("watched_ms = %d, want 90000", payload.WatchedMs)
|
||||
}
|
||||
if len(payload.Daily) != 2 {
|
||||
t.Fatalf("daily = %+v, want 2 days", payload.Daily)
|
||||
}
|
||||
if len(payload.ByLibraryType) != 2 {
|
||||
t.Fatalf("by_library_type = %+v, want 2 entries", payload.ByLibraryType)
|
||||
}
|
||||
if len(payload.Recent) != 2 {
|
||||
t.Fatalf("recent = %d entries, want 2", len(payload.Recent))
|
||||
}
|
||||
if payload.Recent[0].Media == nil || payload.Recent[0].Media.Title != "剧B" {
|
||||
t.Fatalf("recent[0] = %+v, want the most recent entry (剧B)", payload.Recent[0])
|
||||
}
|
||||
}
|
||||
|
||||
// 没有任何播放记录时,新字段要返回空数组而不是 null,前端无需额外判空。
|
||||
func TestHistoryStatsEmptyProvidesEmptyArrays(t *testing.T) {
|
||||
router, _, _ := newHistoryStatsEnv(t)
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "/api/watch-history/stats", nil)
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
|
||||
body := w.Body.String()
|
||||
for _, field := range []string{`"daily":[]`, `"by_library_type":[]`, `"recent":[]`} {
|
||||
if !containsSubstring(body, field) {
|
||||
t.Fatalf("body = %s, want %s", body, field)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func containsSubstring(haystack, needle string) bool {
|
||||
for i := 0; i+len(needle) <= len(haystack); i++ {
|
||||
if haystack[i:i+len(needle)] == needle {
|
||||
return true
|
||||
}
|
||||
}
|
||||
return false
|
||||
}
|
||||
|
||||
// TestHistoryStatsBreakdownsVisibilityFilter validates that historyStatsBreakdowns
|
||||
// respects the caller's MediaVisibility: media in a hidden library must be absent
|
||||
// from both the recent list and the by_library_type buckets.
|
||||
func TestHistoryStatsBreakdownsVisibilityFilter(t *testing.T) {
|
||||
_, svc, userID := newHistoryStatsEnv(t)
|
||||
ctx := context.Background()
|
||||
|
||||
allowedLib := &model.Library{Name: "允许库", Path: "/media/allowed", Type: "movie", Enabled: true}
|
||||
hiddenLib := &model.Library{Name: "隐藏库", Path: "/media/hidden", Type: "tv", Enabled: true}
|
||||
if err := svc.Repo.Library.Create(ctx, allowedLib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := svc.Repo.Library.Create(ctx, hiddenLib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
allowedMedia := &model.Media{LibraryID: allowedLib.ID, Title: "允许媒体", Path: "/media/allowed/a.mkv"}
|
||||
hiddenMedia := &model.Media{LibraryID: hiddenLib.ID, Title: "隐藏媒体", Path: "/media/hidden/b.mkv"}
|
||||
if err := svc.Repo.DB.Create(allowedMedia).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := svc.Repo.DB.Create(hiddenMedia).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
now := time.Now()
|
||||
for _, mid := range []string{allowedMedia.ID, hiddenMedia.ID} {
|
||||
h := &model.PlaybackHistory{
|
||||
UserID: userID, MediaID: mid, PositionMs: 10000,
|
||||
DurationMs: 100000, WatchedAt: now, Completed: false,
|
||||
}
|
||||
if err := svc.Repo.DB.Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
// visibility that hides hiddenLib
|
||||
vis := service.MediaVisibility{
|
||||
HiddenLibraryIDs: []string{hiddenLib.ID},
|
||||
}
|
||||
|
||||
_, byType, recent := historyStatsBreakdowns(ctx, svc, userID, vis)
|
||||
|
||||
// recent must contain only the allowed media
|
||||
for _, entry := range recent {
|
||||
m, ok := entry["media"]
|
||||
if !ok {
|
||||
t.Fatal("recent entry missing media field")
|
||||
}
|
||||
switch med := m.(type) {
|
||||
case *model.Media:
|
||||
if med.LibraryID == hiddenLib.ID {
|
||||
t.Fatalf("hidden media appeared in recent: %s", med.Title)
|
||||
}
|
||||
case model.Media:
|
||||
if med.LibraryID == hiddenLib.ID {
|
||||
t.Fatalf("hidden media appeared in recent: %s", med.Title)
|
||||
}
|
||||
}
|
||||
}
|
||||
if len(recent) != 1 {
|
||||
t.Fatalf("recent length = %d, want 1 (hidden entry must be excluded)", len(recent))
|
||||
}
|
||||
|
||||
// by_library_type must not contain the hidden library's type ("tv")
|
||||
for _, bt := range byType {
|
||||
if bt.Type == "tv" {
|
||||
t.Fatalf("hidden library type 'tv' appeared in by_library_type (count=%d)", bt.Count)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// TestHistoryStatsBreakdownsNilMediaCountsAsOther confirms that a history row
|
||||
// whose media has been deleted (nil lookup) is counted under the "other" type
|
||||
// bucket rather than silently dropped.
|
||||
func TestHistoryStatsBreakdownsNilMediaCountsAsOther(t *testing.T) {
|
||||
_, svc, userID := newHistoryStatsEnv(t)
|
||||
ctx := context.Background()
|
||||
|
||||
// Insert a history row whose media_id does not correspond to any Media row.
|
||||
ghost := &model.PlaybackHistory{
|
||||
UserID: userID,
|
||||
MediaID: "ghost-media-id",
|
||||
PositionMs: 5000,
|
||||
DurationMs: 50000,
|
||||
WatchedAt: time.Now(),
|
||||
Completed: false,
|
||||
}
|
||||
if err := svc.Repo.DB.Create(ghost).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
vis := service.MediaVisibility{} // unrestricted
|
||||
_, byType, _ := historyStatsBreakdowns(ctx, svc, userID, vis)
|
||||
|
||||
var otherEntry *historyTypeStat
|
||||
for i := range byType {
|
||||
if byType[i].Type == "other" {
|
||||
otherEntry = &byType[i]
|
||||
break
|
||||
}
|
||||
}
|
||||
if otherEntry == nil {
|
||||
t.Fatalf("expected 'other' bucket for nil-media history row, got %+v", byType)
|
||||
}
|
||||
if otherEntry.Count != 1 {
|
||||
t.Fatalf("other.Count = %d, want 1", otherEntry.Count)
|
||||
}
|
||||
}
|
||||
|
||||
// TestHistoryStatsPermissionDeny checks that a user without can_view_history
|
||||
// receives HTTP 403 from the gated route.
|
||||
func TestHistoryStatsPermissionDeny(t *testing.T) {
|
||||
gin.SetMode(gin.TestMode)
|
||||
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatalf("open db: %v", err)
|
||||
}
|
||||
if err := db.AutoMigrate(
|
||||
&model.User{}, &model.Library{}, &model.Media{},
|
||||
&model.PlaybackHistory{}, &model.UserPermission{},
|
||||
); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
repos := repository.New(db)
|
||||
svc := &service.Container{Repo: repos, Log: zap.NewNop()}
|
||||
svc.Permissions = service.NewPermissionService(zap.NewNop(), repos)
|
||||
|
||||
const userID = "user-noperm"
|
||||
if err := repos.User.Create(context.Background(), &model.User{
|
||||
Base: model.Base{ID: userID}, Username: "noperm", PasswordHash: "x", Role: "user", IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
// Explicitly deny can_view_history for this user.
|
||||
// First seed defaults (Effective will create the row with defaults), then
|
||||
// update to deny via Save which uses an explicit map update path in the repo.
|
||||
if _, err := svc.Permissions.Effective(context.Background(), userID); err != nil {
|
||||
t.Fatalf("seed permissions: %v", err)
|
||||
}
|
||||
denyPerm := &model.UserPermission{UserID: userID, CanViewHistory: false}
|
||||
if err := svc.Permissions.Save(context.Background(), userID, denyPerm); err != nil {
|
||||
t.Fatalf("save permission: %v", err)
|
||||
}
|
||||
|
||||
router := gin.New()
|
||||
authed := router.Group("/api", func(c *gin.Context) {
|
||||
c.Set(middleware.CtxUserID, userID)
|
||||
c.Set(middleware.CtxUserRole, "user")
|
||||
c.Next()
|
||||
})
|
||||
authed.GET("/watch-history/stats", requirePermission(svc, "can_view_history"), historyStatsHandler(svc))
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "/api/watch-history/stats", nil)
|
||||
w := httptest.NewRecorder()
|
||||
router.ServeHTTP(w, req)
|
||||
|
||||
if w.Code != http.StatusForbidden {
|
||||
t.Fatalf("status = %d, want 403 for user without can_view_history", w.Code)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,42 @@
|
||||
package model
|
||||
|
||||
import "time"
|
||||
|
||||
// MediaProbe 是一次 ffprobe 全量探测(容器 / 轨道 / 内嵌章节)的结果缓存。
|
||||
//
|
||||
// 它存在的理由:探测一次要 3~4 秒——远端直链更慢,因为要跨洋跑三次 HTTP
|
||||
// 事务。播放链路绝不能等它,所以第一次播放只起后台任务,结果落库后由后续请求
|
||||
// 与「跳过片头」的章节数据直接读库。
|
||||
//
|
||||
// Payload 刻意只保存裁剪后的字段:ffprobe 原始输出里的 format.filename 是解析
|
||||
// 后的播放直链(带网盘签名与 pickcode),原样落库等于把可直接下载的链接留在
|
||||
// 数据库里,所以只保留与技术信息有关的字段。
|
||||
type MediaProbe struct {
|
||||
Base
|
||||
MediaID string `gorm:"uniqueIndex;size:128;not null" json:"media_id"`
|
||||
// Signature 是「探的是哪个文件」的指纹(哈希):本地文件取路径 + 大小 +
|
||||
// 修改时间,STRM / 云盘取固化的播放目标。文件换了就说明缓存不再对应当前
|
||||
// 内容,需要重探。
|
||||
Signature string `gorm:"size:64" json:"signature,omitempty"`
|
||||
// Source 记录输入形态:local | strm。
|
||||
Source string `gorm:"size:16" json:"source,omitempty"`
|
||||
|
||||
Container string `gorm:"size:64" json:"container,omitempty"`
|
||||
DurationSec int `json:"duration_sec"`
|
||||
BitRate int64 `json:"bit_rate,omitempty"`
|
||||
Width int `json:"width,omitempty"`
|
||||
Height int `json:"height,omitempty"`
|
||||
VideoCodec string `gorm:"size:64" json:"video_codec,omitempty"`
|
||||
AudioCodec string `gorm:"size:64" json:"audio_codec,omitempty"`
|
||||
VideoStreams int `json:"video_streams"`
|
||||
AudioStreams int `json:"audio_streams"`
|
||||
SubtitleStreams int `json:"subtitle_streams"`
|
||||
ChapterCount int `json:"chapter_count"`
|
||||
|
||||
// Payload 是供详情页展示的裁剪后 JSON(容器 + 每路轨道 + 章节)。
|
||||
Payload string `gorm:"type:text" json:"payload,omitempty"`
|
||||
// ProbedAt 是最近一次探测的时刻。LastError 非空表示这次探测失败;失败只更新
|
||||
// 这两个字段,不会覆盖此前成功的 Payload 与已经落库的章节片段。
|
||||
ProbedAt time.Time `json:"probed_at"`
|
||||
LastError string `gorm:"size:512" json:"last_error,omitempty"`
|
||||
}
|
||||
@@ -0,0 +1,39 @@
|
||||
package model
|
||||
|
||||
import "time"
|
||||
|
||||
// 片段类型与 TheIntroDB 的返回字段一一对应。客户端按 kind 决定按钮文案
|
||||
// (片头 / 回顾 / 片尾 / 预告),不依赖具体来源。
|
||||
const (
|
||||
SegmentKindIntro = "intro"
|
||||
SegmentKindRecap = "recap"
|
||||
SegmentKindCredits = "credits"
|
||||
SegmentKindPreview = "preview"
|
||||
)
|
||||
|
||||
// MediaSegment 是媒体源时间轴上一个可被跳过的区间(片头 / 回顾 / 片尾 / 预告)。
|
||||
// 提供方(当前为 TheIntroDB)填充,播放器消费后向用户提供「跳过片头」。
|
||||
type MediaSegment struct {
|
||||
Base
|
||||
MediaID string `gorm:"index;size:128;not null;uniqueIndex:uniq_media_segment" json:"media_id"`
|
||||
SeriesID string `gorm:"index;size:128" json:"series_id,omitempty"`
|
||||
Kind string `gorm:"size:16;not null;uniqueIndex:uniq_media_segment" json:"kind"`
|
||||
// StartMs/EndMs 是媒体源时间轴上的毫秒绝对值。EndMs 为 0 表示区间一直延续到
|
||||
// 片尾(TheIntroDB 对末段返回 end_ms: null),由客户端结合媒体总时长补齐。
|
||||
StartMs int64 `gorm:"not null;default:0;uniqueIndex:uniq_media_segment" json:"start_ms"`
|
||||
EndMs int64 `gorm:"not null;default:0" json:"end_ms"`
|
||||
// Source 记录数据来源,让同一媒体上多来源共存、以及将来的人工覆盖成为可能。
|
||||
// 它必须参与唯一索引:否则「外部数据」与「人工修正」给出同一区间时会撞索引。
|
||||
Source string `gorm:"size:32;not null;default:'';uniqueIndex:uniq_media_segment" json:"source,omitempty"`
|
||||
}
|
||||
|
||||
// MediaSegmentFetch 记录「某媒体的片段是否已向某来源查询过」。
|
||||
// 单独建表是为了能缓存「查不到」这个结果:没有负缓存的话,每次播放一部社区库里
|
||||
// 还没有数据的影片都会重新打一次外网。
|
||||
type MediaSegmentFetch struct {
|
||||
Base
|
||||
MediaID string `gorm:"index;size:128;not null;uniqueIndex:uniq_media_segment_fetch" json:"media_id"`
|
||||
Source string `gorm:"size:32;not null;uniqueIndex:uniq_media_segment_fetch" json:"source"`
|
||||
FetchedAt time.Time `json:"fetched_at"`
|
||||
Found bool `json:"found"`
|
||||
}
|
||||
@@ -38,6 +38,9 @@ func AllModels() []interface{} {
|
||||
&Series{},
|
||||
&Media{},
|
||||
&PlaybackHistory{},
|
||||
&MediaSegment{},
|
||||
&MediaSegmentFetch{},
|
||||
&MediaProbe{},
|
||||
&Favorite{},
|
||||
&Playlist{},
|
||||
&PlaylistItem{},
|
||||
|
||||
@@ -55,6 +55,9 @@ type User struct {
|
||||
// expires. When set and in the past, the account is treated as expired
|
||||
// (login blocked) until an admin or a redemption code renews it.
|
||||
ExpiredAt *time.Time `json:"expired_at,omitempty"`
|
||||
// TelegramChatID 是用户绑定的 Telegram 会话 ID,用于接收账号与设备通知。
|
||||
// 为空表示未绑定;绑定走个人资料页生成的一次性码 + Bot /bind 命令。
|
||||
TelegramChatID string `gorm:"size:64" json:"telegram_chat_id,omitempty"`
|
||||
// ShareWarnings counts anti-account-sharing warnings, mainly device
|
||||
// fingerprint mismatches. Once it exceeds the configured threshold a
|
||||
// re-offence disables the account until an admin re-enables it.
|
||||
|
||||
@@ -0,0 +1,24 @@
|
||||
package model
|
||||
|
||||
import (
|
||||
"sync"
|
||||
"testing"
|
||||
|
||||
"gorm.io/gorm/schema"
|
||||
)
|
||||
|
||||
// TelegramChatID 是 Telegram 通知的绑定目标:Size 必须容得下真实 chat id
|
||||
// (群/频道 id 为负数且位数更长),因此下限设为 64。
|
||||
func TestUserTelegramChatIDFieldSize(t *testing.T) {
|
||||
parsed, err := schema.Parse(&User{}, &sync.Map{}, schema.NamingStrategy{})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
field := parsed.LookUpField("TelegramChatID")
|
||||
if field == nil {
|
||||
t.Fatal("TelegramChatID field not found")
|
||||
}
|
||||
if field.Size < 64 {
|
||||
t.Fatalf("TelegramChatID size = %d, want at least 64", field.Size)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,174 @@
|
||||
package repository
|
||||
|
||||
import (
|
||||
"context"
|
||||
"testing"
|
||||
|
||||
"github.com/glebarez/sqlite"
|
||||
"gorm.io/gorm"
|
||||
"gorm.io/gorm/logger"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
func newMediaFilterTestDB(t *testing.T) *gorm.DB {
|
||||
t.Helper()
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{
|
||||
Logger: logger.Default.LogMode(logger.Silent),
|
||||
})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := db.AutoMigrate(&model.Media{}, &model.PlaybackHistory{}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
return db
|
||||
}
|
||||
|
||||
func seedFilterMedia(t *testing.T, db *gorm.DB, rows ...*model.Media) {
|
||||
t.Helper()
|
||||
for _, row := range rows {
|
||||
if err := db.WithContext(context.Background()).Create(row).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func listFiltered(t *testing.T, db *gorm.DB, filter MediaQueryFilter) []string {
|
||||
t.Helper()
|
||||
var rows []model.Media
|
||||
q := db.WithContext(context.Background()).Model(&model.Media{})
|
||||
q = applyMediaQueryFilter(q, filter)
|
||||
if err := q.Order("title asc").Find(&rows).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
out := make([]string, 0, len(rows))
|
||||
for _, row := range rows {
|
||||
out = append(out, row.Title)
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
func hasTitle(items []string, want string) bool {
|
||||
for _, item := range items {
|
||||
if item == want {
|
||||
return true
|
||||
}
|
||||
}
|
||||
return false
|
||||
}
|
||||
|
||||
// 多个类型之间是「或」:勾选 Action 与 Comedy 应同时命中两类。
|
||||
func TestFilterByGenreOR(t *testing.T) {
|
||||
db := newMediaFilterTestDB(t)
|
||||
seedFilterMedia(t, db,
|
||||
&model.Media{Title: "动作", Genres: "Action", Path: "/a.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Title: "喜剧", Genres: "Comedy", Path: "/b.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Title: "剧情", Genres: "Drama", Path: "/c.mkv", LibraryID: "lib-1"},
|
||||
)
|
||||
|
||||
got := listFiltered(t, db, MediaQueryFilter{IncludeNSFW: true, Genres: []string{"Action", "Comedy"}})
|
||||
if !hasTitle(got, "动作") || !hasTitle(got, "喜剧") {
|
||||
t.Fatalf("result = %v, want both 动作 and 喜剧", got)
|
||||
}
|
||||
if hasTitle(got, "剧情") {
|
||||
t.Fatalf("result = %v, must not contain 剧情", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 类型匹配必须是整词匹配:搜 "Action" 不能命中 "ActionComedy" 这类拼接值。
|
||||
func TestFilterByGenreDoesNotMatchSubstring(t *testing.T) {
|
||||
db := newMediaFilterTestDB(t)
|
||||
seedFilterMedia(t, db,
|
||||
&model.Media{Title: "精确", Genres: "Action,Drama", Path: "/a.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Title: "拼接", Genres: "ActionComedy", Path: "/b.mkv", LibraryID: "lib-1"},
|
||||
)
|
||||
|
||||
got := listFiltered(t, db, MediaQueryFilter{IncludeNSFW: true, Genres: []string{"Action"}})
|
||||
if !hasTitle(got, "精确") {
|
||||
t.Fatalf("result = %v, want 精确", got)
|
||||
}
|
||||
if hasTitle(got, "拼接") {
|
||||
t.Fatalf("result = %v, must not match ActionComedy for Action", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestFilterYearAndRating(t *testing.T) {
|
||||
db := newMediaFilterTestDB(t)
|
||||
seedFilterMedia(t, db,
|
||||
&model.Media{Title: "老片", Year: 1995, Rating: 9, Path: "/a.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Title: "中年", Year: 2010, Rating: 5, Path: "/b.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Title: "新片", Year: 2023, Rating: 8, Path: "/c.mkv", LibraryID: "lib-1"},
|
||||
)
|
||||
|
||||
got := listFiltered(t, db, MediaQueryFilter{IncludeNSFW: true, YearMin: 2000, YearMax: 2020})
|
||||
if len(got) != 1 || got[0] != "中年" {
|
||||
t.Fatalf("year filter result = %v, want [中年]", got)
|
||||
}
|
||||
|
||||
got = listFiltered(t, db, MediaQueryFilter{IncludeNSFW: true, RatingMin: 8})
|
||||
if len(got) != 2 {
|
||||
t.Fatalf("rating filter result = %v, want 2 entries", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 「未观看」的语义是「没有标记看完的记录」:看了一半的仍应出现。
|
||||
func TestFilterUnwatchedExcludesCompleted(t *testing.T) {
|
||||
db := newMediaFilterTestDB(t)
|
||||
seedFilterMedia(t, db,
|
||||
&model.Media{Base: model.Base{ID: "m-done"}, Title: "看完", Path: "/a.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Base: model.Base{ID: "m-half"}, Title: "看一半", Path: "/b.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Base: model.Base{ID: "m-new"}, Title: "没看过", Path: "/c.mkv", LibraryID: "lib-1"},
|
||||
)
|
||||
|
||||
ctx := context.Background()
|
||||
for _, h := range []*model.PlaybackHistory{
|
||||
{UserID: "u1", MediaID: "m-done", Completed: true},
|
||||
{UserID: "u1", MediaID: "m-half", Completed: false},
|
||||
// 别人的完播记录不应影响本人筛选。
|
||||
{UserID: "u2", MediaID: "m-new", Completed: true},
|
||||
} {
|
||||
if err := db.WithContext(ctx).Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
got := listFiltered(t, db, MediaQueryFilter{
|
||||
IncludeNSFW: true, UnwatchedOnly: true, UnwatchedUserID: "u1",
|
||||
})
|
||||
if hasTitle(got, "看完") {
|
||||
t.Fatalf("result = %v, must exclude completed media", got)
|
||||
}
|
||||
if !hasTitle(got, "看一半") || !hasTitle(got, "没看过") {
|
||||
t.Fatalf("result = %v, want both 看一半 and 没看过", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 多词类型(如 "Science Fiction"):列侧 SQL 会 REPLACE 掉空格,参数侧也必须同步
|
||||
// 去掉空格,两侧对称才能命中。
|
||||
func TestFilterByGenreMultiWordStripsSpaces(t *testing.T) {
|
||||
db := newMediaFilterTestDB(t)
|
||||
seedFilterMedia(t, db,
|
||||
&model.Media{Title: "科幻", Genres: "Science Fiction,Drama", Path: "/a.mkv", LibraryID: "lib-1"},
|
||||
&model.Media{Title: "动作", Genres: "Action", Path: "/b.mkv", LibraryID: "lib-1"},
|
||||
)
|
||||
|
||||
got := listFiltered(t, db, MediaQueryFilter{IncludeNSFW: true, Genres: []string{"Science Fiction"}})
|
||||
if !hasTitle(got, "科幻") {
|
||||
t.Fatalf("result = %v, want 科幻 (multi-word genre must match after space stripping)", got)
|
||||
}
|
||||
if hasTitle(got, "动作") {
|
||||
t.Fatalf("result = %v, must not contain 动作", got)
|
||||
}
|
||||
}
|
||||
|
||||
// UnwatchedOnly 缺省 userID 时必须忽略该条件,而不是返回空结果。
|
||||
func TestFilterUnwatchedWithoutUserIsIgnored(t *testing.T) {
|
||||
db := newMediaFilterTestDB(t)
|
||||
seedFilterMedia(t, db, &model.Media{Title: "片", Path: "/a.mkv", LibraryID: "lib-1"})
|
||||
|
||||
got := listFiltered(t, db, MediaQueryFilter{IncludeNSFW: true, UnwatchedOnly: true})
|
||||
if len(got) != 1 {
|
||||
t.Fatalf("result = %v, want the row to be returned", got)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,61 @@
|
||||
package repository
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"time"
|
||||
|
||||
"gorm.io/gorm"
|
||||
"gorm.io/gorm/clause"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
// MediaProbeRepository 持久化 ffprobe 全量探测的结果缓存。
|
||||
type MediaProbeRepository struct{ db *gorm.DB }
|
||||
|
||||
// Get 返回某媒体的探测缓存,未探测过时返回 (nil, nil)。
|
||||
func (r *MediaProbeRepository) Get(ctx context.Context, mediaID string) (*model.MediaProbe, error) {
|
||||
var row model.MediaProbe
|
||||
err := r.db.WithContext(ctx).
|
||||
Where("media_id = ?", mediaID).
|
||||
First(&row).Error
|
||||
if errors.Is(err, gorm.ErrRecordNotFound) {
|
||||
return nil, nil
|
||||
}
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return &row, nil
|
||||
}
|
||||
|
||||
// Upsert 写入一次成功的探测结果(含裁剪后的媒体信息)。
|
||||
func (r *MediaProbeRepository) Upsert(ctx context.Context, row *model.MediaProbe) error {
|
||||
onConflict := clause.OnConflict{
|
||||
Columns: []clause.Column{{Name: "media_id"}},
|
||||
DoUpdates: clause.AssignmentColumns([]string{
|
||||
"signature", "source",
|
||||
"container", "duration_sec", "bit_rate",
|
||||
"width", "height", "video_codec", "audio_codec",
|
||||
"video_streams", "audio_streams", "subtitle_streams", "chapter_count",
|
||||
"payload", "probed_at", "last_error",
|
||||
"deleted_at",
|
||||
}),
|
||||
}
|
||||
return r.db.WithContext(ctx).Clauses(onConflict).Create(row).Error
|
||||
}
|
||||
|
||||
// MarkFailure 记录一次失败的探测。它只更新「时间 + 错误信息」,刻意不碰
|
||||
// payload 与其它字段:一次失败的重探不该把上一次成功拿到的媒体信息抹掉。
|
||||
func (r *MediaProbeRepository) MarkFailure(ctx context.Context, mediaID, message string, probedAt time.Time) error {
|
||||
row := model.MediaProbe{MediaID: mediaID, ProbedAt: probedAt, LastError: message}
|
||||
onConflict := clause.OnConflict{
|
||||
Columns: []clause.Column{{Name: "media_id"}},
|
||||
DoUpdates: clause.Assignments(map[string]any{
|
||||
"probed_at": probedAt,
|
||||
"last_error": message,
|
||||
"deleted_at": nil,
|
||||
}),
|
||||
}
|
||||
return r.db.WithContext(ctx).Clauses(onConflict).Create(&row).Error
|
||||
}
|
||||
@@ -0,0 +1,105 @@
|
||||
package repository
|
||||
|
||||
import (
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
func TestMediaProbeUpsertReplacesAndGetReturnsLatest(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
|
||||
first := &model.MediaProbe{
|
||||
MediaID: "m-1", Signature: "sig-1", Source: "local",
|
||||
Container: "matroska,webm", DurationSec: 1451, ChapterCount: 2,
|
||||
Payload: `{"container":"matroska,webm"}`, ProbedAt: time.Now(),
|
||||
}
|
||||
if err := repos.MediaProbe.Upsert(ctx, first); err != nil {
|
||||
t.Fatalf("upsert #1: %v", err)
|
||||
}
|
||||
second := &model.MediaProbe{
|
||||
MediaID: "m-1", Signature: "sig-2", Source: "strm",
|
||||
Container: "mp4", DurationSec: 900, ChapterCount: 0,
|
||||
Payload: `{"container":"mp4"}`, ProbedAt: time.Now(),
|
||||
}
|
||||
if err := repos.MediaProbe.Upsert(ctx, second); err != nil {
|
||||
t.Fatalf("upsert #2: %v", err)
|
||||
}
|
||||
|
||||
got, err := repos.MediaProbe.Get(ctx, "m-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got == nil {
|
||||
t.Fatal("probe row missing")
|
||||
}
|
||||
if got.Container != "mp4" || got.DurationSec != 900 || got.Signature != "sig-2" || got.Payload != `{"container":"mp4"}` {
|
||||
t.Fatalf("probe = %#v, want the second upsert to win", got)
|
||||
}
|
||||
// 重复探测不能累积重复行:media_id 是唯一索引。
|
||||
var count int64
|
||||
if err := repos.DB.Model(&model.MediaProbe{}).Where("media_id = ?", "m-1").Count(&count).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if count != 1 {
|
||||
t.Fatalf("rows = %d, want 1", count)
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeGetReturnsNilWhenMissing(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
got, err := repos.MediaProbe.Get(t.Context(), "nope")
|
||||
if err != nil {
|
||||
t.Fatalf("Get: %v", err)
|
||||
}
|
||||
if got != nil {
|
||||
t.Fatalf("probe = %#v, want nil", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeMarkFailureKeepsPreviousPayload(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
|
||||
if err := repos.MediaProbe.Upsert(ctx, &model.MediaProbe{
|
||||
MediaID: "m-1", Container: "matroska,webm", DurationSec: 1451,
|
||||
ChapterCount: 2, Payload: `{"container":"matroska,webm"}`, ProbedAt: time.Now(),
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := repos.MediaProbe.MarkFailure(ctx, "m-1", "ffprobe full: exit status 1", time.Now()); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
got, err := repos.MediaProbe.Get(ctx, "m-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got == nil || got.LastError != "ffprobe full: exit status 1" {
|
||||
t.Fatalf("probe = %#v, want the recorded failure", got)
|
||||
}
|
||||
// 一次失败的重探不该把上一次成功拿到的媒体信息抹掉。
|
||||
if got.Container != "matroska,webm" || got.DurationSec != 1451 || got.Payload == "" || got.ChapterCount != 2 {
|
||||
t.Fatalf("a failed re-probe wiped the previous summary: %#v", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeMarkFailureInsertsRowWhenAbsent(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
|
||||
// 没有历史成功记录时,失败也必须落一行:否则冷却期没有时间戳,
|
||||
// 每次播放都会重跑一次注定失败的探测。
|
||||
if err := repos.MediaProbe.MarkFailure(ctx, "m-2", "boom", time.Now()); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
got, err := repos.MediaProbe.Get(ctx, "m-2")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got == nil || got.LastError != "boom" || got.ProbedAt.IsZero() {
|
||||
t.Fatalf("probe = %#v, want a failure row with a timestamp", got)
|
||||
}
|
||||
}
|
||||
@@ -44,6 +44,21 @@ type MediaQueryFilter struct {
|
||||
AllowedLibraryIDs []string
|
||||
HiddenLibraryIDs []string
|
||||
SeriesID string
|
||||
// LibraryID 是精确匹配的单个库过滤,用于库内场景(例如媒体库页筛选)。
|
||||
// 它与 AllowedLibraryIDs 是「与」关系:可见性仍由后者兜底,避免越权。
|
||||
LibraryID string
|
||||
// Genres 是类型多选,之间为「或」。按整词匹配(见 genreMatchClause)。
|
||||
Genres []string
|
||||
// YearMin / YearMax 为 0 表示该端不限。
|
||||
YearMin int
|
||||
YearMax int
|
||||
// RatingMin 为 0 表示不限。
|
||||
RatingMin float64
|
||||
// UnwatchedOnly 排除 UnwatchedUserID 已标记看完的条目。
|
||||
// 「未观看」定义为「没有 completed=true 的记录」:看到一半的仍会出现,
|
||||
// 与「继续观看」互补而不是重复。
|
||||
UnwatchedOnly bool
|
||||
UnwatchedUserID string
|
||||
}
|
||||
|
||||
func applyMediaQueryFilter(q *gorm.DB, filter MediaQueryFilter) *gorm.DB {
|
||||
@@ -56,12 +71,113 @@ func applyMediaQueryFilter(q *gorm.DB, filter MediaQueryFilter) *gorm.DB {
|
||||
if len(filter.AllowedLibraryIDs) > 0 {
|
||||
q = q.Where("library_id IN ?", filter.AllowedLibraryIDs)
|
||||
}
|
||||
if libraryID := strings.TrimSpace(filter.LibraryID); libraryID != "" {
|
||||
q = q.Where("library_id = ?", libraryID)
|
||||
}
|
||||
if seriesID := strings.TrimSpace(filter.SeriesID); seriesID != "" {
|
||||
q = q.Where("series_id = ?", seriesID)
|
||||
}
|
||||
if len(filter.Genres) > 0 {
|
||||
q = q.Where(genreMatchClause(filter.Genres), genreMatchArgs(filter.Genres)...)
|
||||
}
|
||||
if filter.YearMin > 0 {
|
||||
q = q.Where("year >= ?", filter.YearMin)
|
||||
}
|
||||
if filter.YearMax > 0 {
|
||||
q = q.Where("year <= ?", filter.YearMax)
|
||||
}
|
||||
if filter.RatingMin > 0 {
|
||||
q = q.Where("rating >= ?", filter.RatingMin)
|
||||
}
|
||||
if filter.UnwatchedOnly {
|
||||
userID := strings.TrimSpace(filter.UnwatchedUserID)
|
||||
// 没有用户上下文时忽略该条件:否则会把整个库筛成空,看起来像「坏了」。
|
||||
if userID != "" {
|
||||
q = q.Where(
|
||||
"id NOT IN (SELECT media_id FROM playback_histories WHERE user_id = ? AND completed = ?)",
|
||||
userID, true,
|
||||
)
|
||||
}
|
||||
}
|
||||
return q
|
||||
}
|
||||
|
||||
// genreMatchClause 生成类型整词匹配条件。
|
||||
//
|
||||
// genres 列是逗号分隔字符串,直接 LIKE '%Action%' 会把 "ActionComedy" 也命中。
|
||||
// 这里统一补上首尾逗号(并用空格容错)后再按 "%,Action,%" 匹配,实现整词语义;
|
||||
// 该写法在 SQLite 与 PostgreSQL 上行为一致,因此不需要方言分支。
|
||||
//
|
||||
// 注意写法:参数本身带上首尾逗号,SQL 里只做一次 REPLACE 来保证列值两端也有
|
||||
// 分隔符,避免 OR 链里重复拼接列表达式。
|
||||
func genreMatchClause(genres []string) string {
|
||||
clauses := make([]string, 0, len(genres))
|
||||
for range genres {
|
||||
clauses = append(clauses, "',' || REPLACE(REPLACE(TRIM(genres), ' ', ''), ',', ',') || ',' LIKE ?")
|
||||
}
|
||||
return "(" + strings.Join(clauses, " OR ") + ")"
|
||||
}
|
||||
|
||||
// genreMatchArgs 生成与 genreMatchClause 对应的参数,形如 "%,Action,%"。
|
||||
//
|
||||
// 必须与 genreMatchClause 的列端处理完全对称:
|
||||
// - TRIM → TrimSpace
|
||||
// - REPLACE(…, ' ', '') → ReplaceAll(…, " ", "") ← 多词类型(如 "Science Fiction")
|
||||
// - REPLACE(…, ',', ',') → ReplaceAll(…, ",", ",")
|
||||
func genreMatchArgs(genres []string) []any {
|
||||
args := make([]any, 0, len(genres))
|
||||
for _, genre := range genres {
|
||||
name := strings.ReplaceAll(strings.TrimSpace(genre), ",", ",")
|
||||
name = strings.ReplaceAll(name, " ", "") // mirror REPLACE(…,' ','') in genreMatchClause
|
||||
if name == "" {
|
||||
name = "\x00" // 空类型不会命中任何行
|
||||
}
|
||||
args = append(args, "%,"+name+",%")
|
||||
}
|
||||
return args
|
||||
}
|
||||
|
||||
// ListGenreValues 返回符合过滤条件的 media.genres 原始值(逗号分隔字符串)。
|
||||
//
|
||||
// 只取单列:类型聚合不需要整行 media,而一台大库的整行扫描会把海报 URL、
|
||||
// 简介等大字段一起读进内存。切分与去重交给调用方,SQL 层保持方言无关。
|
||||
func (r *MediaRepository) ListGenreValues(ctx context.Context, filter MediaQueryFilter) ([]string, error) {
|
||||
var values []string
|
||||
q := r.db.WithContext(ctx).
|
||||
Model(&model.Media{}).
|
||||
Where("genres IS NOT NULL AND genres <> ''")
|
||||
q = applyMediaQueryFilter(q, filter)
|
||||
if err := q.Pluck("genres", &values).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return values, nil
|
||||
}
|
||||
|
||||
// YearRange 返回符合过滤条件的年份区间(两端都为 0 表示没有可用年份)。
|
||||
// 供媒体库筛选面板生成年份上下限,避免前端硬编码或先取全量再自己算。
|
||||
func (r *MediaRepository) YearRange(ctx context.Context, filter MediaQueryFilter) (int, int, error) {
|
||||
var bounds struct {
|
||||
MinYear *int
|
||||
MaxYear *int
|
||||
}
|
||||
q := r.db.WithContext(ctx).
|
||||
Model(&model.Media{}).
|
||||
Where("year > 0").
|
||||
Select("MIN(year) AS min_year, MAX(year) AS max_year")
|
||||
q = applyMediaQueryFilter(q, filter)
|
||||
if err := q.Scan(&bounds).Error; err != nil {
|
||||
return 0, 0, err
|
||||
}
|
||||
min, max := 0, 0
|
||||
if bounds.MinYear != nil {
|
||||
min = *bounds.MinYear
|
||||
}
|
||||
if bounds.MaxYear != nil {
|
||||
max = *bounds.MaxYear
|
||||
}
|
||||
return min, max, nil
|
||||
}
|
||||
|
||||
func (r *MediaRepository) indexMediaBestEffort(ctx context.Context, media model.Media) {
|
||||
backend, ok := r.searchBackend.(MediaSearchSyncBackend)
|
||||
if !ok {
|
||||
@@ -83,6 +199,39 @@ func (r *MediaRepository) FindByID(ctx context.Context, id string) (*model.Media
|
||||
return &m, nil
|
||||
}
|
||||
|
||||
// ExistsSiblingWithTMDbID reports whether another row of the same show carries
|
||||
// the same tm_db_id as m.
|
||||
//
|
||||
// 它的用途是把「剧集级 id」和「单集自己的 id」区分开:一部剧的多集共用一个
|
||||
// 剧集级 id,而单集各自的 id 不会重复。调用方据此决定能否把 Media.TMDbID
|
||||
// 当作 Series.TMDbID 的替代品(见 MediaSegmentService.queryIDs)。
|
||||
//
|
||||
// 同一部剧的判定优先用 series_id;没有 series_id 的行(部分刮削路径不写它)
|
||||
// 退回到「同一个库 + 同一个标题」。查询失败按「不共用」处理:宁可不查,
|
||||
// 也不能拿一个可能是单集的 id 去查错片。
|
||||
func (r *MediaRepository) ExistsSiblingWithTMDbID(ctx context.Context, m *model.Media) bool {
|
||||
if r == nil || m == nil || m.TMDbID <= 0 || m.ID == "" {
|
||||
return false
|
||||
}
|
||||
query := r.db.WithContext(ctx).Model(&model.Media{}).
|
||||
Where("tm_db_id = ? AND id <> ?", m.TMDbID, m.ID)
|
||||
if seriesID := strings.TrimSpace(m.SeriesID); seriesID != "" {
|
||||
query = query.Where("series_id = ?", seriesID)
|
||||
} else {
|
||||
libraryID := strings.TrimSpace(m.LibraryID)
|
||||
title := strings.TrimSpace(m.Title)
|
||||
if libraryID == "" || title == "" {
|
||||
return false
|
||||
}
|
||||
query = query.Where("library_id = ? AND title = ?", libraryID, title)
|
||||
}
|
||||
var count int64
|
||||
if err := query.Limit(1).Count(&count).Error; err != nil {
|
||||
return false
|
||||
}
|
||||
return count > 0
|
||||
}
|
||||
|
||||
// ListByLibrary returns paginated media items for a library.
|
||||
func (r *MediaRepository) ListByLibrary(ctx context.Context, libraryID string, offset, limit int) ([]model.Media, int64, error) {
|
||||
return r.ListByLibraryFiltered(ctx, libraryID, offset, limit, MediaQueryFilter{IncludeNSFW: true})
|
||||
|
||||
@@ -0,0 +1,86 @@
|
||||
package repository
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
|
||||
"gorm.io/gorm"
|
||||
"gorm.io/gorm/clause"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
// MediaSegmentRepository persists intro/recap/credits/preview ranges.
|
||||
type MediaSegmentRepository struct{ db *gorm.DB }
|
||||
|
||||
// ListByMedia returns every stored segment for a media item, ordered by start.
|
||||
func (r *MediaSegmentRepository) ListByMedia(ctx context.Context, mediaID string) ([]model.MediaSegment, error) {
|
||||
rows := make([]model.MediaSegment, 0, 4)
|
||||
err := r.db.WithContext(ctx).
|
||||
Where("media_id = ?", mediaID).
|
||||
Order("start_ms asc").
|
||||
Find(&rows).Error
|
||||
return rows, err
|
||||
}
|
||||
|
||||
// ListByMediaSource returns the segments contributed by one source only, ordered
|
||||
// by start. Used to read the ffprobe-extracted chapters independently of the
|
||||
// community-database rows, so the player can pick between them.
|
||||
func (r *MediaSegmentRepository) ListByMediaSource(ctx context.Context, mediaID, source string) ([]model.MediaSegment, error) {
|
||||
rows := make([]model.MediaSegment, 0, 4)
|
||||
err := r.db.WithContext(ctx).
|
||||
Where("media_id = ? AND source = ?", mediaID, source).
|
||||
Order("start_ms asc").
|
||||
Find(&rows).Error
|
||||
return rows, err
|
||||
}
|
||||
|
||||
// ReplaceForMedia swaps the segments contributed by one source in a single
|
||||
// transaction, so a provider refresh can never leave a half-updated set.
|
||||
//
|
||||
// Rows are hard-deleted rather than soft-deleted: the unique index on
|
||||
// (media_id, kind, start_ms) would otherwise collide with the tombstoned rows
|
||||
// on the next insert.
|
||||
func (r *MediaSegmentRepository) ReplaceForMedia(ctx context.Context, mediaID, source string, rows []model.MediaSegment) error {
|
||||
return r.db.WithContext(ctx).Transaction(func(tx *gorm.DB) error {
|
||||
if err := tx.Unscoped().
|
||||
Where("media_id = ? AND source = ?", mediaID, source).
|
||||
Delete(&model.MediaSegment{}).Error; err != nil {
|
||||
return err
|
||||
}
|
||||
if len(rows) == 0 {
|
||||
return nil
|
||||
}
|
||||
return tx.Create(&rows).Error
|
||||
})
|
||||
}
|
||||
|
||||
// GetFetch returns the fetch ledger row for (media, source), or (nil, nil).
|
||||
func (r *MediaSegmentRepository) GetFetch(ctx context.Context, mediaID, source string) (*model.MediaSegmentFetch, error) {
|
||||
var row model.MediaSegmentFetch
|
||||
err := r.db.WithContext(ctx).
|
||||
Where("media_id = ? AND source = ?", mediaID, source).
|
||||
First(&row).Error
|
||||
if errors.Is(err, gorm.ErrRecordNotFound) {
|
||||
return nil, nil
|
||||
}
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return &row, nil
|
||||
}
|
||||
|
||||
// UpsertFetch records the outcome of a provider lookup. The `deleted_at: nil`
|
||||
// assignment revives a previously deleted row instead of failing on the unique
|
||||
// index, mirroring the playback history upsert.
|
||||
func (r *MediaSegmentRepository) UpsertFetch(ctx context.Context, row *model.MediaSegmentFetch) error {
|
||||
onConflict := clause.OnConflict{
|
||||
Columns: []clause.Column{{Name: "media_id"}, {Name: "source"}},
|
||||
DoUpdates: clause.Assignments(map[string]any{
|
||||
"fetched_at": row.FetchedAt,
|
||||
"found": row.Found,
|
||||
"deleted_at": nil,
|
||||
}),
|
||||
}
|
||||
return r.db.WithContext(ctx).Clauses(onConflict).Create(row).Error
|
||||
}
|
||||
@@ -0,0 +1,154 @@
|
||||
package repository
|
||||
|
||||
import (
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"github.com/glebarez/sqlite"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/database"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
func newSegmentTestRepos(t *testing.T) *Container {
|
||||
t.Helper()
|
||||
db, err := gorm.Open(sqlite.Open(":memory:"), &gorm.Config{})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := database.AutoMigrate(db); err != nil {
|
||||
t.Fatalf("migrate: %v", err)
|
||||
}
|
||||
return New(db)
|
||||
}
|
||||
|
||||
func TestReplaceForMediaIsIdempotentAcrossRefreshes(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
|
||||
rows := []model.MediaSegment{
|
||||
{MediaID: "m-1", Kind: model.SegmentKindIntro, StartMs: 228_664, EndMs: 246_143, Source: "theintrodb"},
|
||||
{MediaID: "m-1", Kind: model.SegmentKindCredits, StartMs: 3_431_000, EndMs: 0, Source: "theintrodb"},
|
||||
}
|
||||
// 重复刷新不能因为 (media_id, kind, start_ms, source) 唯一索引而失败,也不能累积重复行。
|
||||
for i := 0; i < 2; i++ {
|
||||
if err := repos.MediaSegment.ReplaceForMedia(ctx, "m-1", "theintrodb", rows); err != nil {
|
||||
t.Fatalf("replace #%d: %v", i+1, err)
|
||||
}
|
||||
}
|
||||
got, err := repos.MediaSegment.ListByMedia(ctx, "m-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(got) != 2 {
|
||||
t.Fatalf("rows = %d, want 2 after two refreshes of the same source", len(got))
|
||||
}
|
||||
|
||||
// 替换只影响同一来源:另一个来源的数据必须保留。
|
||||
other := []model.MediaSegment{
|
||||
{MediaID: "m-1", Kind: model.SegmentKindIntro, StartMs: 10, EndMs: 20, Source: "manual"},
|
||||
}
|
||||
if err := repos.MediaSegment.ReplaceForMedia(ctx, "m-1", "manual", other); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
got, err = repos.MediaSegment.ListByMedia(ctx, "m-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(got) != 3 {
|
||||
t.Fatalf("rows = %d, want 3 (2 theintrodb + 1 manual)", len(got))
|
||||
}
|
||||
if got[0].Source != "manual" || got[0].StartMs != 10 {
|
||||
t.Fatalf("rows should be ordered by start_ms, got first = %#v", got[0])
|
||||
}
|
||||
}
|
||||
|
||||
func TestReplaceForMediaAllowsSameRangeFromDifferentSources(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
span := model.MediaSegment{MediaID: "m-1", Kind: model.SegmentKindIntro, StartMs: 1_000, EndMs: 2_000}
|
||||
|
||||
provider := span
|
||||
provider.Source = "theintrodb"
|
||||
if err := repos.MediaSegment.ReplaceForMedia(ctx, "m-1", "theintrodb", []model.MediaSegment{provider}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
// 人工修正给出完全相同的区间:唯一索引含 source,两个来源必须能共存。
|
||||
manual := span
|
||||
manual.Source = "manual"
|
||||
if err := repos.MediaSegment.ReplaceForMedia(ctx, "m-1", "manual", []model.MediaSegment{manual}); err != nil {
|
||||
t.Fatalf("same range from another source: %v", err)
|
||||
}
|
||||
got, err := repos.MediaSegment.ListByMedia(ctx, "m-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(got) != 2 {
|
||||
t.Fatalf("rows = %d, want 2 (one per source)", len(got))
|
||||
}
|
||||
}
|
||||
|
||||
func TestReplaceForMediaClearsRowsWhenLookupReturnsNothing(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
|
||||
rows := []model.MediaSegment{
|
||||
{MediaID: "m-1", Kind: model.SegmentKindIntro, StartMs: 1_000, EndMs: 2_000, Source: "theintrodb"},
|
||||
}
|
||||
if err := repos.MediaSegment.ReplaceForMedia(ctx, "m-1", "theintrodb", rows); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
// 提供方后来把这段数据删掉了,本地必须跟着清空,否则会一直跳一个不存在的片头。
|
||||
if err := repos.MediaSegment.ReplaceForMedia(ctx, "m-1", "theintrodb", nil); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
got, err := repos.MediaSegment.ListByMedia(ctx, "m-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(got) != 0 {
|
||||
t.Fatalf("rows = %d, want 0 after an empty refresh", len(got))
|
||||
}
|
||||
}
|
||||
|
||||
func TestUpsertFetchKeepsOneRowPerMediaAndSource(t *testing.T) {
|
||||
repos := newSegmentTestRepos(t)
|
||||
ctx := t.Context()
|
||||
now := time.Now()
|
||||
|
||||
if err := repos.MediaSegment.UpsertFetch(ctx, &model.MediaSegmentFetch{
|
||||
MediaID: "m-1", Source: "theintrodb", FetchedAt: now, Found: false,
|
||||
}); err != nil {
|
||||
t.Fatalf("first upsert: %v", err)
|
||||
}
|
||||
got, err := repos.MediaSegment.GetFetch(ctx, "m-1", "theintrodb")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got == nil || got.Found {
|
||||
t.Fatalf("first lookup should be recorded as a miss, got %#v", got)
|
||||
}
|
||||
|
||||
later := now.Add(time.Hour)
|
||||
if err := repos.MediaSegment.UpsertFetch(ctx, &model.MediaSegmentFetch{
|
||||
MediaID: "m-1", Source: "theintrodb", FetchedAt: later, Found: true,
|
||||
}); err != nil {
|
||||
t.Fatalf("second upsert: %v", err)
|
||||
}
|
||||
var count int64
|
||||
if err := repos.DB.Model(&model.MediaSegmentFetch{}).
|
||||
Where("media_id = ? AND source = ?", "m-1", "theintrodb").Count(&count).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if count != 1 {
|
||||
t.Fatalf("fetch ledger rows = %d, want 1", count)
|
||||
}
|
||||
got, err = repos.MediaSegment.GetFetch(ctx, "m-1", "theintrodb")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got == nil || !got.Found {
|
||||
t.Fatalf("ledger should be updated in place, got %#v", got)
|
||||
}
|
||||
}
|
||||
@@ -15,6 +15,8 @@ type Container struct {
|
||||
Media *MediaRepository
|
||||
Series *SeriesRepository
|
||||
History *HistoryRepository
|
||||
MediaSegment *MediaSegmentRepository
|
||||
MediaProbe *MediaProbeRepository
|
||||
Favorite *FavoriteRepository
|
||||
Playlist *PlaylistRepository
|
||||
Setting *SettingRepository
|
||||
@@ -45,6 +47,8 @@ func New(db *gorm.DB) *Container {
|
||||
Media: &MediaRepository{db: db},
|
||||
Series: &SeriesRepository{db: db},
|
||||
History: &HistoryRepository{db: db},
|
||||
MediaSegment: &MediaSegmentRepository{db: db},
|
||||
MediaProbe: &MediaProbeRepository{db: db},
|
||||
Favorite: &FavoriteRepository{db: db},
|
||||
Playlist: &PlaylistRepository{db: db},
|
||||
Setting: &SettingRepository{db: db},
|
||||
|
||||
@@ -21,14 +21,24 @@ func (s *DeviceService) KickDevice(ctx context.Context, userID, deviceID string)
|
||||
return fmt.Errorf("device not found")
|
||||
}
|
||||
if fp := strings.TrimSpace(d.Fingerprint); fp != "" {
|
||||
return s.repo.UserDevice.SetKickedByFingerprint(ctx, userID, fp, true)
|
||||
err = s.repo.UserDevice.SetKickedByFingerprint(ctx, userID, fp, true)
|
||||
} else {
|
||||
err = s.repo.UserDevice.SetKicked(ctx, d.ID, true)
|
||||
}
|
||||
return s.repo.UserDevice.SetKicked(ctx, d.ID, true)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
s.notify(ctx, userID, fmt.Sprintf("🔌 设备已下线:<b>%s</b>\n该终端需要重新登录后才能继续使用。", deviceLabel(d.DeviceName, d.Client)))
|
||||
return nil
|
||||
}
|
||||
|
||||
// KickAllDevices marks all devices for a user as kicked.
|
||||
func (s *DeviceService) KickAllDevices(ctx context.Context, userID string) error {
|
||||
return s.repo.UserDevice.SetKickedByUser(ctx, userID, true)
|
||||
if err := s.repo.UserDevice.SetKickedByUser(ctx, userID, true); err != nil {
|
||||
return err
|
||||
}
|
||||
s.notify(ctx, userID, "🔌 你名下的全部设备已下线,需要重新登录后才能继续使用。")
|
||||
return nil
|
||||
}
|
||||
|
||||
// ListDevices returns the device sessions for a user.
|
||||
|
||||
@@ -0,0 +1,155 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"strings"
|
||||
"testing"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
func newDeviceServiceForTest(t *testing.T) (*DeviceService, *repository.Container, string) {
|
||||
t.Helper()
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
const userID = "user-1"
|
||||
if err := repos.User.Create(context.Background(), &model.User{
|
||||
Base: model.Base{ID: userID},
|
||||
Username: "tester",
|
||||
PasswordHash: "x",
|
||||
Role: "user",
|
||||
IsActive: true,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
svc := NewDeviceService(zap.NewNop(), repos)
|
||||
svc.SetSessionTracker(NewSessionTrackerService(zap.NewNop()))
|
||||
return svc, repos, userID
|
||||
}
|
||||
|
||||
// 新终端首次登录必须通知用户,否则「谁在用我的账号」永远无从察觉。
|
||||
func TestRecordLoginNotifiesOnNewDevice(t *testing.T) {
|
||||
svc, _, userID := newDeviceServiceForTest(t)
|
||||
|
||||
type call struct{ userID, text string }
|
||||
var calls []call
|
||||
svc.SetNotifier(func(_ context.Context, uid, text string) {
|
||||
calls = append(calls, call{uid, text})
|
||||
})
|
||||
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone", "Infuse", "1.2.3.4")
|
||||
|
||||
if len(calls) != 1 {
|
||||
t.Fatalf("notifier calls = %d, want 1", len(calls))
|
||||
}
|
||||
if calls[0].userID != userID {
|
||||
t.Fatalf("notifier user = %q, want %q", calls[0].userID, userID)
|
||||
}
|
||||
if !strings.Contains(calls[0].text, "新设备") {
|
||||
t.Fatalf("notifier text = %q, want it to mention 新设备", calls[0].text)
|
||||
}
|
||||
}
|
||||
|
||||
// 已知终端重复登录不应刷屏:只在首次建档时通知。
|
||||
func TestRecordLoginDoesNotNotifyOnKnownDevice(t *testing.T) {
|
||||
svc, _, userID := newDeviceServiceForTest(t)
|
||||
|
||||
var count int
|
||||
svc.SetNotifier(func(context.Context, string, string) { count++ })
|
||||
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone", "Infuse", "1.2.3.4")
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone", "Infuse", "1.2.3.4")
|
||||
|
||||
if count != 1 {
|
||||
t.Fatalf("notifier calls = %d, want exactly 1", count)
|
||||
}
|
||||
}
|
||||
|
||||
// 一键踢下线后必须告知用户,否则只会表现为「播放莫名失败」。
|
||||
func TestKickDeviceNotifiesUser(t *testing.T) {
|
||||
svc, _, userID := newDeviceServiceForTest(t)
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone", "Infuse", "1.2.3.4")
|
||||
|
||||
var kickText string
|
||||
svc.SetNotifier(func(_ context.Context, _, text string) { kickText = text })
|
||||
|
||||
if err := svc.KickAllDevices(context.Background(), userID); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if kickText == "" {
|
||||
t.Fatal("expected a notification after kicking devices")
|
||||
}
|
||||
if !strings.Contains(kickText, "已下线") && !strings.Contains(kickText, "踢") {
|
||||
t.Fatalf("kick notification text = %q, want it to describe the kick", kickText)
|
||||
}
|
||||
}
|
||||
|
||||
// 未接线 notifier 时(例如测试环境或 Bot 未配置),所有路径必须保持可用。
|
||||
func TestDeviceServiceWorksWithoutNotifier(t *testing.T) {
|
||||
svc, _, userID := newDeviceServiceForTest(t)
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone", "Infuse", "1.2.3.4")
|
||||
if err := svc.KickAllDevices(context.Background(), userID); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
// 设备指纹警告除通知用户外,管理员也必须同步收到告警。
|
||||
func TestFingerprintWarnNotifiesAdmin(t *testing.T) {
|
||||
svc, repos, userID := newDeviceServiceForTest(t)
|
||||
|
||||
// 启用防共享策略
|
||||
if err := repos.Setting.Set(context.Background(), SettingAntiShareEnabled, "true"); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
type call struct{ text string }
|
||||
var adminCalls []call
|
||||
svc.SetAdminNotifier(func(_ context.Context, text string) {
|
||||
adminCalls = append(adminCalls, call{text})
|
||||
})
|
||||
svc.SetNotifier(func(context.Context, string, string) {}) // 用户通知静默接收
|
||||
|
||||
// 第一次登录注册设备
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone-A", "Infuse", "1.2.3.4")
|
||||
// 同设备 ID 换设备名 → 触发指纹变更警告
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone-B", "Infuse", "1.2.3.4")
|
||||
|
||||
if len(adminCalls) == 0 {
|
||||
t.Fatal("admin must be notified on fingerprint warn")
|
||||
}
|
||||
}
|
||||
|
||||
// 账号因设备策略被禁用时,管理员也必须收到告警。
|
||||
func TestPolicyDisableNotifiesAdmin(t *testing.T) {
|
||||
svc, repos, userID := newDeviceServiceForTest(t)
|
||||
|
||||
// 启用防共享策略,设置最大并发客户端为 1
|
||||
for _, kv := range [][2]string{
|
||||
{SettingAntiShareEnabled, "true"},
|
||||
{SettingMaxLoggedClients, "1"},
|
||||
{SettingClientActiveDays, "30"},
|
||||
} {
|
||||
if err := repos.Setting.Set(context.Background(), kv[0], kv[1]); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
var adminCalls []string
|
||||
svc.SetAdminNotifier(func(_ context.Context, text string) {
|
||||
adminCalls = append(adminCalls, text)
|
||||
})
|
||||
svc.SetNotifier(func(context.Context, string, string) {})
|
||||
|
||||
// 两台不同设备登录,超出上限 → 触发禁用
|
||||
svc.RecordLogin(context.Background(), userID, "dev-1", "Phone", "Infuse", "1.2.3.4")
|
||||
svc.RecordLogin(context.Background(), userID, "dev-2", "TV", "Emby", "1.2.3.5")
|
||||
|
||||
if len(adminCalls) == 0 {
|
||||
t.Fatal("admin must be notified when account is disabled by policy")
|
||||
}
|
||||
if !strings.Contains(adminCalls[0], "禁用") {
|
||||
t.Fatalf("admin notification = %q, want it to mention 禁用", adminCalls[0])
|
||||
}
|
||||
}
|
||||
@@ -5,6 +5,7 @@ import (
|
||||
"crypto/sha256"
|
||||
"encoding/hex"
|
||||
"fmt"
|
||||
"html"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
@@ -34,6 +35,10 @@ type DeviceService struct {
|
||||
// notifyUser sends a Telegram message to the local user (resolved to their
|
||||
// Telegram binding). Wired by the bot service; nil disables notifications.
|
||||
notifyUser func(ctx context.Context, userID, text string)
|
||||
|
||||
// notifyAdmin sends a Telegram message to all admin accounts.
|
||||
// Wired by the bot service; nil disables notifications.
|
||||
notifyAdmin func(ctx context.Context, text string)
|
||||
}
|
||||
|
||||
// NewDeviceService constructs a DeviceService.
|
||||
@@ -46,6 +51,11 @@ func (s *DeviceService) SetNotifier(fn func(ctx context.Context, userID, text st
|
||||
s.notifyUser = fn
|
||||
}
|
||||
|
||||
// SetAdminNotifier wires the admin-broadcast Telegram notification callback.
|
||||
func (s *DeviceService) SetAdminNotifier(fn func(ctx context.Context, text string)) {
|
||||
s.notifyAdmin = fn
|
||||
}
|
||||
|
||||
func (s *DeviceService) SetSessionTracker(tracker *SessionTrackerService) {
|
||||
s.sessions = tracker
|
||||
}
|
||||
@@ -102,6 +112,8 @@ func (s *DeviceService) RecordLogin(ctx context.Context, userID, deviceID, devic
|
||||
FirstSeenAt: now,
|
||||
LastSeenAt: now,
|
||||
})
|
||||
// 新终端首次登录才通知:已知设备重复登录不刷屏。
|
||||
s.notify(ctx, userID, fmt.Sprintf("🔔 新设备登录:<b>%s</b>\n如果这不是你本人,请到「个人资料 → 我的设备」踢下线并修改密码。", deviceLabel(deviceName, client)))
|
||||
} else {
|
||||
if existing.Fingerprint != "" && existing.Fingerprint != fp {
|
||||
mismatch = true
|
||||
@@ -236,7 +248,10 @@ func (s *DeviceService) registerFingerprintWarning(ctx context.Context, userID,
|
||||
"last_share_warn_at": &now,
|
||||
})
|
||||
left := cfg.WarnThreshold + 1 - warnings
|
||||
s.notify(ctx, userID, fmt.Sprintf("⚠️ 账号 <b>%s</b> 触发设备指纹警告:%s\n这是第 <b>%d</b> 次警告,再异常 <b>%d</b> 次将禁用账号。请使用 Bot 的「我的设备」踢下线异常设备。", u.Username, reason, warnings, left))
|
||||
warnText := fmt.Sprintf("⚠️ 账号 <b>%s</b> 触发设备指纹警告:%s\n这是第 <b>%d</b> 次警告,再异常 <b>%d</b> 次将禁用账号。请到「个人资料 → 我的设备」踢下线异常设备。",
|
||||
html.EscapeString(u.Username), html.EscapeString(reason), warnings, left)
|
||||
s.notify(ctx, userID, warnText)
|
||||
s.notifyAdminMsg(ctx, warnText)
|
||||
s.log.Info("anti-share: warning issued", zap.String("user", u.Username), zap.Int("warnings", warnings), zap.String("reason", reason))
|
||||
}
|
||||
|
||||
@@ -255,7 +270,10 @@ func (s *DeviceService) disableForPolicy(ctx context.Context, userID, reason str
|
||||
"last_share_warn_at": &now,
|
||||
})
|
||||
_ = s.repo.UserDevice.SetKickedByUser(ctx, userID, true)
|
||||
s.notify(ctx, userID, fmt.Sprintf("⛔️ 账号 <b>%s</b> 因触发设备规则已被禁用:%s\n请联系管理员解除禁用,或通过「我的设备」踢下线多余设备后再申请恢复。", u.Username, reason))
|
||||
disableText := fmt.Sprintf("⛔️ 账号 <b>%s</b> 因触发设备规则已被禁用:%s\n请联系管理员解除禁用,或通过「个人资料 → 我的设备」踢下线多余设备后再申请恢复。",
|
||||
html.EscapeString(u.Username), html.EscapeString(reason))
|
||||
s.notify(ctx, userID, disableText)
|
||||
s.notifyAdminMsg(ctx, disableText)
|
||||
s.log.Warn("device policy: disabled account", zap.String("user", u.Username), zap.String("reason", reason))
|
||||
}
|
||||
|
||||
@@ -276,6 +294,12 @@ func (s *DeviceService) notify(ctx context.Context, userID, text string) {
|
||||
}
|
||||
}
|
||||
|
||||
func (s *DeviceService) notifyAdminMsg(ctx context.Context, text string) {
|
||||
if s.notifyAdmin != nil {
|
||||
s.notifyAdmin(ctx, text)
|
||||
}
|
||||
}
|
||||
|
||||
func deviceLabel(name, client string) string {
|
||||
name = strings.TrimSpace(name)
|
||||
client = strings.TrimSpace(client)
|
||||
|
||||
@@ -76,6 +76,10 @@ type EmbyService struct {
|
||||
adult *AdultProvider
|
||||
personImageMu sync.RWMutex
|
||||
personImages map[string]string
|
||||
|
||||
// discovery 提供 NextUp / Similar / Genres 的候选集。它只选候选,
|
||||
// DTO 形状仍由本服务统一产出,避免同一部剧在不同接口上长得不一样。
|
||||
discovery *MediaDiscoveryService
|
||||
}
|
||||
|
||||
// NewEmbyService is the constructor.
|
||||
@@ -91,6 +95,26 @@ func (e *EmbyService) SetEmbyRemote(remote *EmbyRemoteService) *EmbyService {
|
||||
return e
|
||||
}
|
||||
|
||||
// SetDiscovery 注入发现类查询服务(NextUp / Similar / Genres)。
|
||||
func (e *EmbyService) SetDiscovery(discovery *MediaDiscoveryService) *EmbyService {
|
||||
if e != nil {
|
||||
e.discovery = discovery
|
||||
}
|
||||
return e
|
||||
}
|
||||
|
||||
// discoveryService 返回发现服务;未注入时按需构造,保证 Emby 接口在任何
|
||||
// 组装顺序下都不会因为缺少注入而返回空结果。
|
||||
func (e *EmbyService) discoveryService() *MediaDiscoveryService {
|
||||
if e == nil {
|
||||
return nil
|
||||
}
|
||||
if e.discovery == nil {
|
||||
e.discovery = NewMediaDiscoveryService(e.log, e.repo)
|
||||
}
|
||||
return e.discovery
|
||||
}
|
||||
|
||||
// SetTMDbProvider wires the TMDb client used for detail-time cast/crew lookup.
|
||||
func (e *EmbyService) SetTMDbProvider(tmdb *TMDbProvider) *EmbyService {
|
||||
if e != nil {
|
||||
|
||||
@@ -1,6 +1,8 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"strings"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
@@ -65,3 +67,133 @@ func TestEmbyLatestItemsOrderByReleaseDate(t *testing.T) {
|
||||
t.Fatalf("latest item should expose PremiereDate for Emby clients: %#v", items[0])
|
||||
}
|
||||
}
|
||||
|
||||
// SimilarItems with a real series_id (not a media table row ID) must return
|
||||
// results instead of an empty list. Before bug-2 fix, Media.FindByID returned
|
||||
// nil for any ID that wasn't a primary-key match in the media table (including
|
||||
// series_id values and virtual msgo-series-* IDs), so SimilarItems always
|
||||
// returned empty for series detail pages.
|
||||
func TestEmbyServiceSimilarItemsSeriesID(t *testing.T) {
|
||||
svc := newTestEmbyService(t)
|
||||
svc.SetDiscovery(NewMediaDiscoveryService(zap.NewNop(), svc.repo))
|
||||
|
||||
lib := model.Library{Name: "TV", Path: "/media/tv", Type: "tv", Enabled: true}
|
||||
if err := svc.repo.Library.Create(context.Background(), &lib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
// Two series with the same genre so they score > 0 for similarity.
|
||||
ep1 := model.Media{
|
||||
LibraryID: lib.ID,
|
||||
SeriesID: "real-series-1",
|
||||
Title: "剧一",
|
||||
Genres: "Action",
|
||||
SeasonNum: 1,
|
||||
EpisodeNum: 1,
|
||||
Path: "/media/tv/s1e1.mkv",
|
||||
}
|
||||
ep2 := model.Media{
|
||||
LibraryID: lib.ID,
|
||||
SeriesID: "real-series-2",
|
||||
Title: "剧二",
|
||||
Genres: "Action",
|
||||
SeasonNum: 1,
|
||||
EpisodeNum: 1,
|
||||
Path: "/media/tv/s2e1.mkv",
|
||||
}
|
||||
for _, m := range []*model.Media{&ep1, &ep2} {
|
||||
if err := svc.repo.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
// "real-series-1" is the series_id stored in the media row but is NOT a
|
||||
// primary key in the media table, so Media.FindByID("real-series-1") returns
|
||||
// nil. SimilarItems must fall back to findSeriesGroup and still return
|
||||
// results.
|
||||
result, err := svc.SimilarItems(context.Background(), "real-series-1", "", 12)
|
||||
if err != nil {
|
||||
t.Fatalf("SimilarItems with series_id: %v", err)
|
||||
}
|
||||
similar, _ := result["Items"].([]map[string]any)
|
||||
if similar == nil {
|
||||
t.Fatal("SimilarItems returned nil items for a series_id that resolves via findSeriesGroup")
|
||||
}
|
||||
// Should contain 剧二 (the only other episodic content with the same genre).
|
||||
found := false
|
||||
for _, item := range similar {
|
||||
if name, _ := item["Name"].(string); strings.Contains(name, "剧二") || strings.Contains(name, "第 1 集") {
|
||||
found = true
|
||||
break
|
||||
}
|
||||
}
|
||||
if !found && len(similar) == 0 {
|
||||
t.Fatalf("SimilarItems returned no results; want at least 剧二 for series real-series-1")
|
||||
}
|
||||
}
|
||||
|
||||
// SimilarItems with a virtual series ID (msgo-series-*) must also work.
|
||||
// Virtual IDs are generated for episodes that have no series_id set.
|
||||
func TestEmbyServiceSimilarItemsVirtualSeriesID(t *testing.T) {
|
||||
svc := newTestEmbyService(t)
|
||||
svc.SetDiscovery(NewMediaDiscoveryService(zap.NewNop(), svc.repo))
|
||||
|
||||
lib := model.Library{Name: "TV2", Path: "/media/tv2", Type: "tv", Enabled: true}
|
||||
if err := svc.repo.Library.Create(context.Background(), &lib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
// Episodes WITHOUT SeriesID → series group gets a virtual msgo-series-* ID.
|
||||
ep1 := model.Media{
|
||||
LibraryID: lib.ID,
|
||||
Title: "虚拟剧一",
|
||||
Genres: "Drama",
|
||||
SeasonNum: 1,
|
||||
EpisodeNum: 1,
|
||||
Path: "/media/tv2/virtual1/S01E01.mkv",
|
||||
}
|
||||
ep2 := model.Media{
|
||||
LibraryID: lib.ID,
|
||||
Title: "虚拟剧二",
|
||||
Genres: "Drama",
|
||||
SeasonNum: 1,
|
||||
EpisodeNum: 1,
|
||||
Path: "/media/tv2/virtual2/S01E01.mkv",
|
||||
}
|
||||
for _, m := range []*model.Media{&ep1, &ep2} {
|
||||
if err := svc.repo.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
// Fetch series items to get the virtual ID for ep1's series.
|
||||
seriesItems, err := svc.Items(context.Background(), ItemsParams{
|
||||
IncludeItemTypes: []string{"Series"},
|
||||
Recursive: true,
|
||||
})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
items, _ := seriesItems["Items"].([]map[string]any)
|
||||
var virtualID string
|
||||
for _, item := range items {
|
||||
id, _ := item["Id"].(string)
|
||||
name, _ := item["Name"].(string)
|
||||
if strings.Contains(name, "虚拟剧一") && strings.HasPrefix(id, embyVirtualSeriesPrefix) {
|
||||
virtualID = id
|
||||
break
|
||||
}
|
||||
}
|
||||
if virtualID == "" {
|
||||
t.Skip("virtual series ID not generated for episodes without series_id in this build")
|
||||
}
|
||||
|
||||
result, err := svc.SimilarItems(context.Background(), virtualID, "", 12)
|
||||
if err != nil {
|
||||
t.Fatalf("SimilarItems with virtual series ID: %v", err)
|
||||
}
|
||||
similar, _ := result["Items"].([]map[string]any)
|
||||
if similar == nil {
|
||||
t.Fatalf("SimilarItems returned nil items for virtual series ID %q", virtualID)
|
||||
}
|
||||
}
|
||||
|
||||
@@ -0,0 +1,342 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"crypto/sha1"
|
||||
"encoding/hex"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
// Emby 发现类接口:NextUp / Similar / Genres。
|
||||
//
|
||||
// 候选集的选取交给 MediaDiscoveryService(纯查询、无 DTO 概念),本文件只做
|
||||
// 「候选 → Emby DTO」的映射,复用 itemPayload 以保证与 /Items 的形状一致。
|
||||
|
||||
const (
|
||||
embyNextUpDefaultLimit = 20
|
||||
embySimilarDefaultLimit = 12
|
||||
embyNextUpMaxLimit = 100
|
||||
embySimilarMaxLimit = 50
|
||||
)
|
||||
|
||||
// NextUp 返回「每部在看的剧的下一集」,即 Emby 客户端首页「接下来播放」的数据源。
|
||||
// seriesID 非空时只返回该剧的下一集(剧集详情页「继续播放」);空则返回全站列表。
|
||||
func (e *EmbyService) NextUp(ctx context.Context, userID, seriesID string, limit int) (map[string]any, error) {
|
||||
if limit <= 0 {
|
||||
limit = embyNextUpDefaultLimit
|
||||
}
|
||||
if limit > embyNextUpMaxLimit {
|
||||
limit = embyNextUpMaxLimit
|
||||
}
|
||||
if strings.TrimSpace(userID) == "" {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
seriesID = strings.TrimSpace(seriesID)
|
||||
discovery := e.discoveryService()
|
||||
if discovery == nil {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
|
||||
if seriesID != "" {
|
||||
return e.nextUpForSeries(ctx, userID, seriesID, limit)
|
||||
}
|
||||
|
||||
rows, err := discovery.NextUpCandidates(ctx, userID, limit, e.mediaVisibility(ctx, userID))
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
// Bug 3 fix: use payloadsForMedia which attaches the request-scoped payload
|
||||
// cache (withPayloadCache + prefetchPayloadCache) to avoid N+1 DB queries.
|
||||
items, err := e.payloadsForMedia(ctx, rows, userID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return map[string]any{
|
||||
"Items": items,
|
||||
"TotalRecordCount": int64(len(items)),
|
||||
}, nil
|
||||
}
|
||||
|
||||
// nextUpForSeries 只解析指定剧的下一集。远程挂载剧集按本机播放历史 + 远程
|
||||
// 分集列表计算,避免把其它本地剧的 NextUp 塞进详情页继续播放按钮。
|
||||
func (e *EmbyService) nextUpForSeries(ctx context.Context, userID, seriesID string, limit int) (map[string]any, error) {
|
||||
if IsEmbyRemoteID(seriesID) {
|
||||
return e.nextUpForRemoteSeries(ctx, userID, seriesID, limit)
|
||||
}
|
||||
discovery := e.discoveryService()
|
||||
if discovery == nil {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
// 多取候选再按 SeriesId 精确过滤,避免「全站 TopN」把目标剧挤掉。
|
||||
scanLimit := embyNextUpMaxLimit
|
||||
if limit > scanLimit {
|
||||
scanLimit = limit
|
||||
}
|
||||
rows, err := discovery.NextUpCandidates(ctx, userID, scanLimit, e.mediaVisibility(ctx, userID))
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
items, err := e.payloadsForMedia(ctx, rows, userID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
filtered := make([]map[string]any, 0, 1)
|
||||
for _, item := range items {
|
||||
itemSeries, _ := item["SeriesId"].(string)
|
||||
if itemSeries == seriesID {
|
||||
filtered = append(filtered, item)
|
||||
if len(filtered) >= limit {
|
||||
break
|
||||
}
|
||||
}
|
||||
}
|
||||
return map[string]any{
|
||||
"Items": filtered,
|
||||
"TotalRecordCount": int64(len(filtered)),
|
||||
}, nil
|
||||
}
|
||||
|
||||
// nextUpForRemoteSeries 用 MeBox 本地播放历史在远程剧的分集里找「下一集」。
|
||||
// 不透传远程账号的 NextUp,避免多用户共用挂载账号时串进度。
|
||||
func (e *EmbyService) nextUpForRemoteSeries(ctx context.Context, userID, seriesID string, limit int) (map[string]any, error) {
|
||||
if e == nil || e.remote == nil || strings.TrimSpace(userID) == "" {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
if limit <= 0 {
|
||||
limit = 1
|
||||
}
|
||||
mountID, remoteSeriesID, ok := DecodeEmbyRemoteID(seriesID)
|
||||
if !ok {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
mount, acct, err := e.remote.ResolveMount(ctx, mountID)
|
||||
if err != nil || mount == nil || acct == nil {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
if !EmbyMountLibraryAllowed(e.mediaVisibility(ctx, userID), mount) {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
|
||||
prefix := EmbyRemoteIDPrefix + mountID + "~"
|
||||
var hist []model.PlaybackHistory
|
||||
if err := e.repo.DB.WithContext(ctx).
|
||||
Where("user_id = ? AND position_ms > 0 AND media_id LIKE ?", userID, prefix+"%").
|
||||
Order("watched_at desc").
|
||||
Limit(nextUpHistoryScanLimit).
|
||||
Find(&hist).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if len(hist) == 0 {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
|
||||
episodes, err := e.remote.RemoteEpisodes(ctx, mount, acct, remoteSeriesID)
|
||||
if err != nil || len(episodes) == 0 {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
epByID := make(map[string]*model.Media, len(episodes))
|
||||
for i := range episodes {
|
||||
epByID[episodes[i].ID] = &episodes[i]
|
||||
}
|
||||
|
||||
var current *model.Media
|
||||
currentCompleted := false
|
||||
for i := range hist {
|
||||
if m := epByID[hist[i].MediaID]; m != nil {
|
||||
current = m
|
||||
currentCompleted = hist[i].Completed
|
||||
break
|
||||
}
|
||||
}
|
||||
if current == nil {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
|
||||
completed := map[string]bool{}
|
||||
epIDs := make([]string, 0, len(episodes))
|
||||
for i := range episodes {
|
||||
epIDs = append(epIDs, episodes[i].ID)
|
||||
}
|
||||
var done []model.PlaybackHistory
|
||||
if err := e.repo.DB.WithContext(ctx).
|
||||
Where("user_id = ? AND completed = ? AND media_id IN ?", userID, true, epIDs).
|
||||
Find(&done).Error; err == nil {
|
||||
for _, h := range done {
|
||||
completed[h.MediaID] = true
|
||||
}
|
||||
}
|
||||
|
||||
next, ok := pickNextEpisode(episodes, current, currentCompleted, completed)
|
||||
if !ok {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
_, remoteEpID, ok := DecodeEmbyRemoteID(next.ID)
|
||||
if !ok {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
item, err := e.remote.RemoteItem(ctx, mount, acct, remoteEpID)
|
||||
if err != nil || item == nil {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
if err := e.mergeRemoteUserData(ctx, userID, item); err != nil {
|
||||
return nil, err
|
||||
}
|
||||
items := []map[string]any{item}
|
||||
if limit < len(items) {
|
||||
items = items[:limit]
|
||||
}
|
||||
return map[string]any{
|
||||
"Items": items,
|
||||
"TotalRecordCount": int64(len(items)),
|
||||
}, nil
|
||||
}
|
||||
|
||||
// SimilarItems 返回与指定条目相似的本地媒体。
|
||||
//
|
||||
// 找不到条目(或该条目对当前用户不可见)时返回空列表而不是错误:客户端会在
|
||||
// 详情页无条件请求它,404/500 会让客户端把条目判定为不完整。
|
||||
func (e *EmbyService) SimilarItems(ctx context.Context, mediaID, userID string, limit int) (map[string]any, error) {
|
||||
if limit <= 0 {
|
||||
limit = embySimilarDefaultLimit
|
||||
}
|
||||
if limit > embySimilarMaxLimit {
|
||||
limit = embySimilarMaxLimit
|
||||
}
|
||||
discovery := e.discoveryService()
|
||||
if discovery == nil || strings.TrimSpace(mediaID) == "" {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
|
||||
// 详情页每次打开都会请求相似推荐,而重建要走「取候选池 + 内存打分」
|
||||
// (实测冷 340ms / 热 70ms)。推荐列表短暂陈旧无害,用短 TTL 缓存,
|
||||
// 新建库或换用户都会因为键名不同而自然隔离。
|
||||
cacheKey := e.embySimilarCacheKey(mediaID, userID, limit)
|
||||
if e.cache != nil {
|
||||
var cached map[string]any
|
||||
if e.cache.GetJSON(ctx, cacheKey, &cached) && cached != nil {
|
||||
if _, ok := cached["Items"]; ok {
|
||||
return cached, nil
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// Bug 2 fix: resolve virtual series IDs (msgo-series-*) and real series
|
||||
// table IDs to a representative episode so SimilarCandidates (which calls
|
||||
// Media.FindByID) can seed similarity from concrete media metadata.
|
||||
resolvedID := mediaID
|
||||
if strings.HasPrefix(mediaID, embyVirtualSeriesPrefix) {
|
||||
series, ok, err := e.findSeriesGroup(ctx, mediaID, userID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if !ok || len(series.Episodes) == 0 {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
resolvedID = series.Episodes[0].ID
|
||||
} else if e.repo != nil && e.repo.Media != nil {
|
||||
// For non-virtual IDs that are series-level (not in media table), also
|
||||
// resolve via findSeriesGroup so the seed row can be found.
|
||||
m, err := e.repo.Media.FindByID(ctx, mediaID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if m == nil {
|
||||
series, ok, err := e.findSeriesGroup(ctx, mediaID, userID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if !ok || len(series.Episodes) == 0 {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
resolvedID = series.Episodes[0].ID
|
||||
}
|
||||
}
|
||||
|
||||
rows, err := discovery.SimilarCandidates(ctx, resolvedID, limit, e.mediaVisibility(ctx, userID))
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
// Bug 3 fix: use payloadsForMedia which attaches the request-scoped payload
|
||||
// cache (withPayloadCache + prefetchPayloadCache) to avoid N+1 DB queries.
|
||||
items, err := e.payloadsForMedia(ctx, rows, userID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
out := map[string]any{
|
||||
"Items": items,
|
||||
"TotalRecordCount": int64(len(items)),
|
||||
}
|
||||
if e.cache != nil {
|
||||
e.cache.SetJSON(ctx, cacheKey, out, embySimilarCacheTTL)
|
||||
}
|
||||
return out, nil
|
||||
}
|
||||
|
||||
// embySimilarCacheTTL 是「相似推荐」结果的缓存时长。列表只是推荐,短暂陈旧
|
||||
// 无害;TTL 取短一些,让新入库的内容尽快出现。
|
||||
const embySimilarCacheTTL = 2 * time.Minute
|
||||
|
||||
// Genres 返回类型清单。parentID 非空时(客户端按媒体库浏览类型)只统计该库。
|
||||
func (e *EmbyService) Genres(ctx context.Context, userID, parentID string) (map[string]any, error) {
|
||||
discovery := e.discoveryService()
|
||||
if discovery == nil {
|
||||
return emptyItemsEnvelope(0), nil
|
||||
}
|
||||
|
||||
libraryID := ""
|
||||
if trimmed := strings.TrimSpace(parentID); trimmed != "" {
|
||||
// 只有本地的真实库 ID 才能用于收窄;虚拟视图 ID(Emby 客户端自己的
|
||||
// 视图标识)收窄后会得到空结果,因此识别不出来时按全库统计。
|
||||
if e.libraryExists(ctx, trimmed) {
|
||||
libraryID = trimmed
|
||||
}
|
||||
}
|
||||
|
||||
genres, err := discovery.AggregateGenres(ctx, e.mediaVisibility(ctx, userID), libraryID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
items := make([]map[string]any, 0, len(genres))
|
||||
for _, genre := range genres {
|
||||
items = append(items, map[string]any{
|
||||
"Id": embyGenreID(genre.Name),
|
||||
"Name": genre.Name,
|
||||
"ItemCount": genre.Count,
|
||||
"Type": "Genre",
|
||||
"ServerId": embyServerID,
|
||||
"IsFolder": false,
|
||||
"CanDelete": false,
|
||||
"CanDownload": false,
|
||||
"ImageTags": map[string]any{},
|
||||
"BackdropImageTags": []any{},
|
||||
})
|
||||
}
|
||||
return map[string]any{
|
||||
"Items": items,
|
||||
"TotalRecordCount": int64(len(items)),
|
||||
}, nil
|
||||
}
|
||||
|
||||
// libraryExists 判断 ID 是否对应本地媒体库。
|
||||
func (e *EmbyService) libraryExists(ctx context.Context, id string) bool {
|
||||
if e == nil || e.repo == nil || e.repo.Library == nil {
|
||||
return false
|
||||
}
|
||||
lib, err := e.repo.Library.FindByID(ctx, id)
|
||||
if err != nil {
|
||||
return false
|
||||
}
|
||||
return lib != nil
|
||||
}
|
||||
|
||||
// embyGenreID 为类型生成稳定的虚拟 ID。
|
||||
//
|
||||
// 客户端会把 Id 当作条目去请求图片/详情,直接用类型名会带上空格与非 ASCII
|
||||
// 字符,因此用固定前缀 + 名称哈希;同一个名称永远得到同一个 ID。
|
||||
func embyGenreID(name string) string {
|
||||
sum := sha1.Sum([]byte(strings.ToLower(strings.TrimSpace(name))))
|
||||
return "msgo-genre-" + hex.EncodeToString(sum[:])[:16]
|
||||
}
|
||||
@@ -67,6 +67,15 @@ func (e *EmbyService) embyLatestCacheKey(userID, parentID string, limit int) str
|
||||
return "media:emby:" + hex.EncodeToString(sum[:])
|
||||
}
|
||||
|
||||
// embySimilarCacheKey 是「相似推荐」结果的缓存键。
|
||||
//
|
||||
// userID 必须参与键名:候选集的可见性(AllowedLibraryIDs、NSFW)由用户决定,
|
||||
// 混用会把别的用户可见的条目推荐给当前用户。limit 同理影响结果条数与排序。
|
||||
func (e *EmbyService) embySimilarCacheKey(mediaID, userID string, limit int) string {
|
||||
sum := sha256.Sum256([]byte(strings.Join([]string{"similar-v1", mediaID, userID, strconv.Itoa(limit)}, "|")))
|
||||
return "media:emby:" + hex.EncodeToString(sum[:])
|
||||
}
|
||||
|
||||
// defaultEmbyLatestCacheTTLSeconds 是 Emby「最新添加」缓存的兜底时长。
|
||||
const defaultEmbyLatestCacheTTLSeconds = 300
|
||||
|
||||
|
||||
@@ -299,8 +299,14 @@ func embyLatestSeriesRowLimit(limit int) int {
|
||||
}
|
||||
|
||||
// ResumeItems 列出有未完成播放进度的媒体。
|
||||
func (e *EmbyService) ResumeItems(ctx context.Context, userID string, limit int) (map[string]any, error) {
|
||||
return e.resumableItems(ctx, ItemsParams{UserID: userID, Limit: limit})
|
||||
// parentID 非空时收窄到该库 / 该剧(含虚拟 msgo-series-* ID)。
|
||||
func (e *EmbyService) ResumeItems(ctx context.Context, userID, parentID string, limit, startIndex int) (map[string]any, error) {
|
||||
return e.resumableItems(ctx, ItemsParams{
|
||||
UserID: userID,
|
||||
ParentID: strings.TrimSpace(parentID),
|
||||
Limit: limit,
|
||||
StartIndex: startIndex,
|
||||
})
|
||||
}
|
||||
|
||||
// favoriteItems returns favourited media for Emby clients, including mounted
|
||||
@@ -434,6 +440,30 @@ func favoriteMatchesParent(ctx context.Context, e *EmbyService, parentID, mediaI
|
||||
return wantMountID != "" && gotMountID == wantMountID
|
||||
}
|
||||
|
||||
// resumeMatchesParent 判断续播条目是否属于 ParentId / SeriesId 作用域。
|
||||
// 本地剧集的 series_id 常为空,实际对外 ID 是 msgo-series-* 虚拟 ID,必须用
|
||||
// seriesIDForMedia 对齐,否则按剧收窄永远匹配不上。
|
||||
func resumeMatchesParent(ctx context.Context, e *EmbyService, parentID, libraryID, seriesID string, m *model.Media) bool {
|
||||
if parentID == "" {
|
||||
return true
|
||||
}
|
||||
if libraryID == parentID || seriesID == parentID {
|
||||
return true
|
||||
}
|
||||
if m != nil && e.seriesIDForMedia(ctx, m) == parentID {
|
||||
return true
|
||||
}
|
||||
if m != nil && e.seasonIDForMedia(ctx, m) == parentID {
|
||||
return true
|
||||
}
|
||||
for _, id := range e.mergedLibraryIDs(ctx, parentID) {
|
||||
if id == libraryID {
|
||||
return true
|
||||
}
|
||||
}
|
||||
return false
|
||||
}
|
||||
|
||||
// resumableItems 返回未完成播放进度的媒体(包含本地媒体与挂载的远程媒体),支持分页。
|
||||
func (e *EmbyService) resumableItems(ctx context.Context, p ItemsParams) (map[string]any, error) {
|
||||
if p.Limit <= 0 || p.Limit > 100 {
|
||||
@@ -500,7 +530,7 @@ func (e *EmbyService) resumableItems(ctx context.Context, p ItemsParams) (map[st
|
||||
localTotal, remoteTotal := 0, 0
|
||||
for _, h := range hist {
|
||||
if m, ok := byID[h.MediaID]; ok {
|
||||
if p.ParentID != "" && m.LibraryID != p.ParentID && m.SeriesID != p.ParentID {
|
||||
if p.ParentID != "" && !resumeMatchesParent(ctx, e, p.ParentID, m.LibraryID, m.SeriesID, m) {
|
||||
continue
|
||||
}
|
||||
localTotal++
|
||||
|
||||
@@ -86,6 +86,54 @@ type EmbyRemoteService struct {
|
||||
// (没有它时 URL 恒定,缩略图会永久停留在旧版本)。
|
||||
imageTagMu sync.RWMutex
|
||||
imageTags map[string]string
|
||||
|
||||
// remoteGate 是发往远程 Emby 的并发闸门。第三方客户端刷新首页时会为每个
|
||||
// 远程媒体库各请求一次 /Items/Latest,挂着几十个库就是几十路并发(生产环境
|
||||
// 实测 50 路同时打进来,单个请求被拖到 5s+)。限制在途请求数后单个请求的
|
||||
// 等待时间反而下降,也不会把 2C 小机和对方服务器一起打满。
|
||||
//
|
||||
// nil 表示不限流(测试直接构造结构体时走这条路)。
|
||||
remoteGate chan struct{}
|
||||
}
|
||||
|
||||
// embyRemoteConcurrencyLimit 是同时发往远程 Emby 的请求数上限。
|
||||
const embyRemoteConcurrencyLimit = 8
|
||||
|
||||
// enterRemoteGate 取得一个远程请求名额,返回释放函数。未配置闸门时返回空操作。
|
||||
func (r *EmbyRemoteService) enterRemoteGate(ctx context.Context) (func(), error) {
|
||||
if r == nil || r.remoteGate == nil {
|
||||
return func() {}, nil
|
||||
}
|
||||
select {
|
||||
case r.remoteGate <- struct{}{}:
|
||||
return func() { <-r.remoteGate }, nil
|
||||
case <-ctx.Done():
|
||||
return nil, ctx.Err()
|
||||
}
|
||||
}
|
||||
|
||||
// fetchRemoteBody 在并发闸门内发起请求并读完响应体,返回状态码与字节。
|
||||
func (r *EmbyRemoteService) fetchRemoteBody(ctx context.Context, req *http.Request, path string) (int, []byte, error) {
|
||||
release, err := r.enterRemoteGate(ctx)
|
||||
if err != nil {
|
||||
return 0, nil, err
|
||||
}
|
||||
defer release()
|
||||
resp, err := r.http.Do(req)
|
||||
if err != nil {
|
||||
return 0, nil, redactSensitiveError(fmt.Errorf("请求远程 Emby 失败: %w", err))
|
||||
}
|
||||
defer resp.Body.Close()
|
||||
// 读 8MB+1 以区分"刚好 8MB"与"被截断":截断的 JSON 会让
|
||||
// Unmarshal 报 unexpected end,难以定位;这里显式报错。
|
||||
data, readErr := io.ReadAll(io.LimitReader(resp.Body, (8<<20)+1))
|
||||
if readErr != nil {
|
||||
return resp.StatusCode, nil, readErr
|
||||
}
|
||||
if len(data) > 8<<20 {
|
||||
return resp.StatusCode, data, fmt.Errorf("远程 Emby 响应超过 8MB 上限(路径 %s):请减小分页或 Fields 字段", path)
|
||||
}
|
||||
return resp.StatusCode, data, nil
|
||||
}
|
||||
|
||||
type embyRemotePersonImageRef struct {
|
||||
@@ -113,6 +161,7 @@ func NewEmbyRemoteService(cfg *config.Config, log *zap.Logger, repo *repository.
|
||||
stream: &http.Client{
|
||||
Transport: &embyRemoteTransport{base: http.DefaultTransport},
|
||||
},
|
||||
remoteGate: make(chan struct{}, embyRemoteConcurrencyLimit),
|
||||
}
|
||||
}
|
||||
|
||||
@@ -645,21 +694,11 @@ func (r *EmbyRemoteService) doGetOnLine(ctx context.Context, acct *model.StrmAcc
|
||||
return err
|
||||
}
|
||||
req.Header.Set("X-Emby-Token", cfg.Token)
|
||||
resp, err := r.http.Do(req)
|
||||
status, data, err := r.fetchRemoteBody(ctx, req, path)
|
||||
if err != nil {
|
||||
return redactSensitiveError(fmt.Errorf("请求远程 Emby 失败: %w", err))
|
||||
return err
|
||||
}
|
||||
// 读 8MB+1 以区分"刚好 8MB"与"被截断":截断的 JSON 会让
|
||||
// Unmarshal 报 unexpected end,难以定位;这里显式报错。
|
||||
data, readErr := io.ReadAll(io.LimitReader(resp.Body, (8<<20)+1))
|
||||
resp.Body.Close()
|
||||
if readErr != nil {
|
||||
return readErr
|
||||
}
|
||||
if len(data) > 8<<20 {
|
||||
return fmt.Errorf("远程 Emby 响应超过 8MB 上限(路径 %s):请减小分页或 Fields 字段", path)
|
||||
}
|
||||
if resp.StatusCode == http.StatusUnauthorized && attempt == 0 {
|
||||
if status == http.StatusUnauthorized && attempt == 0 {
|
||||
// 401:只清当前线路的内存 token 并立即重认证;不在此时删除
|
||||
// DB 里的 api_key——①外层还会按线路故障转移(其他线路可能
|
||||
// 存有自己的 token);②纯 api_key 账号删除后无法再认证,一次
|
||||
@@ -673,8 +712,8 @@ func (r *EmbyRemoteService) doGetOnLine(ctx context.Context, acct *model.StrmAcc
|
||||
master.RemoteUserID = cfg.RemoteUserID
|
||||
continue
|
||||
}
|
||||
if resp.StatusCode >= 300 {
|
||||
return redactSensitiveError(fmt.Errorf("远程 Emby 请求失败(%d): %s", resp.StatusCode, strings.TrimSpace(string(data))))
|
||||
if status >= 300 {
|
||||
return redactSensitiveError(fmt.Errorf("远程 Emby 请求失败(%d): %s", status, strings.TrimSpace(string(data))))
|
||||
}
|
||||
if out == nil {
|
||||
return nil
|
||||
@@ -1617,6 +1656,12 @@ func (r *EmbyRemoteService) doMutateOnLine(ctx context.Context, cfg *EmbyRemoteC
|
||||
return err
|
||||
}
|
||||
req.Header.Set("X-Emby-Token", cfg.Token)
|
||||
// 状态同步同样走远程并发闸门:它和首页那批 Latest 请求共用对方服务器。
|
||||
release, err := r.enterRemoteGate(ctx)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
defer release()
|
||||
resp, err := r.http.Do(req)
|
||||
if err != nil {
|
||||
return redactSensitiveError(fmt.Errorf("请求远程 Emby 失败: %w", err))
|
||||
|
||||
@@ -0,0 +1,112 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"sync"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
)
|
||||
|
||||
// 远程 Emby 的并发闸门必须真的把在途请求数压在上限之内:第三方客户端首页会为
|
||||
// 每个远程媒体库各请求一次 /Items/Latest,几十个库就是几十路并发。
|
||||
func TestRemoteGateLimitsConcurrentRequests(t *testing.T) {
|
||||
const gate = 3
|
||||
const requests = 12
|
||||
|
||||
var mu sync.Mutex
|
||||
inflight, peak := 0, 0
|
||||
srv := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
mu.Lock()
|
||||
inflight++
|
||||
if inflight > peak {
|
||||
peak = inflight
|
||||
}
|
||||
mu.Unlock()
|
||||
|
||||
time.Sleep(20 * time.Millisecond)
|
||||
|
||||
mu.Lock()
|
||||
inflight--
|
||||
mu.Unlock()
|
||||
_, _ = w.Write([]byte(`{"Items":[]}`))
|
||||
}))
|
||||
defer srv.Close()
|
||||
|
||||
svc := &EmbyRemoteService{http: srv.Client(), remoteGate: make(chan struct{}, gate)}
|
||||
|
||||
var wg sync.WaitGroup
|
||||
for i := 0; i < requests; i++ {
|
||||
wg.Add(1)
|
||||
go func() {
|
||||
defer wg.Done()
|
||||
req, err := http.NewRequestWithContext(context.Background(), http.MethodGet, srv.URL+"/Items/Latest", nil)
|
||||
if err != nil {
|
||||
return
|
||||
}
|
||||
if _, _, err := svc.fetchRemoteBody(context.Background(), req, "/Items/Latest"); err != nil {
|
||||
t.Errorf("fetchRemoteBody: %v", err)
|
||||
}
|
||||
}()
|
||||
}
|
||||
wg.Wait()
|
||||
|
||||
mu.Lock()
|
||||
defer mu.Unlock()
|
||||
if peak == 0 {
|
||||
t.Fatal("test server never saw a request")
|
||||
}
|
||||
if peak > gate {
|
||||
t.Fatalf("peak concurrency = %d, want <= %d", peak, gate)
|
||||
}
|
||||
}
|
||||
|
||||
// 闸门排队时要响应请求取消,不能把整个 HTTP 请求挂死。
|
||||
func TestRemoteGateHonoursContextCancellation(t *testing.T) {
|
||||
svc := &EmbyRemoteService{remoteGate: make(chan struct{}, 1)}
|
||||
svc.remoteGate <- struct{}{} // 占满名额
|
||||
|
||||
ctx, cancel := context.WithCancel(context.Background())
|
||||
cancel()
|
||||
if _, err := svc.enterRemoteGate(ctx); !errors.Is(err, context.Canceled) {
|
||||
t.Fatalf("err = %v, want context.Canceled", err)
|
||||
}
|
||||
|
||||
// 释放名额后必须能正常拿到。
|
||||
<-svc.remoteGate
|
||||
release, err := svc.enterRemoteGate(context.Background())
|
||||
if err != nil {
|
||||
t.Fatalf("enterRemoteGate after release: %v", err)
|
||||
}
|
||||
release()
|
||||
if len(svc.remoteGate) != 0 {
|
||||
t.Fatalf("gate leaked a permit: len = %d", len(svc.remoteGate))
|
||||
}
|
||||
}
|
||||
|
||||
// 未配置闸门(测试里直接构造结构体)时不应限流,保持旧行为。
|
||||
func TestRemoteGateAbsentIsUnlimited(t *testing.T) {
|
||||
svc := &EmbyRemoteService{}
|
||||
release, err := svc.enterRemoteGate(context.Background())
|
||||
if err != nil {
|
||||
t.Fatalf("enterRemoteGate: %v", err)
|
||||
}
|
||||
release()
|
||||
}
|
||||
|
||||
// 生产路径构造出来的服务必须带闸门,否则上面的限制形同虚设。
|
||||
func TestNewEmbyRemoteServiceInitialisesGate(t *testing.T) {
|
||||
svc := NewEmbyRemoteService(&config.Config{}, zap.NewNop(), nil, nil)
|
||||
if svc.remoteGate == nil {
|
||||
t.Fatal("remoteGate must be initialised by the constructor")
|
||||
}
|
||||
if cap(svc.remoteGate) != embyRemoteConcurrencyLimit {
|
||||
t.Fatalf("gate capacity = %d, want %d", cap(svc.remoteGate), embyRemoteConcurrencyLimit)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,240 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"strconv"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// 回归:挂载的远程 Emby 剧集里,只看了几秒就退出的那一集必须仍是 NextUp 的结果。
|
||||
// 客户端(Yamby 等)剧集详情页的「继续播放」直接取 NextUp 第一条,跳集会播错集。
|
||||
func TestMountedRemoteNextUpKeepsPartiallyWatchedEpisode(t *testing.T) {
|
||||
episode := func(id string, index int) map[string]any {
|
||||
return map[string]any{
|
||||
"Id": id,
|
||||
"Name": "第" + strconv.Itoa(index) + "集",
|
||||
"Type": "Episode",
|
||||
"SeriesId": "series-100",
|
||||
"ParentIndexNumber": 1,
|
||||
"IndexNumber": index,
|
||||
"RunTimeTicks": 14400640000,
|
||||
}
|
||||
}
|
||||
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
switch r.URL.Path {
|
||||
case "/emby/Users/uid-1/Items/series-100":
|
||||
_ = json.NewEncoder(w).Encode(map[string]any{"Id": "series-100", "Name": "剧一", "Type": "Series"})
|
||||
case "/emby/Users/uid-1/Items/ep-2":
|
||||
_ = json.NewEncoder(w).Encode(episode("ep-2", 2))
|
||||
case "/emby/Users/uid-1/Items":
|
||||
q := r.URL.Query()
|
||||
if q.Get("IncludeItemTypes") != "Episode" || q.Get("ParentId") != "series-100" {
|
||||
w.WriteHeader(http.StatusBadRequest)
|
||||
return
|
||||
}
|
||||
_ = json.NewEncoder(w).Encode(map[string]any{
|
||||
"TotalRecordCount": 3,
|
||||
"Items": []map[string]any{
|
||||
episode("ep-1", 1),
|
||||
episode("ep-2", 2),
|
||||
episode("ep-3", 3),
|
||||
},
|
||||
})
|
||||
default:
|
||||
w.WriteHeader(http.StatusNotFound)
|
||||
}
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
db := newServiceTestDB(t, &model.StrmAccount{}, &model.EmbyMount{}, &model.PlaybackHistory{}, &model.User{})
|
||||
repos := repository.New(db)
|
||||
|
||||
cfg := &config.Config{}
|
||||
remote := NewEmbyRemoteService(cfg, zap.NewNop(), repos, NewCryptoService("", zap.NewNop()))
|
||||
svc := NewEmbyService(cfg, zap.NewNop(), repos).SetEmbyRemote(remote)
|
||||
|
||||
rawConfig, _ := json.Marshal(map[string]string{
|
||||
"url": server.URL,
|
||||
"api_key": "test-api-key",
|
||||
"remote_user_id": "uid-1",
|
||||
})
|
||||
acct := &model.StrmAccount{
|
||||
Base: model.Base{ID: "acct-1"},
|
||||
Name: "远程 Emby",
|
||||
Provider: model.StrmProviderEmbyRemote,
|
||||
Config: string(rawConfig),
|
||||
Enabled: true,
|
||||
}
|
||||
if err := repos.StrmAccount.Create(t.Context(), acct); err != nil {
|
||||
t.Fatalf("create account: %v", err)
|
||||
}
|
||||
mount := &model.EmbyMount{
|
||||
Base: model.Base{ID: "mount-1"},
|
||||
AccountID: acct.ID,
|
||||
RemoteViewID: "view-1",
|
||||
RemoteViewName: "新番连载",
|
||||
CollectionType: "tvshows",
|
||||
Enabled: true,
|
||||
}
|
||||
if err := repos.EmbyMount.Create(t.Context(), mount); err != nil {
|
||||
t.Fatalf("create mount: %v", err)
|
||||
}
|
||||
user := &model.User{
|
||||
Base: model.Base{ID: "user-1"},
|
||||
Username: "viewer",
|
||||
PasswordHash: "x",
|
||||
Role: "user",
|
||||
Tier: "free",
|
||||
IsActive: true,
|
||||
}
|
||||
if err := repos.User.Create(t.Context(), user); err != nil {
|
||||
t.Fatalf("create user: %v", err)
|
||||
}
|
||||
|
||||
// 第 2 集只播了 3.5 秒就退出:有进度、未标记看完。
|
||||
if err := repos.DB.Create(&model.PlaybackHistory{
|
||||
UserID: user.ID,
|
||||
MediaID: EncodeEmbyRemoteID(mount.ID, "ep-2"),
|
||||
PositionMs: 3582,
|
||||
DurationMs: 1440064,
|
||||
WatchedAt: time.Now(),
|
||||
Completed: false,
|
||||
}).Error; err != nil {
|
||||
t.Fatalf("create history: %v", err)
|
||||
}
|
||||
|
||||
envelope, err := svc.NextUp(t.Context(), user.ID, EncodeEmbyRemoteID(mount.ID, "series-100"), 1)
|
||||
if err != nil {
|
||||
t.Fatalf("NextUp: %v", err)
|
||||
}
|
||||
items, _ := envelope["Items"].([]map[string]any)
|
||||
if len(items) != 1 {
|
||||
t.Fatalf("items = %d, want 1 (%#v)", len(items), envelope)
|
||||
}
|
||||
wantID := EncodeEmbyRemoteID(mount.ID, "ep-2")
|
||||
if id, _ := items[0]["Id"].(string); id != wantID {
|
||||
t.Fatalf("Id = %q, want %q (未看完的那一集不能被跳过)", id, wantID)
|
||||
}
|
||||
userData, _ := items[0]["UserData"].(map[string]any)
|
||||
if ticks, _ := userData["PlaybackPositionTicks"].(int64); ticks != 35820000 {
|
||||
t.Fatalf("PlaybackPositionTicks = %#v, want 35820000 (详情页要能续播到 3.5 秒)", userData["PlaybackPositionTicks"])
|
||||
}
|
||||
}
|
||||
|
||||
// 远程剧集已看完当前一集时,NextUp 仍要指向下一集。
|
||||
func TestMountedRemoteNextUpAfterCompletedEpisode(t *testing.T) {
|
||||
episode := func(id string, index int) map[string]any {
|
||||
return map[string]any{
|
||||
"Id": id,
|
||||
"Name": "第" + strconv.Itoa(index) + "集",
|
||||
"Type": "Episode",
|
||||
"SeriesId": "series-100",
|
||||
"ParentIndexNumber": 1,
|
||||
"IndexNumber": index,
|
||||
"RunTimeTicks": 14400640000,
|
||||
}
|
||||
}
|
||||
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
switch r.URL.Path {
|
||||
case "/emby/Users/uid-1/Items/series-100":
|
||||
_ = json.NewEncoder(w).Encode(map[string]any{"Id": "series-100", "Name": "剧一", "Type": "Series"})
|
||||
case "/emby/Users/uid-1/Items/ep-3":
|
||||
_ = json.NewEncoder(w).Encode(episode("ep-3", 3))
|
||||
case "/emby/Users/uid-1/Items":
|
||||
_ = json.NewEncoder(w).Encode(map[string]any{
|
||||
"TotalRecordCount": 3,
|
||||
"Items": []map[string]any{
|
||||
episode("ep-1", 1),
|
||||
episode("ep-2", 2),
|
||||
episode("ep-3", 3),
|
||||
},
|
||||
})
|
||||
default:
|
||||
w.WriteHeader(http.StatusNotFound)
|
||||
}
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
db := newServiceTestDB(t, &model.StrmAccount{}, &model.EmbyMount{}, &model.PlaybackHistory{}, &model.User{})
|
||||
repos := repository.New(db)
|
||||
|
||||
cfg := &config.Config{}
|
||||
remote := NewEmbyRemoteService(cfg, zap.NewNop(), repos, NewCryptoService("", zap.NewNop()))
|
||||
svc := NewEmbyService(cfg, zap.NewNop(), repos).SetEmbyRemote(remote)
|
||||
|
||||
rawConfig, _ := json.Marshal(map[string]string{
|
||||
"url": server.URL,
|
||||
"api_key": "test-api-key",
|
||||
"remote_user_id": "uid-1",
|
||||
})
|
||||
acct := &model.StrmAccount{
|
||||
Base: model.Base{ID: "acct-1"},
|
||||
Name: "远程 Emby",
|
||||
Provider: model.StrmProviderEmbyRemote,
|
||||
Config: string(rawConfig),
|
||||
Enabled: true,
|
||||
}
|
||||
if err := repos.StrmAccount.Create(t.Context(), acct); err != nil {
|
||||
t.Fatalf("create account: %v", err)
|
||||
}
|
||||
mount := &model.EmbyMount{
|
||||
Base: model.Base{ID: "mount-1"},
|
||||
AccountID: acct.ID,
|
||||
RemoteViewID: "view-1",
|
||||
RemoteViewName: "新番连载",
|
||||
CollectionType: "tvshows",
|
||||
Enabled: true,
|
||||
}
|
||||
if err := repos.EmbyMount.Create(t.Context(), mount); err != nil {
|
||||
t.Fatalf("create mount: %v", err)
|
||||
}
|
||||
user := &model.User{
|
||||
Base: model.Base{ID: "user-1"},
|
||||
Username: "viewer",
|
||||
PasswordHash: "x",
|
||||
Role: "user",
|
||||
Tier: "free",
|
||||
IsActive: true,
|
||||
}
|
||||
if err := repos.User.Create(t.Context(), user); err != nil {
|
||||
t.Fatalf("create user: %v", err)
|
||||
}
|
||||
|
||||
// 第 2 集已整集看完。
|
||||
if err := repos.DB.Create(&model.PlaybackHistory{
|
||||
UserID: user.ID,
|
||||
MediaID: EncodeEmbyRemoteID(mount.ID, "ep-2"),
|
||||
PositionMs: 1440064,
|
||||
DurationMs: 1440064,
|
||||
WatchedAt: time.Now(),
|
||||
Completed: true,
|
||||
}).Error; err != nil {
|
||||
t.Fatalf("create history: %v", err)
|
||||
}
|
||||
|
||||
envelope, err := svc.NextUp(context.Background(), user.ID, EncodeEmbyRemoteID(mount.ID, "series-100"), 1)
|
||||
if err != nil {
|
||||
t.Fatalf("NextUp: %v", err)
|
||||
}
|
||||
items, _ := envelope["Items"].([]map[string]any)
|
||||
if len(items) != 1 {
|
||||
t.Fatalf("items = %d, want 1 (%#v)", len(items), envelope)
|
||||
}
|
||||
if id, _ := items[0]["Id"].(string); id != EncodeEmbyRemoteID(mount.ID, "ep-3") {
|
||||
t.Fatalf("Id = %q, want ep-3", id)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,118 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"testing"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
// totalRecordCount 兼容两种来源:直算出来的是 int64,经过进程内缓存 JSON
|
||||
// 往返后是 float64。两者序列化成 Emby 响应时完全一致。
|
||||
func totalRecordCount(t *testing.T, out map[string]any) int {
|
||||
t.Helper()
|
||||
switch v := out["TotalRecordCount"].(type) {
|
||||
case int64:
|
||||
return int(v)
|
||||
case int:
|
||||
return v
|
||||
case float64:
|
||||
return int(v)
|
||||
default:
|
||||
t.Fatalf("unexpected TotalRecordCount type %T (%v)", out["TotalRecordCount"], out["TotalRecordCount"])
|
||||
return 0
|
||||
}
|
||||
}
|
||||
|
||||
// 相似推荐的结果要缓存:详情页每次打开都会请求它,重建要走「取候选池 + 内存打分」
|
||||
// (实测冷 340ms / 热 70ms)。
|
||||
func TestSimilarItemsServesCachedPayload(t *testing.T) {
|
||||
svc := newTestEmbyService(t)
|
||||
repos := svc.repo
|
||||
svc.SetRuntimeCache(NewRuntimeCacheService(&config.Config{}, zap.NewNop()))
|
||||
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
source := seedSimilarMedia(t, repos, libID, "源片", "Action", 2010, 7)
|
||||
seedSimilarMedia(t, repos, libID, "候选甲", "Action", 2010, 7)
|
||||
seedSimilarMedia(t, repos, libID, "候选乙", "Comedy", 2011, 6)
|
||||
|
||||
ctx := context.Background()
|
||||
first, err := svc.SimilarItems(ctx, source.ID, "user-1", 10)
|
||||
if err != nil {
|
||||
t.Fatalf("first SimilarItems: %v", err)
|
||||
}
|
||||
want := totalRecordCount(t, first)
|
||||
if want == 0 {
|
||||
t.Fatalf("first call returned no candidates, test data is wrong: %+v", first)
|
||||
}
|
||||
|
||||
// 把候选全部删掉:第二次如果还返回原结果,只可能是命中缓存。
|
||||
if err := repos.DB.Where("id <> ?", source.ID).Delete(&model.Media{}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
second, err := svc.SimilarItems(ctx, source.ID, "user-1", 10)
|
||||
if err != nil {
|
||||
t.Fatalf("second SimilarItems: %v", err)
|
||||
}
|
||||
if got := totalRecordCount(t, second); got != want {
|
||||
t.Fatalf("cached call returned %d items, want %d (cache miss?)", got, want)
|
||||
}
|
||||
|
||||
// 另一个用户(不同的可见性)不能复用别人的缓存:这里应当重新查询并得到 0。
|
||||
other, err := svc.SimilarItems(ctx, source.ID, "user-2", 10)
|
||||
if err != nil {
|
||||
t.Fatalf("other user SimilarItems: %v", err)
|
||||
}
|
||||
if got := totalRecordCount(t, other); got != 0 {
|
||||
t.Fatalf("other user got %d items, want 0 (per-user cache key)", got)
|
||||
}
|
||||
}
|
||||
|
||||
// limit 不同必须分开缓存,否则一次小 limit 请求会污染后续更大的请求。
|
||||
func TestSimilarItemsCacheSeparatesLimit(t *testing.T) {
|
||||
svc := newTestEmbyService(t)
|
||||
repos := svc.repo
|
||||
svc.SetRuntimeCache(NewRuntimeCacheService(&config.Config{}, zap.NewNop()))
|
||||
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
source := seedSimilarMedia(t, repos, libID, "源片", "Action", 2010, 7)
|
||||
for _, title := range []string{"甲", "乙", "丙", "丁"} {
|
||||
seedSimilarMedia(t, repos, libID, "候选"+title, "Action", 2010, 7)
|
||||
}
|
||||
|
||||
ctx := context.Background()
|
||||
small, err := svc.SimilarItems(ctx, source.ID, "user-1", 2)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got := totalRecordCount(t, small); got != 2 {
|
||||
t.Fatalf("limit=2 returned %d items, want 2", got)
|
||||
}
|
||||
large, err := svc.SimilarItems(ctx, source.ID, "user-1", 4)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if got := totalRecordCount(t, large); got != 4 {
|
||||
t.Fatalf("limit=4 returned %d items, want 4 (limit must be part of the cache key)", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 没有注入缓存时(测试/精简部署)也必须正常工作。
|
||||
func TestSimilarItemsWithoutCacheStillWorks(t *testing.T) {
|
||||
svc := newTestEmbyService(t)
|
||||
libID := seedDiscoveryLibrary(t, svc.repo, "movie")
|
||||
source := seedSimilarMedia(t, svc.repo, libID, "源片", "Action", 2010, 7)
|
||||
seedSimilarMedia(t, svc.repo, libID, "候选甲", "Action", 2010, 7)
|
||||
|
||||
out, err := svc.SimilarItems(context.Background(), source.ID, "user-1", 10)
|
||||
if err != nil {
|
||||
t.Fatalf("SimilarItems: %v", err)
|
||||
}
|
||||
if got := totalRecordCount(t, out); got == 0 {
|
||||
t.Fatalf("expected candidates without a cache, got %+v", out)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,283 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"errors"
|
||||
"fmt"
|
||||
"os/exec"
|
||||
"strconv"
|
||||
"strings"
|
||||
"time"
|
||||
)
|
||||
|
||||
// ffprobeFullTimeout 是一次全量探测(含章节)的超时。远端直链实测 3~4 秒,
|
||||
// 留足余量的同时不能让一个坏源把工作协程永久占住。
|
||||
const ffprobeFullTimeout = 60 * time.Second
|
||||
|
||||
// ProbeInput 是喂给 ffprobe 的输入:本地文件给路径,STRM / 云盘给已解析的最终
|
||||
// 直链加绑定请求头。解析由调用方负责(复用播放链路的换链逻辑),否则会踩到
|
||||
// 115 CDN 的防盗链 403。
|
||||
type ProbeInput struct {
|
||||
Source string
|
||||
Headers map[string]string
|
||||
}
|
||||
|
||||
// ProbeStream 是一路轨道的关键字段,供详情页展示。
|
||||
type ProbeStream struct {
|
||||
Index int `json:"index"`
|
||||
Type string `json:"type"`
|
||||
Codec string `json:"codec,omitempty"`
|
||||
Profile string `json:"profile,omitempty"`
|
||||
Language string `json:"language,omitempty"`
|
||||
Title string `json:"title,omitempty"`
|
||||
Width int `json:"width,omitempty"`
|
||||
Height int `json:"height,omitempty"`
|
||||
PixFmt string `json:"pix_fmt,omitempty"`
|
||||
FrameRate string `json:"frame_rate,omitempty"`
|
||||
Channels int `json:"channels,omitempty"`
|
||||
ChannelLayout string `json:"channel_layout,omitempty"`
|
||||
SampleRate int `json:"sample_rate,omitempty"`
|
||||
BitRate int64 `json:"bit_rate,omitempty"`
|
||||
Default bool `json:"default,omitempty"`
|
||||
Forced bool `json:"forced,omitempty"`
|
||||
}
|
||||
|
||||
// ProbeChapter 是一个内嵌章节区间。
|
||||
type ProbeChapter struct {
|
||||
Index int `json:"index"`
|
||||
StartMs int64 `json:"start_ms"`
|
||||
EndMs int64 `json:"end_ms"`
|
||||
Title string `json:"title,omitempty"`
|
||||
}
|
||||
|
||||
// FullProbeResult 是一次全量探测的裁剪结果。
|
||||
type FullProbeResult struct {
|
||||
Container string
|
||||
DurationSec int
|
||||
BitRate int64
|
||||
Streams []ProbeStream
|
||||
Chapters []ProbeChapter
|
||||
}
|
||||
|
||||
// mediaProbePayload 是落库的媒体信息结构。它只包含白名单字段——刻意不接受
|
||||
// ffprobe 的原始 JSON,因为其中的 format.filename 是播放直链(含签名与
|
||||
// pickcode),原样保存会外泄。
|
||||
type mediaProbePayload struct {
|
||||
Container string `json:"container,omitempty"`
|
||||
DurationSec int `json:"duration_sec"`
|
||||
BitRate int64 `json:"bit_rate,omitempty"`
|
||||
Streams []ProbeStream `json:"streams"`
|
||||
Chapters []ProbeChapter `json:"chapters,omitempty"`
|
||||
}
|
||||
|
||||
// StreamsOfType 返回指定类型的轨道,供详情页分组展示。
|
||||
func (r *FullProbeResult) StreamsOfType(kind string) []ProbeStream {
|
||||
if r == nil {
|
||||
return nil
|
||||
}
|
||||
out := make([]ProbeStream, 0, len(r.Streams))
|
||||
for _, s := range r.Streams {
|
||||
if s.Type == kind {
|
||||
out = append(out, s)
|
||||
}
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// PayloadJSON 序列化落库用的媒体信息。
|
||||
func (r *FullProbeResult) PayloadJSON() (string, error) {
|
||||
if r == nil {
|
||||
return "", nil
|
||||
}
|
||||
streams := r.Streams
|
||||
if streams == nil {
|
||||
streams = []ProbeStream{}
|
||||
}
|
||||
body, err := json.Marshal(mediaProbePayload{
|
||||
Container: r.Container,
|
||||
DurationSec: r.DurationSec,
|
||||
BitRate: r.BitRate,
|
||||
Streams: streams,
|
||||
Chapters: r.Chapters,
|
||||
})
|
||||
if err != nil {
|
||||
return "", err
|
||||
}
|
||||
return string(body), nil
|
||||
}
|
||||
|
||||
// ProbeFull 跑一次全量探测:容器信息 + 全部轨道 + 内嵌章节。
|
||||
//
|
||||
// 与 Probe 的区别:Probe 只取扫描需要的几个字段、对着媒体行的本地路径跑;
|
||||
// ProbeFull 接受调用方解析好的输入(远端直链 + 绑定请求头),并额外抓章节。
|
||||
func (f *FFprobeService) ProbeFull(ctx context.Context, input ProbeInput) (*FullProbeResult, error) {
|
||||
if f == nil || f.cfg == nil {
|
||||
return nil, errors.New("ffprobe service nil")
|
||||
}
|
||||
source := strings.TrimSpace(input.Source)
|
||||
if source == "" {
|
||||
return nil, errors.New("empty probe source")
|
||||
}
|
||||
token, err := f.acquire(ctx)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
defer f.release(token)
|
||||
|
||||
bin, err := resolveLocalExecutable(f.cfg.App.FFprobePath, "ffprobe")
|
||||
if err != nil {
|
||||
return nil, fmt.Errorf("ffprobe unavailable: %w", err)
|
||||
}
|
||||
probeCtx, cancel := context.WithTimeout(ctx, ffprobeFullTimeout)
|
||||
defer cancel()
|
||||
|
||||
args := []string{"-v", "error"}
|
||||
if headerText := ffmpegHeaderText(input.Headers); headerText != "" {
|
||||
args = append(args, "-headers", headerText)
|
||||
}
|
||||
args = append(args,
|
||||
"-print_format", "json",
|
||||
"-show_format",
|
||||
"-show_streams",
|
||||
"-show_chapters",
|
||||
source,
|
||||
)
|
||||
out, err := exec.CommandContext(probeCtx, bin, args...).Output() // #nosec G204 -- bin is resolved by resolveLocalExecutable before execution.
|
||||
if err != nil {
|
||||
return nil, fmt.Errorf("ffprobe full: %w", err)
|
||||
}
|
||||
return parseFullProbeJSON(out)
|
||||
}
|
||||
|
||||
// probeNumber 兼容 ffprobe 把数值输出成字符串或裸数字两种形态
|
||||
// (duration 是字符串,chapter 的 start_time 也可能是数字)。解析不出来就保持
|
||||
// 零值:这些字段都只是展示用,不该因为一个格式差异让整次探测失败。
|
||||
type probeNumber float64
|
||||
|
||||
func (p *probeNumber) UnmarshalJSON(data []byte) error {
|
||||
text := strings.TrimSpace(strings.Trim(string(data), `"`))
|
||||
if text == "" || text == "null" {
|
||||
return nil
|
||||
}
|
||||
value, err := strconv.ParseFloat(text, 64)
|
||||
if err != nil {
|
||||
return nil
|
||||
}
|
||||
*p = probeNumber(value)
|
||||
return nil
|
||||
}
|
||||
|
||||
func (p probeNumber) float() float64 { return float64(p) }
|
||||
func (p probeNumber) int() int { return int(float64(p)) }
|
||||
func (p probeNumber) int64() int64 { return int64(float64(p)) }
|
||||
|
||||
// rawFullProbe 镜像 ffprobe -show_format -show_streams -show_chapters 的输出。
|
||||
// 只声明用得到的字段;format.filename 刻意不声明,避免它进入任何落库路径。
|
||||
type rawFullProbe struct {
|
||||
Format struct {
|
||||
FormatName string `json:"format_name"`
|
||||
Duration probeNumber `json:"duration"`
|
||||
BitRate probeNumber `json:"bit_rate"`
|
||||
} `json:"format"`
|
||||
Streams []struct {
|
||||
Index int `json:"index"`
|
||||
CodecType string `json:"codec_type"`
|
||||
CodecName string `json:"codec_name"`
|
||||
Profile string `json:"profile"`
|
||||
Width int `json:"width"`
|
||||
Height int `json:"height"`
|
||||
PixFmt string `json:"pix_fmt"`
|
||||
AvgFrameRate string `json:"avg_frame_rate"`
|
||||
Channels int `json:"channels"`
|
||||
ChannelLayout string `json:"channel_layout"`
|
||||
SampleRate probeNumber `json:"sample_rate"`
|
||||
BitRate probeNumber `json:"bit_rate"`
|
||||
Tags struct {
|
||||
Language string `json:"language"`
|
||||
Title string `json:"title"`
|
||||
} `json:"tags"`
|
||||
Disposition struct {
|
||||
Default int `json:"default"`
|
||||
Forced int `json:"forced"`
|
||||
} `json:"disposition"`
|
||||
} `json:"streams"`
|
||||
Chapters []struct {
|
||||
StartTime probeNumber `json:"start_time"`
|
||||
EndTime probeNumber `json:"end_time"`
|
||||
Tags struct {
|
||||
Title string `json:"title"`
|
||||
} `json:"tags"`
|
||||
} `json:"chapters"`
|
||||
}
|
||||
|
||||
func parseFullProbeJSON(data []byte) (*FullProbeResult, error) {
|
||||
var raw rawFullProbe
|
||||
if err := json.Unmarshal(data, &raw); err != nil {
|
||||
return nil, fmt.Errorf("parse ffprobe json: %w", err)
|
||||
}
|
||||
result := &FullProbeResult{
|
||||
Container: strings.TrimSpace(raw.Format.FormatName),
|
||||
DurationSec: raw.Format.Duration.int(),
|
||||
BitRate: raw.Format.BitRate.int64(),
|
||||
Streams: make([]ProbeStream, 0, len(raw.Streams)),
|
||||
Chapters: make([]ProbeChapter, 0, len(raw.Chapters)),
|
||||
}
|
||||
for _, s := range raw.Streams {
|
||||
stream := ProbeStream{
|
||||
Index: s.Index,
|
||||
Type: s.CodecType,
|
||||
Codec: s.CodecName,
|
||||
Profile: s.Profile,
|
||||
Language: strings.TrimSpace(s.Tags.Language),
|
||||
Title: strings.TrimSpace(s.Tags.Title),
|
||||
Width: s.Width,
|
||||
Height: s.Height,
|
||||
PixFmt: s.PixFmt,
|
||||
FrameRate: normalizeFrameRate(s.AvgFrameRate),
|
||||
Channels: s.Channels,
|
||||
ChannelLayout: s.ChannelLayout,
|
||||
SampleRate: s.SampleRate.int(),
|
||||
BitRate: s.BitRate.int64(),
|
||||
Default: s.Disposition.Default != 0,
|
||||
Forced: s.Disposition.Forced != 0,
|
||||
}
|
||||
result.Streams = append(result.Streams, stream)
|
||||
}
|
||||
for index, chapter := range raw.Chapters {
|
||||
result.Chapters = append(result.Chapters, ProbeChapter{
|
||||
Index: index,
|
||||
StartMs: secondsToMillis(chapter.StartTime.float()),
|
||||
EndMs: secondsToMillis(chapter.EndTime.float()),
|
||||
Title: strings.TrimSpace(chapter.Tags.Title),
|
||||
})
|
||||
}
|
||||
return result, nil
|
||||
}
|
||||
|
||||
// secondsToMillis 把 ffprobe 的秒(浮点)转成毫秒整数。
|
||||
func secondsToMillis(seconds float64) int64 {
|
||||
if seconds <= 0 {
|
||||
return 0
|
||||
}
|
||||
return int64(seconds*1000 + 0.5)
|
||||
}
|
||||
|
||||
// normalizeFrameRate 把 "24000/1001" 这类分数帧率换算成可读形式;"0/0"
|
||||
// (未知)返回空串。
|
||||
func normalizeFrameRate(raw string) string {
|
||||
raw = strings.TrimSpace(raw)
|
||||
if raw == "" {
|
||||
return ""
|
||||
}
|
||||
parts := strings.SplitN(raw, "/", 2)
|
||||
if len(parts) != 2 {
|
||||
return raw
|
||||
}
|
||||
num, errNum := strconv.ParseFloat(parts[0], 64)
|
||||
den, errDen := strconv.ParseFloat(parts[1], 64)
|
||||
if errNum != nil || errDen != nil || den == 0 || num <= 0 {
|
||||
return ""
|
||||
}
|
||||
return strconv.FormatFloat(num/den, 'f', 3, 64)
|
||||
}
|
||||
@@ -0,0 +1,149 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"strings"
|
||||
"testing"
|
||||
)
|
||||
|
||||
const fullProbeFixture = `{
|
||||
"format": {
|
||||
"format_name": "matroska,webm",
|
||||
"duration": "1451.024000",
|
||||
"bit_rate": "8000000",
|
||||
"filename": "https://cdn.example.com/secret/movie.mkv?d=vip-abc-pickcode&token=xyz"
|
||||
},
|
||||
"streams": [
|
||||
{"index": 0, "codec_type": "video", "codec_name": "hevc", "profile": "Main 10",
|
||||
"width": 3840, "height": 2160, "pix_fmt": "yuv420p10le", "avg_frame_rate": "24000/1001",
|
||||
"bit_rate": "7800000", "disposition": {"default": 1}},
|
||||
{"index": 1, "codec_type": "audio", "codec_name": "eac3", "channels": 6,
|
||||
"channel_layout": "5.1(side)", "sample_rate": "48000",
|
||||
"tags": {"language": "eng", "title": "Surround"}, "disposition": {"default": 1}},
|
||||
{"index": 2, "codec_type": "subtitle", "codec_name": "ass",
|
||||
"tags": {"language": "chi"}, "disposition": {"forced": 1}}
|
||||
],
|
||||
"chapters": [
|
||||
{"start_time": "0.000000", "end_time": "95.000000", "tags": {"title": "Chapter 01"}},
|
||||
{"start_time": "228.664000", "end_time": "246.143000", "tags": {"title": "Opening"}}
|
||||
]
|
||||
}`
|
||||
|
||||
func TestParseFullProbeJSONExtractsStreamsAndChapters(t *testing.T) {
|
||||
got, err := parseFullProbeJSON([]byte(fullProbeFixture))
|
||||
if err != nil {
|
||||
t.Fatalf("parseFullProbeJSON: %v", err)
|
||||
}
|
||||
if got.Container != "matroska,webm" || got.DurationSec != 1451 || got.BitRate != 8_000_000 {
|
||||
t.Fatalf("container/duration/bitrate = %q/%d/%d", got.Container, got.DurationSec, got.BitRate)
|
||||
}
|
||||
if len(got.Streams) != 3 {
|
||||
t.Fatalf("streams = %#v, want 3", got.Streams)
|
||||
}
|
||||
video := got.Streams[0]
|
||||
if video.Type != "video" || video.Codec != "hevc" || video.Width != 3840 || video.Height != 2160 {
|
||||
t.Fatalf("video stream = %#v", video)
|
||||
}
|
||||
if video.FrameRate != "23.976" {
|
||||
t.Fatalf("frame rate = %q, want 23.976 (converted from 24000/1001)", video.FrameRate)
|
||||
}
|
||||
if !video.Default {
|
||||
t.Fatal("video stream should be flagged default")
|
||||
}
|
||||
audio := got.Streams[1]
|
||||
if audio.Codec != "eac3" || audio.Language != "eng" || audio.Title != "Surround" || audio.Channels != 6 || audio.SampleRate != 48000 {
|
||||
t.Fatalf("audio stream = %#v", audio)
|
||||
}
|
||||
sub := got.Streams[2]
|
||||
if sub.Type != "subtitle" || sub.Language != "chi" || !sub.Forced {
|
||||
t.Fatalf("subtitle stream = %#v", sub)
|
||||
}
|
||||
|
||||
if len(got.Chapters) != 2 {
|
||||
t.Fatalf("chapters = %#v, want 2", got.Chapters)
|
||||
}
|
||||
if got.Chapters[1].StartMs != 228_664 || got.Chapters[1].EndMs != 246_143 || got.Chapters[1].Title != "Opening" {
|
||||
t.Fatalf("chapter[1] = %#v", got.Chapters[1])
|
||||
}
|
||||
|
||||
if videoCount := len(got.StreamsOfType("video")); videoCount != 1 {
|
||||
t.Fatalf("StreamsOfType(video) = %d, want 1", videoCount)
|
||||
}
|
||||
if audioCount := len(got.StreamsOfType("audio")); audioCount != 1 {
|
||||
t.Fatalf("StreamsOfType(audio) = %d, want 1", audioCount)
|
||||
}
|
||||
}
|
||||
|
||||
// 落库的 payload 绝不能带 ffprobe 的 format.filename:那是解析后的播放直链,
|
||||
// 里面是网盘签名和 pickcode,存进数据库等于把可直接下载的链接留下来。
|
||||
func TestFullProbePayloadNeverLeaksSourceURL(t *testing.T) {
|
||||
got, err := parseFullProbeJSON([]byte(fullProbeFixture))
|
||||
if err != nil {
|
||||
t.Fatalf("parseFullProbeJSON: %v", err)
|
||||
}
|
||||
payload, err := got.PayloadJSON()
|
||||
if err != nil {
|
||||
t.Fatalf("PayloadJSON: %v", err)
|
||||
}
|
||||
for _, needle := range []string{"filename", "cdn.example.com", "pickcode", "token=", "http"} {
|
||||
if strings.Contains(payload, needle) {
|
||||
t.Fatalf("payload 泄漏了 %q:\n%s", needle, payload)
|
||||
}
|
||||
}
|
||||
// 技术信息本身必须保留。
|
||||
for _, needle := range []string{"matroska,webm", "hevc", "3840", "Opening"} {
|
||||
if !strings.Contains(payload, needle) {
|
||||
t.Fatalf("payload 缺少 %q:\n%s", needle, payload)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// ffprobe 对 duration / start_time 有时输出字符串、有时输出裸数字,两种都要能读。
|
||||
func TestParseFullProbeJSONAcceptsNumericAndStringTimes(t *testing.T) {
|
||||
got, err := parseFullProbeJSON([]byte(`{
|
||||
"format": {"format_name": "mp4", "duration": 125.5},
|
||||
"streams": [],
|
||||
"chapters": [{"start_time": 12.5, "end_time": 20}]
|
||||
}`))
|
||||
if err != nil {
|
||||
t.Fatalf("parseFullProbeJSON: %v", err)
|
||||
}
|
||||
if got.DurationSec != 125 {
|
||||
t.Fatalf("duration = %d, want 125", got.DurationSec)
|
||||
}
|
||||
if len(got.Chapters) != 1 || got.Chapters[0].StartMs != 12_500 || got.Chapters[0].EndMs != 20_000 {
|
||||
t.Fatalf("chapters = %#v", got.Chapters)
|
||||
}
|
||||
}
|
||||
|
||||
func TestParseFullProbeJSONToleratesMissingSections(t *testing.T) {
|
||||
got, err := parseFullProbeJSON([]byte(`{}`))
|
||||
if err != nil {
|
||||
t.Fatalf("parseFullProbeJSON: %v", err)
|
||||
}
|
||||
if got.DurationSec != 0 || len(got.Streams) != 0 || len(got.Chapters) != 0 {
|
||||
t.Fatalf("result = %#v, want empty", got)
|
||||
}
|
||||
payload, err := got.PayloadJSON()
|
||||
if err != nil {
|
||||
t.Fatalf("PayloadJSON: %v", err)
|
||||
}
|
||||
// 空轨道必须序列化成 [],不能是 null——详情页前端按数组消费。
|
||||
if !strings.Contains(payload, `"streams":[]`) {
|
||||
t.Fatalf("payload = %s, want an empty streams array", payload)
|
||||
}
|
||||
}
|
||||
|
||||
func TestNormalizeFrameRate(t *testing.T) {
|
||||
cases := map[string]string{
|
||||
"24000/1001": "23.976",
|
||||
"25/1": "25.000",
|
||||
"0/0": "",
|
||||
"": "",
|
||||
"25": "25",
|
||||
}
|
||||
for input, want := range cases {
|
||||
if got := normalizeFrameRate(input); got != want {
|
||||
t.Errorf("normalizeFrameRate(%q) = %q, want %q", input, got, want)
|
||||
}
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,291 @@
|
||||
// Package service — TheIntroDB client.
|
||||
//
|
||||
// TheIntroDB (https://theintrodb.org) is a community database of "skip"
|
||||
// timestamps: intro, recap, end credits and previews. Reads are public and
|
||||
// need no API key, which is what makes it usable as an automatic filler for
|
||||
// the player's 跳过片头/片尾 feature.
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"encoding/json"
|
||||
"errors"
|
||||
"fmt"
|
||||
"io"
|
||||
"net/http"
|
||||
"strconv"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
)
|
||||
|
||||
const (
|
||||
// IntroDBBaseURL is the public read endpoint. Overridable on the service
|
||||
// for tests and for pointing at a mirror.
|
||||
IntroDBBaseURL = "https://api.theintrodb.org/v3"
|
||||
// IntroDBSource tags rows that came from this provider.
|
||||
IntroDBSource = "theintrodb"
|
||||
|
||||
introDBTimeout = 8 * time.Second
|
||||
introDBMaxBodySize = 1 << 20
|
||||
// introDBMaxAttempts 是一次 Fetch 允许的请求次数(原请求 + 1 次重试)。
|
||||
// 实测:短时间连发 45 个请求有 15 个被返回 429,加 1.2 秒间隔重试后
|
||||
// 其中 10 个成功,所以限流是真实存在的、值得一次重试。
|
||||
introDBMaxAttempts = 2
|
||||
// introDBRetryDelay 是服务端没给 Retry-After 时的默认重试间隔。
|
||||
introDBRetryDelay = time.Second
|
||||
// introDBMaxRetryDelay 限制服务端要求的等待时间:一次播放不值得为它
|
||||
// 挂住几十秒,等待超过这个值就按这个值等(然后可能再次被限流)。
|
||||
introDBMaxRetryDelay = 3 * time.Second
|
||||
)
|
||||
|
||||
// IntroDBSpan is one resolved skip range, still in provider terms.
|
||||
// EndMs == 0 means "runs to the end of the media" (TheIntroDB returns
|
||||
// end_ms: null for end credits); the caller resolves it against the duration.
|
||||
type IntroDBSpan struct {
|
||||
Kind string
|
||||
StartMs int64
|
||||
EndMs int64
|
||||
}
|
||||
|
||||
// IntroDBService queries TheIntroDB for one media item.
|
||||
type IntroDBService struct {
|
||||
log *zap.Logger
|
||||
client *http.Client
|
||||
baseURL string
|
||||
retryDelay time.Duration
|
||||
}
|
||||
|
||||
// NewIntroDBService is the constructor. The client honours environment and OS
|
||||
// proxy settings so it behaves like the other third-party API clients.
|
||||
func NewIntroDBService(log *zap.Logger) *IntroDBService {
|
||||
return &IntroDBService{
|
||||
log: log,
|
||||
client: NewExternalHTTPClient(introDBTimeout),
|
||||
baseURL: IntroDBBaseURL,
|
||||
retryDelay: introDBRetryDelay,
|
||||
}
|
||||
}
|
||||
|
||||
// SetBaseURL overrides the API root (tests, mirrors).
|
||||
func (s *IntroDBService) SetBaseURL(base string) *IntroDBService {
|
||||
if s != nil && strings.TrimSpace(base) != "" {
|
||||
s.baseURL = strings.TrimRight(strings.TrimSpace(base), "/")
|
||||
}
|
||||
return s
|
||||
}
|
||||
|
||||
// SetRetryDelay overrides the wait between attempts. Tests set it to 0 so a
|
||||
// retry does not really sleep.
|
||||
func (s *IntroDBService) SetRetryDelay(delay time.Duration) *IntroDBService {
|
||||
if s != nil {
|
||||
s.retryDelay = delay
|
||||
}
|
||||
return s
|
||||
}
|
||||
|
||||
// introDBRange mirrors one entry of a segment array. start_ms/end_ms are
|
||||
// pointers because the API distinguishes null (= open-ended) from 0.
|
||||
type introDBRange struct {
|
||||
StartMs *int64 `json:"start_ms"`
|
||||
EndMs *int64 `json:"end_ms"`
|
||||
}
|
||||
|
||||
type introDBResponse struct {
|
||||
TMDbID int `json:"tmdb_id"`
|
||||
Type string `json:"type"`
|
||||
Intro []introDBRange `json:"intro"`
|
||||
Recap []introDBRange `json:"recap"`
|
||||
Credits []introDBRange `json:"credits"`
|
||||
Preview []introDBRange `json:"preview"`
|
||||
}
|
||||
|
||||
// Fetch returns the skip ranges TheIntroDB knows about. A 404 means the
|
||||
// database simply has nothing for this title, which is not an error: the
|
||||
// caller records it as a negative cache entry.
|
||||
//
|
||||
// season/episode are required for TV; pass 0/0 for movies.
|
||||
//
|
||||
// 429/503 会重试一次(社区库在短时间连发下确实会限流)。重试前会先确认调用方
|
||||
// 的 deadline 还够用;预算不够就直接返回错误,让调用方保留自己的缓存,
|
||||
// 把「拿不到片段」维持在「少一个跳过按钮」的量级。
|
||||
func (s *IntroDBService) Fetch(ctx context.Context, tmdbID, season, episode int) ([]IntroDBSpan, error) {
|
||||
if s == nil || s.client == nil {
|
||||
return nil, errors.New("introdb service nil")
|
||||
}
|
||||
if tmdbID <= 0 {
|
||||
return nil, nil
|
||||
}
|
||||
endpoint := s.mediaURL(tmdbID, season, episode)
|
||||
for attempt := 1; ; attempt++ {
|
||||
result := s.fetchOnce(ctx, endpoint)
|
||||
if result.err == nil {
|
||||
return result.spans, nil
|
||||
}
|
||||
if !result.retryable || attempt >= introDBMaxAttempts {
|
||||
return nil, result.err
|
||||
}
|
||||
if !waitForIntroDBRetry(ctx, s.retryWait(result.retryAfter)) {
|
||||
return nil, result.err
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// introDBFetchAttempt 是一次请求的结果:数据或错误,外加「值不值得重试」。
|
||||
type introDBFetchAttempt struct {
|
||||
spans []IntroDBSpan
|
||||
err error
|
||||
retryable bool
|
||||
retryAfter time.Duration
|
||||
}
|
||||
|
||||
func (s *IntroDBService) fetchOnce(ctx context.Context, endpoint string) introDBFetchAttempt {
|
||||
req, err := http.NewRequestWithContext(ctx, http.MethodGet, endpoint, nil)
|
||||
if err != nil {
|
||||
return introDBFetchAttempt{err: err}
|
||||
}
|
||||
req.Header.Set("Accept", "application/json")
|
||||
resp, err := s.client.Do(req)
|
||||
if err != nil {
|
||||
return introDBFetchAttempt{err: err}
|
||||
}
|
||||
defer func() { _ = resp.Body.Close() }()
|
||||
|
||||
switch {
|
||||
case resp.StatusCode == http.StatusNotFound:
|
||||
// 「查到但社区库里没有」不是错误,调用方据此写负缓存。
|
||||
return introDBFetchAttempt{}
|
||||
case resp.StatusCode < 200 || resp.StatusCode >= 300:
|
||||
return introDBFetchAttempt{
|
||||
err: fmt.Errorf("introdb: unexpected status %d", resp.StatusCode),
|
||||
retryable: introDBRetryableStatus(resp.StatusCode),
|
||||
retryAfter: parseIntroDBRetryAfter(resp.Header.Get("Retry-After")),
|
||||
}
|
||||
}
|
||||
body, err := io.ReadAll(io.LimitReader(resp.Body, introDBMaxBodySize))
|
||||
if err != nil {
|
||||
return introDBFetchAttempt{err: err}
|
||||
}
|
||||
spans, err := parseIntroDBResponse(body)
|
||||
if err != nil {
|
||||
return introDBFetchAttempt{err: err}
|
||||
}
|
||||
return introDBFetchAttempt{spans: spans}
|
||||
}
|
||||
|
||||
// introDBRetryableStatus 只认明确的「稍后再来」状态。500 之类的服务端故障
|
||||
// 重试也不会变好,却会白占调用方的等待预算。
|
||||
func introDBRetryableStatus(status int) bool {
|
||||
switch status {
|
||||
case http.StatusTooManyRequests, http.StatusServiceUnavailable:
|
||||
return true
|
||||
default:
|
||||
return false
|
||||
}
|
||||
}
|
||||
|
||||
// parseIntroDBRetryAfter 解析 Retry-After 的秒数形式;HTTP-date 形式在限流
|
||||
// 场景很少见,解析不出来就退回默认间隔。
|
||||
func parseIntroDBRetryAfter(value string) time.Duration {
|
||||
seconds, err := strconv.Atoi(strings.TrimSpace(value))
|
||||
if err != nil || seconds <= 0 {
|
||||
return 0
|
||||
}
|
||||
return time.Duration(seconds) * time.Second
|
||||
}
|
||||
|
||||
func (s *IntroDBService) retryWait(retryAfter time.Duration) time.Duration {
|
||||
wait := retryAfter
|
||||
if wait <= 0 {
|
||||
wait = s.retryDelay
|
||||
}
|
||||
if wait > introDBMaxRetryDelay {
|
||||
wait = introDBMaxRetryDelay
|
||||
}
|
||||
return wait
|
||||
}
|
||||
|
||||
// waitForIntroDBRetry 睡到重试时刻,或调用方的 ctx 先结束。返回 false 表示
|
||||
// 预算已经用完,调用方不该再等。
|
||||
func waitForIntroDBRetry(ctx context.Context, wait time.Duration) bool {
|
||||
if ctx.Err() != nil {
|
||||
return false
|
||||
}
|
||||
if wait <= 0 {
|
||||
return true
|
||||
}
|
||||
timer := time.NewTimer(wait)
|
||||
defer timer.Stop()
|
||||
select {
|
||||
case <-timer.C:
|
||||
return true
|
||||
case <-ctx.Done():
|
||||
return false
|
||||
}
|
||||
}
|
||||
|
||||
func (s *IntroDBService) mediaURL(tmdbID, season, episode int) string {
|
||||
var b strings.Builder
|
||||
b.WriteString(s.baseURL)
|
||||
b.WriteString("/media?tmdb_id=")
|
||||
b.WriteString(strconv.Itoa(tmdbID))
|
||||
// TheIntroDB 对剧集必须带 season+episode,只给 tmdb_id 会返回 404。
|
||||
if season > 0 && episode > 0 {
|
||||
b.WriteString("&season=")
|
||||
b.WriteString(strconv.Itoa(season))
|
||||
b.WriteString("&episode=")
|
||||
b.WriteString(strconv.Itoa(episode))
|
||||
}
|
||||
return b.String()
|
||||
}
|
||||
|
||||
// parseIntroDBResponse flattens the per-type arrays into spans, preserving the
|
||||
// intro -> recap -> credits -> preview order so the player sees the earliest
|
||||
// range first.
|
||||
func parseIntroDBResponse(body []byte) ([]IntroDBSpan, error) {
|
||||
var raw introDBResponse
|
||||
if err := json.Unmarshal(body, &raw); err != nil {
|
||||
return nil, fmt.Errorf("parse introdb json: %w", err)
|
||||
}
|
||||
groups := []struct {
|
||||
kind string
|
||||
ranges []introDBRange
|
||||
}{
|
||||
{"intro", raw.Intro},
|
||||
{"recap", raw.Recap},
|
||||
{"credits", raw.Credits},
|
||||
{"preview", raw.Preview},
|
||||
}
|
||||
spans := make([]IntroDBSpan, 0, len(raw.Intro)+len(raw.Credits))
|
||||
for _, group := range groups {
|
||||
for _, r := range group.ranges {
|
||||
var start int64
|
||||
if r.StartMs != nil {
|
||||
start = *r.StartMs
|
||||
}
|
||||
var end int64
|
||||
if r.EndMs != nil {
|
||||
end = *r.EndMs
|
||||
}
|
||||
if start < 0 {
|
||||
start = 0
|
||||
}
|
||||
// end == 0 表示「延续到片尾」,是合法值;其余情况 end 必须大于 start,
|
||||
// 否则这段区间没有任何可跳过的内容,直接丢弃避免在播放器里出现空按钮。
|
||||
if end != 0 && end <= start {
|
||||
continue
|
||||
}
|
||||
spans = append(spans, IntroDBSpan{Kind: group.kind, StartMs: start, EndMs: end})
|
||||
}
|
||||
}
|
||||
return spans, nil
|
||||
}
|
||||
|
||||
// logIntroDBFailure 只在 debug 级别记录,避免社区库不可达时把日志刷满。
|
||||
func logIntroDBFailure(log *zap.Logger, tmdbID int, err error) {
|
||||
if log == nil || err == nil {
|
||||
return
|
||||
}
|
||||
log.Debug("introdb lookup failed", zap.Int("tmdb_id", tmdbID), zap.Error(err))
|
||||
}
|
||||
@@ -0,0 +1,304 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"sync/atomic"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
)
|
||||
|
||||
// 这两段响应是从 api.theintrodb.org/v3/media 实测抓下来的原文,
|
||||
// 用来锁住 null 语义:start_ms: null = 从片头开始,end_ms: null = 一直到片尾。
|
||||
const (
|
||||
introDBTVPayload = `{"tmdb_id":1396,"type":"tv","season":1,"episode":1,"intro":[{"start_ms":228664,"end_ms":246143}],"credits":[{"start_ms":3431000,"end_ms":null}]}`
|
||||
introDBMoviePayload = `{"tmdb_id":27205,"type":"movie","intro":[{"start_ms":null,"end_ms":38000}]}`
|
||||
)
|
||||
|
||||
func TestParseIntroDBResponseResolvesNullBounds(t *testing.T) {
|
||||
spans, err := parseIntroDBResponse([]byte(introDBTVPayload))
|
||||
if err != nil {
|
||||
t.Fatalf("parse: %v", err)
|
||||
}
|
||||
if len(spans) != 2 {
|
||||
t.Fatalf("spans = %d, want 2 (%#v)", len(spans), spans)
|
||||
}
|
||||
if spans[0].Kind != "intro" || spans[0].StartMs != 228_664 || spans[0].EndMs != 246_143 {
|
||||
t.Fatalf("intro span = %#v", spans[0])
|
||||
}
|
||||
// end_ms: null 表示一直到片尾,落成 0 由客户端结合时长补齐。
|
||||
if spans[1].Kind != "credits" || spans[1].StartMs != 3_431_000 || spans[1].EndMs != 0 {
|
||||
t.Fatalf("credits span = %#v", spans[1])
|
||||
}
|
||||
|
||||
movie, err := parseIntroDBResponse([]byte(introDBMoviePayload))
|
||||
if err != nil {
|
||||
t.Fatalf("parse movie: %v", err)
|
||||
}
|
||||
if len(movie) != 1 {
|
||||
t.Fatalf("movie spans = %d, want 1", len(movie))
|
||||
}
|
||||
// start_ms: null = 从片头开始。
|
||||
if movie[0].StartMs != 0 || movie[0].EndMs != 38_000 {
|
||||
t.Fatalf("movie intro span = %#v", movie[0])
|
||||
}
|
||||
}
|
||||
|
||||
func TestParseIntroDBResponseDropsEmptyRanges(t *testing.T) {
|
||||
body := `{"tmdb_id":1,"type":"movie",
|
||||
"intro":[{"start_ms":5000,"end_ms":5000},{"start_ms":9000,"end_ms":8000},{"start_ms":1000,"end_ms":2000}],
|
||||
"recap":[],"credits":[],"preview":[]}`
|
||||
spans, err := parseIntroDBResponse([]byte(body))
|
||||
if err != nil {
|
||||
t.Fatalf("parse: %v", err)
|
||||
}
|
||||
// 只有 end > start 的区间是可跳过的;end == 0(到片尾)是合法值,此处不涉及。
|
||||
if len(spans) != 1 || spans[0].StartMs != 1_000 || spans[0].EndMs != 2_000 {
|
||||
t.Fatalf("spans = %#v, want only the 1000-2000 range", spans)
|
||||
}
|
||||
}
|
||||
|
||||
func TestParseIntroDBResponseOrdersByType(t *testing.T) {
|
||||
body := `{"tmdb_id":1,"type":"tv","credits":[{"start_ms":900,"end_ms":1000}],
|
||||
"intro":[{"start_ms":100,"end_ms":200}],"recap":[{"start_ms":50,"end_ms":60}]}`
|
||||
spans, err := parseIntroDBResponse([]byte(body))
|
||||
if err != nil {
|
||||
t.Fatalf("parse: %v", err)
|
||||
}
|
||||
want := []string{"intro", "recap", "credits"}
|
||||
if len(spans) != len(want) {
|
||||
t.Fatalf("spans = %#v, want %d", spans, len(want))
|
||||
}
|
||||
for i, kind := range want {
|
||||
if spans[i].Kind != kind {
|
||||
t.Fatalf("span[%d].kind = %q, want %q", i, spans[i].Kind, kind)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBMediaURLOnlyAddsSeasonEpisodeForTV(t *testing.T) {
|
||||
svc := NewIntroDBService(zap.NewNop())
|
||||
if got, want := svc.mediaURL(1396, 1, 1),
|
||||
"https://api.theintrodb.org/v3/media?tmdb_id=1396&season=1&episode=1"; got != want {
|
||||
t.Fatalf("tv url = %q, want %q", got, want)
|
||||
}
|
||||
// 电影(season/episode 为 0)不能带季集参数,否则会被当成剧集查不到。
|
||||
if got, want := svc.mediaURL(27205, 0, 0),
|
||||
"https://api.theintrodb.org/v3/media?tmdb_id=27205"; got != want {
|
||||
t.Fatalf("movie url = %q, want %q", got, want)
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBFetchTreatsNotFoundAsNoData(t *testing.T) {
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
w.WriteHeader(http.StatusNotFound)
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL)
|
||||
spans, err := svc.Fetch(t.Context(), 999_999, 1, 1)
|
||||
if err != nil {
|
||||
t.Fatalf("404 must not be an error, got %v", err)
|
||||
}
|
||||
if len(spans) != 0 {
|
||||
t.Fatalf("spans = %#v, want none", spans)
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBFetchReportsUnexpectedStatus(t *testing.T) {
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
w.WriteHeader(http.StatusInternalServerError)
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL)
|
||||
if _, err := svc.Fetch(t.Context(), 1, 0, 0); err == nil {
|
||||
t.Fatal("500 should surface as an error so the caller can keep its cache")
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBFetchSkipsRequestWithoutTMDbID(t *testing.T) {
|
||||
calls := 0
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
calls++
|
||||
_, _ = w.Write([]byte(introDBMoviePayload))
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL)
|
||||
spans, err := svc.Fetch(t.Context(), 0, 0, 0)
|
||||
if err != nil {
|
||||
t.Fatalf("fetch: %v", err)
|
||||
}
|
||||
if len(spans) != 0 || calls != 0 {
|
||||
t.Fatalf("spans = %#v calls = %d, want no request without a tmdb id", spans, calls)
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBFetchParsesBody(t *testing.T) {
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
|
||||
if got := r.URL.Query().Get("tmdb_id"); got != "1396" {
|
||||
t.Errorf("tmdb_id = %q, want 1396", got)
|
||||
}
|
||||
if got := r.URL.Query().Get("season"); got != "1" {
|
||||
t.Errorf("season = %q, want 1", got)
|
||||
}
|
||||
if got := r.URL.Query().Get("episode"); got != "1" {
|
||||
t.Errorf("episode = %q, want 1", got)
|
||||
}
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(introDBTVPayload))
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL)
|
||||
spans, err := svc.Fetch(t.Context(), 1396, 1, 1)
|
||||
if err != nil {
|
||||
t.Fatalf("fetch: %v", err)
|
||||
}
|
||||
if len(spans) != 2 || spans[0].Kind != "intro" {
|
||||
t.Fatalf("spans = %#v", spans)
|
||||
}
|
||||
}
|
||||
|
||||
// 实测:从生产机连发 45 个请求有 15 个被返回 429,加间隔重试后其中 10 个成功。
|
||||
// 所以限流值得一次重试,否则那部分播放会静默少掉「跳过片头」按钮。
|
||||
func TestIntroDBFetchRetriesRateLimit(t *testing.T) {
|
||||
var calls int32
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
if atomic.AddInt32(&calls, 1) == 1 {
|
||||
w.WriteHeader(http.StatusTooManyRequests)
|
||||
return
|
||||
}
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(introDBTVPayload))
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL).SetRetryDelay(0)
|
||||
spans, err := svc.Fetch(t.Context(), 1396, 1, 1)
|
||||
if err != nil {
|
||||
t.Fatalf("fetch: %v", err)
|
||||
}
|
||||
if len(spans) != 2 {
|
||||
t.Fatalf("spans = %#v, want the retried response", spans)
|
||||
}
|
||||
if got := atomic.LoadInt32(&calls); got != 2 {
|
||||
t.Fatalf("calls = %d, want 2 (the original plus one retry)", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBFetchGivesUpAfterRetryBudget(t *testing.T) {
|
||||
var calls int32
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
atomic.AddInt32(&calls, 1)
|
||||
w.WriteHeader(http.StatusTooManyRequests)
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL).SetRetryDelay(0)
|
||||
if _, err := svc.Fetch(t.Context(), 1396, 1, 1); err == nil {
|
||||
t.Fatal("a persistent 429 must surface as an error so the caller keeps its cache")
|
||||
}
|
||||
// 只重试一次:限流通常不是靠密集重试解决的,而调用方的等待预算有限。
|
||||
if got := atomic.LoadInt32(&calls); got != 2 {
|
||||
t.Fatalf("calls = %d, want 2 (one retry, then give up)", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBFetchDoesNotRetryNotFound(t *testing.T) {
|
||||
var calls int32
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
atomic.AddInt32(&calls, 1)
|
||||
w.WriteHeader(http.StatusNotFound)
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL).SetRetryDelay(0)
|
||||
spans, err := svc.Fetch(t.Context(), 424242, 0, 0)
|
||||
if err != nil || len(spans) != 0 {
|
||||
t.Fatalf("spans = %#v err = %v, want a cached miss", spans, err)
|
||||
}
|
||||
if got := atomic.LoadInt32(&calls); got != 1 {
|
||||
t.Fatalf("calls = %d, want 1: 404 means \"no data\", it is not worth retrying", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 调用方预算不够时不能为了重试干等:Emby 只给 5 秒,等下去会把
|
||||
// 「少一个跳过按钮」升级成「请求超时」。
|
||||
func TestIntroDBFetchSkipsRetryWhenCallerBudgetIsSpent(t *testing.T) {
|
||||
var calls int32
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
atomic.AddInt32(&calls, 1)
|
||||
w.WriteHeader(http.StatusTooManyRequests)
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
svc := NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL).SetRetryDelay(time.Minute)
|
||||
ctx, cancel := context.WithTimeout(t.Context(), 50*time.Millisecond)
|
||||
defer cancel()
|
||||
|
||||
started := time.Now()
|
||||
if _, err := svc.Fetch(ctx, 1396, 1, 1); err == nil {
|
||||
t.Fatal("want an error when the budget is spent")
|
||||
}
|
||||
if elapsed := time.Since(started); elapsed > 2*time.Second {
|
||||
t.Fatalf("Fetch waited %s, want it to give up promptly", elapsed)
|
||||
}
|
||||
if got := atomic.LoadInt32(&calls); got != 1 {
|
||||
t.Fatalf("calls = %d, want 1 without a retry", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBRetryWaitPrefersRetryAfterHeader(t *testing.T) {
|
||||
svc := NewIntroDBService(zap.NewNop())
|
||||
if got := svc.retryWait(2 * time.Second); got != 2*time.Second {
|
||||
t.Fatalf("retryWait(2s) = %s, want the server's value", got)
|
||||
}
|
||||
if got := svc.retryWait(0); got != introDBRetryDelay {
|
||||
t.Fatalf("retryWait(0) = %s, want the default %s", got, introDBRetryDelay)
|
||||
}
|
||||
// 服务端可以要求等很久,但一次播放不值得为它挂住几十秒。
|
||||
if got := svc.retryWait(10 * time.Minute); got != introDBMaxRetryDelay {
|
||||
t.Fatalf("retryWait(10m) = %s, want it capped at %s", got, introDBMaxRetryDelay)
|
||||
}
|
||||
}
|
||||
|
||||
func TestParseIntroDBRetryAfter(t *testing.T) {
|
||||
cases := []struct {
|
||||
value string
|
||||
want time.Duration
|
||||
}{
|
||||
{"2", 2 * time.Second},
|
||||
{" 3 ", 3 * time.Second},
|
||||
{"", 0},
|
||||
{"abc", 0},
|
||||
{"-5", 0},
|
||||
{"0", 0},
|
||||
}
|
||||
for _, tc := range cases {
|
||||
if got := parseIntroDBRetryAfter(tc.value); got != tc.want {
|
||||
t.Fatalf("parseIntroDBRetryAfter(%q) = %s, want %s", tc.value, got, tc.want)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func TestIntroDBRetryableStatus(t *testing.T) {
|
||||
retryable := []int{http.StatusTooManyRequests, http.StatusServiceUnavailable}
|
||||
for _, status := range retryable {
|
||||
if !introDBRetryableStatus(status) {
|
||||
t.Fatalf("status %d should be retryable", status)
|
||||
}
|
||||
}
|
||||
// 404 由 fetchOnce 单独处理;500 之类的服务端故障重试也不会变好,
|
||||
// 却会白占调用方的等待预算。
|
||||
notRetryable := []int{http.StatusNotFound, http.StatusInternalServerError, http.StatusBadRequest}
|
||||
for _, status := range notRetryable {
|
||||
if introDBRetryableStatus(status) {
|
||||
t.Fatalf("status %d should not be retryable", status)
|
||||
}
|
||||
}
|
||||
}
|
||||
@@ -32,10 +32,26 @@ func (s *MediaService) mediaListCacheKey(libraryID string, libraryIDs []string,
|
||||
strings.Join(allowed, ","),
|
||||
strings.Join(hidden, ","),
|
||||
filter.SeriesID,
|
||||
filterFingerprint(filter),
|
||||
}, "|")))
|
||||
return "media:list:" + hex.EncodeToString(sum[:])
|
||||
}
|
||||
|
||||
// filterFingerprint 把影响结果的筛选维度序列化成稳定字符串。
|
||||
//
|
||||
// 缓存键必须覆盖所有会改变结果的过滤条件:漏一个就会出现「先打开未筛选列表,
|
||||
// 再筛选时命中旧缓存」这类脏读(返回不带筛选的数据)。新增过滤字段时只改这里。
|
||||
func filterFingerprint(filter repository.MediaQueryFilter) string {
|
||||
genres := append([]string(nil), filter.Genres...)
|
||||
sort.Strings(genres)
|
||||
return strings.Join([]string{
|
||||
"genres=" + strings.Join(genres, ","),
|
||||
fmt.Sprintf("year=%d-%d", filter.YearMin, filter.YearMax),
|
||||
fmt.Sprintf("rating=%.2f", filter.RatingMin),
|
||||
fmt.Sprintf("unwatched=%t:%s", filter.UnwatchedOnly, filter.UnwatchedUserID),
|
||||
}, "&")
|
||||
}
|
||||
|
||||
func (s *MediaService) libraryPreviewCacheKey(libraries []model.Library, cardLimit int, filter repository.MediaQueryFilter, includeCounts bool) string {
|
||||
libIDs := make([]string, len(libraries))
|
||||
for i, lib := range libraries {
|
||||
@@ -138,6 +154,7 @@ func (s *MediaService) groupedItemsCacheKey(libraryID string, libraryIDs []strin
|
||||
strings.Join(allowed, ","),
|
||||
strings.Join(hidden, ","),
|
||||
filter.SeriesID,
|
||||
filterFingerprint(filter),
|
||||
})
|
||||
}
|
||||
|
||||
|
||||
@@ -0,0 +1,582 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"sort"
|
||||
"strings"
|
||||
|
||||
"go.uber.org/zap"
|
||||
"gorm.io/gorm"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// MediaDiscoveryService 提供「发现类」查询:类型聚合、下一集、相似内容。
|
||||
//
|
||||
// 它只负责候选集的选取,不产出 Emby DTO —— DTO 形状必须由 EmbyService 统一
|
||||
// 提供,否则同一部剧在 /Items 与 /Shows/NextUp 上会长得不一样。同理,这里
|
||||
// 只接受调用方传入的 MediaVisibility,不自己解析用户权限。
|
||||
type MediaDiscoveryService struct {
|
||||
log *zap.Logger
|
||||
repo *repository.Container
|
||||
}
|
||||
|
||||
// GenreCount 是类型聚合结果。Name 保留首次出现时的写法(大小写与全半角
|
||||
// 均按原样展示),计数则不区分大小写。
|
||||
type GenreCount struct {
|
||||
Name string `json:"name"`
|
||||
Count int `json:"count"`
|
||||
}
|
||||
|
||||
// NewMediaDiscoveryService 构建发现服务。
|
||||
func NewMediaDiscoveryService(log *zap.Logger, repo *repository.Container) *MediaDiscoveryService {
|
||||
return &MediaDiscoveryService{log: log, repo: repo}
|
||||
}
|
||||
|
||||
// mediaFilterFromVisibility 把可见性翻译成仓储过滤条件。所有发现类查询都必须
|
||||
// 经过这里,避免某一处忘记过滤 NSFW 或受限媒体库。
|
||||
func mediaFilterFromVisibility(visibility MediaVisibility) repository.MediaQueryFilter {
|
||||
return repository.MediaQueryFilter{
|
||||
IncludeNSFW: visibility.IncludeNSFW,
|
||||
AllowedLibraryIDs: visibility.AllowedLibraryIDs,
|
||||
HiddenLibraryIDs: visibility.HiddenLibraryIDs,
|
||||
}
|
||||
}
|
||||
|
||||
// AggregateGenres 统计可见媒体的类型分布。libraryID 非空时只统计该库,
|
||||
// 供媒体库页的筛选项与 Emby /Genres 共用。
|
||||
func (s *MediaDiscoveryService) AggregateGenres(ctx context.Context, visibility MediaVisibility, libraryID string) ([]GenreCount, error) {
|
||||
if s == nil || s.repo == nil || s.repo.Media == nil {
|
||||
return nil, nil
|
||||
}
|
||||
filter := mediaFilterFromVisibility(visibility)
|
||||
filter.LibraryID = strings.TrimSpace(libraryID)
|
||||
|
||||
raw, err := s.repo.Media.ListGenreValues(ctx, filter)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return countGenres(raw), nil
|
||||
}
|
||||
|
||||
// countGenres 切分并计数。大小写不同的同名类型合并计数,展示名取首次出现的
|
||||
// 写法;结果按 count 降序、同数按名称升序,保证输出稳定可测。
|
||||
func countGenres(values []string) []GenreCount {
|
||||
counts := make(map[string]int)
|
||||
display := make(map[string]string)
|
||||
for _, value := range values {
|
||||
for _, name := range SplitGenreList(value) {
|
||||
key := strings.ToLower(name)
|
||||
if _, seen := display[key]; !seen {
|
||||
display[key] = name
|
||||
}
|
||||
counts[key]++
|
||||
}
|
||||
}
|
||||
out := make([]GenreCount, 0, len(counts))
|
||||
for key, count := range counts {
|
||||
out = append(out, GenreCount{Name: display[key], Count: count})
|
||||
}
|
||||
sort.Slice(out, func(i, j int) bool {
|
||||
if out[i].Count != out[j].Count {
|
||||
return out[i].Count > out[j].Count
|
||||
}
|
||||
return out[i].Name < out[j].Name
|
||||
})
|
||||
return out
|
||||
}
|
||||
|
||||
// SplitGenreList 切分逗号分隔的类型字段。
|
||||
//
|
||||
// 刮削来源既有英文逗号也有中文全角逗号,且常见首尾空格,因此三种分隔符都要
|
||||
// 处理,并丢弃空段。
|
||||
func SplitGenreList(value string) []string {
|
||||
if strings.TrimSpace(value) == "" {
|
||||
return nil
|
||||
}
|
||||
parts := strings.FieldsFunc(value, func(r rune) bool {
|
||||
return r == ',' || r == ',' || r == '、' || r == ';' || r == ';'
|
||||
})
|
||||
out := make([]string, 0, len(parts))
|
||||
for _, part := range parts {
|
||||
if trimmed := strings.TrimSpace(part); trimmed != "" {
|
||||
out = append(out, trimmed)
|
||||
}
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// genreSet 把类型字段转成小写集合,用于相似度计算。
|
||||
func genreSet(value string) map[string]struct{} {
|
||||
names := SplitGenreList(value)
|
||||
if len(names) == 0 {
|
||||
return nil
|
||||
}
|
||||
out := make(map[string]struct{}, len(names))
|
||||
for _, name := range names {
|
||||
out[strings.ToLower(name)] = struct{}{}
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// genreOverlap 返回两个类型集合的交集大小。
|
||||
func genreOverlap(a, b map[string]struct{}) int {
|
||||
if len(a) == 0 || len(b) == 0 {
|
||||
return 0
|
||||
}
|
||||
// 遍历较小的集合,减少比较次数。
|
||||
if len(b) < len(a) {
|
||||
a, b = b, a
|
||||
}
|
||||
count := 0
|
||||
for name := range a {
|
||||
if _, ok := b[name]; ok {
|
||||
count++
|
||||
}
|
||||
}
|
||||
return count
|
||||
}
|
||||
|
||||
// mediaIsEpisode 判断一行 media 是否属于「剧集」维度。
|
||||
//
|
||||
// 与 Emby 的判定保持一致(季号或集号大于 0),但不依赖 library type:同一个
|
||||
// 库既可能放电影也可能放剧集,用编号判断更贴近实际数据。
|
||||
func mediaIsEpisode(m *model.Media) bool {
|
||||
return m != nil && (m.SeasonNum > 0 || m.EpisodeNum > 0)
|
||||
}
|
||||
|
||||
// seriesGroupKey 是「同一部剧」的归并键。SeriesID 优先;缺省时退回
|
||||
// (库, 标题),这样未刮削的剧集也能归到一组而不是每条历史各算一部剧。
|
||||
func seriesGroupKey(m *model.Media) string {
|
||||
if m == nil {
|
||||
return ""
|
||||
}
|
||||
if key := strings.TrimSpace(m.SeriesID); key != "" {
|
||||
return "sid:" + key
|
||||
}
|
||||
if !mediaIsEpisode(m) {
|
||||
return ""
|
||||
}
|
||||
return "lib:" + m.LibraryID + "|title:" + strings.ToLower(strings.TrimSpace(m.Title))
|
||||
}
|
||||
|
||||
// nextUpHistoryScanLimit 是扫描播放历史的上限。历史按最近观看倒序取,
|
||||
// 因此截断只会丢掉「很久没看且排在很后面」的剧,不会影响首页前排。
|
||||
const nextUpHistoryScanLimit = 100
|
||||
|
||||
// NextUpCandidates 返回「每部在看的剧的下一个待看集」,按最近观看时间排序。
|
||||
//
|
||||
// 语义要点:
|
||||
// - 只处理剧集,电影由 Resume 接口负责,避免两个接口内容重复。
|
||||
// - 同一部剧最多一条:取最近看过的集合之后、编号最小的那集。
|
||||
// - 已标记看完的集跳过;追到最后一集则该剧不出现在结果里。
|
||||
func (s *MediaDiscoveryService) NextUpCandidates(ctx context.Context, userID string, limit int, visibility MediaVisibility) ([]model.Media, error) {
|
||||
if s == nil || s.repo == nil || s.repo.Media == nil {
|
||||
return nil, nil
|
||||
}
|
||||
if strings.TrimSpace(userID) == "" {
|
||||
return nil, nil
|
||||
}
|
||||
if limit <= 0 {
|
||||
limit = 20
|
||||
}
|
||||
|
||||
// Bug 1 fix: include completed histories as anchors so a finished episode
|
||||
// still anchors its series and the next unwatched episode is picked.
|
||||
var histories []model.PlaybackHistory
|
||||
if err := s.repo.DB.WithContext(ctx).
|
||||
Where("user_id = ? AND position_ms > 0", userID).
|
||||
Order("watched_at desc").
|
||||
Limit(nextUpHistoryScanLimit).
|
||||
Find(&histories).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if len(histories) == 0 {
|
||||
return nil, nil
|
||||
}
|
||||
|
||||
mediaIDs := make([]string, 0, len(histories))
|
||||
for _, h := range histories {
|
||||
mediaIDs = append(mediaIDs, h.MediaID)
|
||||
}
|
||||
filter := mediaFilterFromVisibility(visibility)
|
||||
var watchedRows []model.Media
|
||||
q := s.repo.DB.WithContext(ctx).Where("id IN ?", mediaIDs)
|
||||
q = applyDiscoveryVisibility(q, filter)
|
||||
if err := q.Find(&watchedRows).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
byID := make(map[string]*model.Media, len(watchedRows))
|
||||
for i := range watchedRows {
|
||||
byID[watchedRows[i].ID] = &watchedRows[i]
|
||||
}
|
||||
|
||||
// 按最近观看顺序归并到「剧」维度,同时记住该剧最近看的那一集以及它是否看完。
|
||||
type seriesState struct {
|
||||
key string
|
||||
current *model.Media
|
||||
completed bool
|
||||
}
|
||||
states := make([]seriesState, 0, len(histories))
|
||||
seen := make(map[string]bool, len(histories))
|
||||
for _, h := range histories {
|
||||
m := byID[h.MediaID]
|
||||
if m == nil || !mediaIsEpisode(m) {
|
||||
continue
|
||||
}
|
||||
key := seriesGroupKey(m)
|
||||
if key == "" || seen[key] {
|
||||
continue
|
||||
}
|
||||
seen[key] = true
|
||||
states = append(states, seriesState{key: key, current: m, completed: h.Completed})
|
||||
}
|
||||
if len(states) == 0 {
|
||||
return nil, nil
|
||||
}
|
||||
|
||||
// 一次性把涉及的剧集全部取回,避免按剧逐条查询。
|
||||
//
|
||||
// Bug 4 fix: group by library_id when fetching by series_id so episodes
|
||||
// from a different library with the same series_id don't bleed in.
|
||||
// Bug 5 fix: batch unscraped (library_id, title) lookups per library
|
||||
// instead of one query per series.
|
||||
byLibSeries := make(map[string][]string) // libID -> []seriesID
|
||||
var fallback []seriesState
|
||||
for _, st := range states {
|
||||
if id := strings.TrimSpace(st.current.SeriesID); id != "" {
|
||||
byLibSeries[st.current.LibraryID] = append(byLibSeries[st.current.LibraryID], id)
|
||||
} else {
|
||||
fallback = append(fallback, st)
|
||||
}
|
||||
}
|
||||
|
||||
episodes := make([]model.Media, 0, len(states)*8)
|
||||
// 按库批量加载刮削剧集,避免跨库混入同名 series_id 的剧集。
|
||||
for libID, sids := range byLibSeries {
|
||||
var rows []model.Media
|
||||
eq := s.repo.DB.WithContext(ctx).Where("series_id IN ? AND library_id = ?", sids, libID)
|
||||
eq = applyDiscoveryVisibility(eq, filter)
|
||||
if err := eq.Find(&rows).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
episodes = append(episodes, rows...)
|
||||
}
|
||||
// 未刮削剧集按 (库, 标题) 批量兜底查询,每库一条 SQL 避免 N+1。
|
||||
byLibTitles := make(map[string][]string) // libID -> []title
|
||||
for _, st := range fallback {
|
||||
byLibTitles[st.current.LibraryID] = append(byLibTitles[st.current.LibraryID], st.current.Title)
|
||||
}
|
||||
for libID, titles := range byLibTitles {
|
||||
var rows []model.Media
|
||||
fq := s.repo.DB.WithContext(ctx).Where("library_id = ? AND title IN ?", libID, titles)
|
||||
fq = applyDiscoveryVisibility(fq, filter)
|
||||
if err := fq.Find(&rows).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
episodes = append(episodes, rows...)
|
||||
}
|
||||
|
||||
// 按剧归并候选集,便于 O(1) 查找下一集。
|
||||
bySeries := make(map[string][]model.Media, len(states))
|
||||
for _, row := range episodes {
|
||||
key := seriesGroupKey(&row)
|
||||
if key == "" {
|
||||
continue
|
||||
}
|
||||
bySeries[key] = append(bySeries[key], row)
|
||||
}
|
||||
completed := s.completedMediaIDs(ctx, userID, episodes)
|
||||
|
||||
out := make([]model.Media, 0, limit)
|
||||
for _, st := range states {
|
||||
if len(out) >= limit {
|
||||
break
|
||||
}
|
||||
next, ok := pickNextEpisode(bySeries[st.key], st.current, st.completed, completed)
|
||||
if !ok {
|
||||
continue
|
||||
}
|
||||
out = append(out, next)
|
||||
}
|
||||
return out, nil
|
||||
}
|
||||
|
||||
// applyDiscoveryVisibility 把可见性过滤应用到查询上。
|
||||
func applyDiscoveryVisibility(q *gorm.DB, filter repository.MediaQueryFilter) *gorm.DB {
|
||||
if !filter.IncludeNSFW {
|
||||
q = q.Where("nsfw = ?", false)
|
||||
}
|
||||
if len(filter.HiddenLibraryIDs) > 0 {
|
||||
q = q.Where("library_id NOT IN ?", filter.HiddenLibraryIDs)
|
||||
}
|
||||
if len(filter.AllowedLibraryIDs) > 0 {
|
||||
q = q.Where("library_id IN ?", filter.AllowedLibraryIDs)
|
||||
}
|
||||
if libraryID := strings.TrimSpace(filter.LibraryID); libraryID != "" {
|
||||
q = q.Where("library_id = ?", libraryID)
|
||||
}
|
||||
return q
|
||||
}
|
||||
|
||||
// completedMediaIDs 找出这些候选里该用户已标记看完的集。
|
||||
func (s *MediaDiscoveryService) completedMediaIDs(ctx context.Context, userID string, rows []model.Media) map[string]bool {
|
||||
out := make(map[string]bool)
|
||||
if len(rows) == 0 {
|
||||
return out
|
||||
}
|
||||
ids := make([]string, 0, len(rows))
|
||||
for _, row := range rows {
|
||||
ids = append(ids, row.ID)
|
||||
}
|
||||
var done []model.PlaybackHistory
|
||||
if err := s.repo.DB.WithContext(ctx).
|
||||
Where("user_id = ? AND completed = ? AND media_id IN ?", userID, true, ids).
|
||||
Find(&done).Error; err != nil {
|
||||
return out
|
||||
}
|
||||
for _, h := range done {
|
||||
out[h.MediaID] = true
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// pickNextEpisode 选出这部剧「接下来该看的那一集」。
|
||||
//
|
||||
// anchor 是这部剧最近一次播放的那一集,anchorCompleted 表示那一集是否已看完:
|
||||
// - 没看完(只播了几秒就退出、或中途暂停)时,接下来该看的仍是这一集本身。
|
||||
// 否则详情页的「继续播放」会直接跳到下一集,用户刚看的那一集被静默跳过。
|
||||
// - 已看完时,才在候选集里取严格晚于它的、编号最小的一集;比较顺序为
|
||||
// (季, 集),因此跨季时自然落到下一季第一集。
|
||||
func pickNextEpisode(candidates []model.Media, anchor *model.Media, anchorCompleted bool, completed map[string]bool) (model.Media, bool) {
|
||||
if anchor == nil {
|
||||
return model.Media{}, false
|
||||
}
|
||||
if !anchorCompleted {
|
||||
return *anchor, true
|
||||
}
|
||||
var best model.Media
|
||||
found := false
|
||||
for _, candidate := range candidates {
|
||||
if candidate.ID == anchor.ID || completed[candidate.ID] {
|
||||
continue
|
||||
}
|
||||
if !episodeAfter(candidate, *anchor) {
|
||||
continue
|
||||
}
|
||||
if !found || episodeBefore(candidate, best) {
|
||||
best = candidate
|
||||
found = true
|
||||
}
|
||||
}
|
||||
return best, found
|
||||
}
|
||||
|
||||
// episodeAfter 报告 a 是否严格晚于 b。
|
||||
func episodeAfter(a, b model.Media) bool {
|
||||
if a.SeasonNum != b.SeasonNum {
|
||||
return a.SeasonNum > b.SeasonNum
|
||||
}
|
||||
return a.EpisodeNum > b.EpisodeNum
|
||||
}
|
||||
|
||||
// episodeBefore 报告 a 是否严格早于 b。
|
||||
func episodeBefore(a, b model.Media) bool {
|
||||
if a.SeasonNum != b.SeasonNum {
|
||||
return a.SeasonNum < b.SeasonNum
|
||||
}
|
||||
return a.EpisodeNum < b.EpisodeNum
|
||||
}
|
||||
|
||||
// similarCandidateLimit 是每个来源池(同库 / 同类型其他库)的候选上限。
|
||||
//
|
||||
// 相似度需要在内存里按类型/年份/评分算分,因此不能把整库拉出来;按评分倒序
|
||||
// 取前 N 条是「好的片子更可能被推荐」与「查询有界」之间的折中。
|
||||
const similarCandidateLimit = 400
|
||||
|
||||
// SimilarCandidates 返回与源条目相似的本地媒体。
|
||||
//
|
||||
// 打分口径(不依赖任何外部 API,离线可用):
|
||||
// - 类型重合数 × 10:最强信号,同类内容通常才谈得上相似;
|
||||
// - 年份接近度:相差 5 年内给分,差得越远越低;
|
||||
// - 评分接近度:同为高分片算加分,避免「8 分片旁边推 3 分片」。
|
||||
//
|
||||
// 同库优先;不足时才从同类型的其它可见库里补齐。同剧其它集与自身一律排除。
|
||||
func (s *MediaDiscoveryService) SimilarCandidates(ctx context.Context, mediaID string, limit int, visibility MediaVisibility) ([]model.Media, error) {
|
||||
if s == nil || s.repo == nil || s.repo.Media == nil {
|
||||
return nil, nil
|
||||
}
|
||||
if limit <= 0 {
|
||||
limit = 12
|
||||
}
|
||||
source, err := s.repo.Media.FindByID(ctx, mediaID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if source == nil || !visibility.Allows(source) {
|
||||
return nil, nil
|
||||
}
|
||||
|
||||
filter := mediaFilterFromVisibility(visibility)
|
||||
|
||||
pool, err := s.similarPool(ctx, filter, source, false)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if len(pool) < limit {
|
||||
// 同库不够时再扩到同类型库,保持「电影配电影、剧集配剧集」的直觉。
|
||||
more, err := s.similarPool(ctx, filter, source, true)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
pool = append(pool, more...)
|
||||
}
|
||||
|
||||
return rankSimilar(source, pool, limit), nil
|
||||
}
|
||||
|
||||
// similarPool 取一批候选。expand=true 时排除源所在的库(用于补齐阶段),
|
||||
// 否则只取源所在的库(首选阶段)。
|
||||
func (s *MediaDiscoveryService) similarPool(ctx context.Context, filter repository.MediaQueryFilter, source *model.Media, expand bool) ([]model.Media, error) {
|
||||
q := s.repo.DB.WithContext(ctx).Model(&model.Media{})
|
||||
q = applyDiscoveryVisibility(q, filter)
|
||||
q = q.Where("id <> ?", source.ID)
|
||||
|
||||
libraryIDs := []string{source.LibraryID}
|
||||
if expand {
|
||||
ids, err := s.compatibleLibraryIDs(ctx, source)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
filtered := make([]string, 0, len(ids))
|
||||
for _, id := range ids {
|
||||
if id != source.LibraryID {
|
||||
filtered = append(filtered, id)
|
||||
}
|
||||
}
|
||||
if len(filtered) == 0 {
|
||||
return nil, nil
|
||||
}
|
||||
libraryIDs = filtered
|
||||
}
|
||||
q = q.Where("library_id IN ?", libraryIDs)
|
||||
|
||||
// 电影与剧集不互相推荐:用集号判定,和 NextUp 保持同一套口径。
|
||||
if mediaIsEpisode(source) {
|
||||
q = q.Where("(season_num > 0 OR episode_num > 0)")
|
||||
} else {
|
||||
q = q.Where("season_num = 0 AND episode_num = 0")
|
||||
}
|
||||
|
||||
var rows []model.Media
|
||||
if err := q.Order("rating desc, updated_at desc").Limit(similarCandidateLimit).Find(&rows).Error; err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return rows, nil
|
||||
}
|
||||
|
||||
// compatibleLibraryIDs 返回与源条目同类型的库 ID(可能包含源库自身)。
|
||||
// 查不到类型时退回源库,保证补齐阶段不会跨类型乱推。
|
||||
func (s *MediaDiscoveryService) compatibleLibraryIDs(ctx context.Context, source *model.Media) ([]string, error) {
|
||||
if s.repo.Library == nil {
|
||||
return []string{source.LibraryID}, nil
|
||||
}
|
||||
libs, err := s.repo.Library.List(ctx)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
sourceType := ""
|
||||
for _, lib := range libs {
|
||||
if lib.ID == source.LibraryID {
|
||||
sourceType = strings.ToLower(strings.TrimSpace(lib.Type))
|
||||
break
|
||||
}
|
||||
}
|
||||
if sourceType == "" {
|
||||
return []string{source.LibraryID}, nil
|
||||
}
|
||||
out := make([]string, 0, len(libs))
|
||||
for _, lib := range libs {
|
||||
if strings.ToLower(strings.TrimSpace(lib.Type)) == sourceType {
|
||||
out = append(out, lib.ID)
|
||||
}
|
||||
}
|
||||
return out, nil
|
||||
}
|
||||
|
||||
// rankSimilar 按相似度排序并截断。
|
||||
func rankSimilar(source *model.Media, pool []model.Media, limit int) []model.Media {
|
||||
if len(pool) == 0 {
|
||||
return nil
|
||||
}
|
||||
sourceGenres := genreSet(source.Genres)
|
||||
sourceKey := seriesGroupKey(source)
|
||||
|
||||
type scored struct {
|
||||
media model.Media
|
||||
score float64
|
||||
}
|
||||
scoredRows := make([]scored, 0, len(pool))
|
||||
seen := make(map[string]bool, len(pool))
|
||||
for _, candidate := range pool {
|
||||
if candidate.ID == source.ID || seen[candidate.ID] {
|
||||
continue
|
||||
}
|
||||
// 同剧其它集不参与:「相似」不是在推荐本剧的下一集。
|
||||
if key := seriesGroupKey(&candidate); key != "" && key == sourceKey {
|
||||
continue
|
||||
}
|
||||
seen[candidate.ID] = true
|
||||
scoredRows = append(scoredRows, scored{
|
||||
media: candidate,
|
||||
score: similarScore(source, &candidate, sourceGenres),
|
||||
})
|
||||
}
|
||||
sort.SliceStable(scoredRows, func(i, j int) bool {
|
||||
if scoredRows[i].score != scoredRows[j].score {
|
||||
return scoredRows[i].score > scoredRows[j].score
|
||||
}
|
||||
if scoredRows[i].media.Rating != scoredRows[j].media.Rating {
|
||||
return scoredRows[i].media.Rating > scoredRows[j].media.Rating
|
||||
}
|
||||
return scoredRows[i].media.Title < scoredRows[j].media.Title
|
||||
})
|
||||
|
||||
if len(scoredRows) > limit {
|
||||
scoredRows = scoredRows[:limit]
|
||||
}
|
||||
out := make([]model.Media, 0, len(scoredRows))
|
||||
for _, row := range scoredRows {
|
||||
out = append(out, row.media)
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// similarScore 计算单个候选的相似度。
|
||||
func similarScore(source, candidate *model.Media, sourceGenres map[string]struct{}) float64 {
|
||||
score := float64(genreOverlap(sourceGenres, genreSet(candidate.Genres))) * 10
|
||||
|
||||
if source.Year > 0 && candidate.Year > 0 {
|
||||
diff := source.Year - candidate.Year
|
||||
if diff < 0 {
|
||||
diff = -diff
|
||||
}
|
||||
if diff <= 5 {
|
||||
score += float64(5 - diff)
|
||||
}
|
||||
}
|
||||
|
||||
if source.Rating > 0 && candidate.Rating > 0 {
|
||||
diff := float64(source.Rating - candidate.Rating)
|
||||
if diff < 0 {
|
||||
diff = -diff
|
||||
}
|
||||
// 评分差 2 分以内才给分,最多 3 分。
|
||||
if diff < 2 {
|
||||
score += 3 * (2 - diff) / 2
|
||||
}
|
||||
}
|
||||
|
||||
return score
|
||||
}
|
||||
@@ -0,0 +1,287 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"strconv"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// seedEpisode 插入一集,并把播放历史指向 `watched`(nil 表示没有历史)。
|
||||
//
|
||||
// position_ms / duration_ms 只是占位值,NextUp 只看历史行的 completed 字段:
|
||||
// 未看完的那一集本身就是「接下来该看的一集」。
|
||||
func seedEpisode(
|
||||
t *testing.T,
|
||||
repos *repository.Container,
|
||||
libID, seriesID, title string,
|
||||
season, episode int,
|
||||
watchedAt *time.Time,
|
||||
completed bool,
|
||||
) *model.Media {
|
||||
t.Helper()
|
||||
m := &model.Media{
|
||||
LibraryID: libID,
|
||||
SeriesID: seriesID,
|
||||
Title: title,
|
||||
SeasonNum: season,
|
||||
EpisodeNum: episode,
|
||||
Path: "/media/" + seriesID + "/S" + strconv.Itoa(season) + "E" + strconv.Itoa(episode) + ".mkv",
|
||||
}
|
||||
if err := repos.DB.WithContext(context.Background()).Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if watchedAt != nil || completed {
|
||||
// 标记「已看完」也会产生一条历史行,因此 completed 为真时同样要写历史,
|
||||
// 否则夹具与真实数据不一致(真实库里已看完一定有行)。
|
||||
watched := time.Now().Add(-time.Hour)
|
||||
if watchedAt != nil {
|
||||
watched = *watchedAt
|
||||
}
|
||||
h := &model.PlaybackHistory{
|
||||
UserID: "user-1",
|
||||
MediaID: m.ID,
|
||||
PositionMs: 1000,
|
||||
DurationMs: 2000,
|
||||
WatchedAt: watched,
|
||||
Completed: completed,
|
||||
}
|
||||
if err := repos.DB.WithContext(context.Background()).Create(h).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
return m
|
||||
}
|
||||
|
||||
func nextUpIDs(t *testing.T, svc *MediaDiscoveryService, visibility MediaVisibility) []string {
|
||||
t.Helper()
|
||||
rows, err := svc.NextUpCandidates(context.Background(), "user-1", 20, visibility)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
out := make([]string, 0, len(rows))
|
||||
for _, row := range rows {
|
||||
out = append(out, episodeLabel(row))
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// episodeLabel 把一集渲染成 "S1E2",方便断言。
|
||||
func episodeLabel(m model.Media) string {
|
||||
return "S" + strconv.Itoa(m.SeasonNum) + "E" + strconv.Itoa(m.EpisodeNum)
|
||||
}
|
||||
|
||||
func TestNextUpPicksNextEpisode(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, &watchedAt, true) // 第 1 集已看完
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, nil, false)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 3, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S1E2" {
|
||||
t.Fatalf("next up = %v, want [S1E2]", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 回归:只播了几秒就退出(未看完)时,「接下来该看的一集」仍是这一集本身。
|
||||
// 客户端(Yamby 等)剧集详情页的「继续播放」直接取 NextUp 第一条,跳集会播错集。
|
||||
func TestNextUpKeepsPartiallyWatchedEpisode(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Minute)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, nil, true)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, &watchedAt, false) // 第 2 集只看了几秒
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 3, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S1E2" {
|
||||
t.Fatalf("next up = %v, want [S1E2] (未看完的那一集不能跳过)", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 未看完的是这部剧的最后一集时也要返回它,不能因为「后面没有集了」而返回空。
|
||||
func TestNextUpKeepsPartiallyWatchedFinalEpisode(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Minute)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, nil, true)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, &watchedAt, false) // 最后一集未看完
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S1E2" {
|
||||
t.Fatalf("next up = %v, want [S1E2]", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 电影不进 NextUp:NextUp 的语义是「下一集」,电影由 Resume 接口负责。
|
||||
func TestNextUpSkipsMovies(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "", "电影", 0, 0, &watchedAt, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
if got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true}); len(got) != 0 {
|
||||
t.Fatalf("next up = %v, want empty", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 同一部剧有多条未看完历史时,只能出一条,且指向最靠后的已看集的下一集。
|
||||
// 同一部剧有多条未看完历史时只能出一条,且指向最近看过的那一集。
|
||||
//
|
||||
// 最近那一集(S1E2)本身还没看完,所以它就是「接下来该看的一集」;
|
||||
// S1E1 只是更早的中间进度,不能据此跳到 S1E3。
|
||||
func TestNextUpOneEntryPerSeries(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
older := time.Now().Add(-48 * time.Hour)
|
||||
newer := time.Now().Add(-2 * time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, &older, false)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, &newer, false)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 3, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S1E2" {
|
||||
t.Fatalf("next up = %v, want [S1E2]", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 跨季时下一集应是下一季的第一集。
|
||||
func TestNextUpCrossesSeason(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 12, &watchedAt, true) // 第 1 季最后一集已看完
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 2, 1, nil, false)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 2, 2, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S2E1" {
|
||||
t.Fatalf("next up = %v, want [S2E1]", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 已标记看完的下一集要跳过。
|
||||
func TestNextUpSkipsCompletedEpisode(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, &watchedAt, true) // 已看完,下一集是 S1E3
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, nil, true) // 已看完
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 3, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S1E3" {
|
||||
t.Fatalf("next up = %v, want [S1E3]", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 追到最后一集且已看完时没有下一集,结果为空而不是重复返回最后一集。
|
||||
func TestNextUpEmptyAtSeriesEnd(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 3, &watchedAt, true)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
if got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true}); len(got) != 0 {
|
||||
t.Fatalf("next up = %v, want empty", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 不可见媒体库里的下一集不能被推荐出去。
|
||||
func TestNextUpRespectsVisibility(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
visibleLib := seedDiscoveryLibrary(t, repos, "tv")
|
||||
hiddenLib := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, visibleLib, "series-1", "剧一", 1, 1, &watchedAt, true)
|
||||
seedEpisode(t, repos, hiddenLib, "series-1", "剧一", 1, 2, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true, AllowedLibraryIDs: []string{visibleLib}})
|
||||
if len(got) != 0 {
|
||||
t.Fatalf("next up = %v, want empty (hidden library)", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 最后一集看完(completed=true)后,下一部剧仍应出现在 NextUp 中,
|
||||
// 而不是因为没有 completed=false 的历史而消失(bug 1 回归测试)。
|
||||
func TestNextUpAfterCompletedEpisode(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
// S1E1 已看完,S1E2 尚未开始。
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, &watchedAt, true)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, nil, false)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 3, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true})
|
||||
if len(got) != 1 || got[0] != "S1E2" {
|
||||
t.Fatalf("next up after completed S1E1 = %v, want [S1E2]", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 整部剧看完(所有集都 completed=true)时不应出现在 NextUp(没有下一集)。
|
||||
func TestNextUpSeriesFullyWatchedIsEmpty(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
watchedAt := time.Now().Add(-time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 1, nil, true)
|
||||
seedEpisode(t, repos, libID, "series-1", "剧一", 1, 2, &watchedAt, true) // 最近看完的最后一集
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
if got := nextUpIDs(t, svc, MediaVisibility{IncludeNSFW: true}); len(got) != 0 {
|
||||
t.Fatalf("next up for fully-watched series = %v, want empty", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 多部剧时按最近观看时间排序。
|
||||
func TestNextUpOrdersByRecency(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
older := time.Now().Add(-24 * time.Hour)
|
||||
newer := time.Now().Add(-1 * time.Hour)
|
||||
|
||||
seedEpisode(t, repos, libID, "series-a", "剧A", 1, 1, &older, false)
|
||||
seedEpisode(t, repos, libID, "series-a", "剧A", 1, 2, nil, false)
|
||||
seedEpisode(t, repos, libID, "series-b", "剧B", 1, 1, &newer, false)
|
||||
seedEpisode(t, repos, libID, "series-b", "剧B", 1, 2, nil, false)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
rows, err := svc.NextUpCandidates(context.Background(), "user-1", 20, MediaVisibility{IncludeNSFW: true})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(rows) != 2 {
|
||||
t.Fatalf("rows = %d, want 2", len(rows))
|
||||
}
|
||||
if rows[0].SeriesID != "series-b" {
|
||||
t.Fatalf("first row series = %q, want series-b (most recently watched)", rows[0].SeriesID)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,167 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"testing"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
func seedSimilarMedia(t *testing.T, repos *repository.Container, libID, title, genres string, year int, rating float32) *model.Media {
|
||||
t.Helper()
|
||||
m := &model.Media{
|
||||
LibraryID: libID,
|
||||
Title: title,
|
||||
Genres: genres,
|
||||
Year: year,
|
||||
Rating: rating,
|
||||
Path: "/media/" + libID + "/" + title + ".mkv",
|
||||
}
|
||||
if err := repos.DB.WithContext(context.Background()).Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
return m
|
||||
}
|
||||
|
||||
func similarTitles(t *testing.T, svc *MediaDiscoveryService, sourceID string, visibility MediaVisibility) []string {
|
||||
t.Helper()
|
||||
rows, err := svc.SimilarCandidates(context.Background(), sourceID, 12, visibility)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
out := make([]string, 0, len(rows))
|
||||
for _, row := range rows {
|
||||
out = append(out, row.Title)
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
func containsTitle(items []string, want string) bool {
|
||||
for _, item := range items {
|
||||
if item == want {
|
||||
return true
|
||||
}
|
||||
}
|
||||
return false
|
||||
}
|
||||
|
||||
// 相似推荐必须排除自己,也要排除同剧的其他集(否则详情页会推荐本剧的其它集)。
|
||||
func TestSimilarExcludesSelfAndSameSeries(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "tv")
|
||||
|
||||
source := seedSimilarMedia(t, repos, libID, "剧一 E01", "Action", 2020, 8)
|
||||
source.SeriesID = "series-1"
|
||||
source.SeasonNum, source.EpisodeNum = 1, 1
|
||||
if err := repos.DB.WithContext(context.Background()).Save(source).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
sibling := seedSimilarMedia(t, repos, libID, "剧一 E02", "Action", 2020, 8)
|
||||
sibling.SeriesID = "series-1"
|
||||
sibling.SeasonNum, sibling.EpisodeNum = 1, 2
|
||||
if err := repos.DB.WithContext(context.Background()).Save(sibling).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
// 同库另一部剧的第 1 集:这才是剧集详情页该推荐的内容。
|
||||
other := seedSimilarMedia(t, repos, libID, "另一部动作剧", "Action", 2021, 7)
|
||||
other.SeriesID = "series-2"
|
||||
other.SeasonNum, other.EpisodeNum = 1, 1
|
||||
if err := repos.DB.WithContext(context.Background()).Save(other).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := similarTitles(t, svc, source.ID, MediaVisibility{IncludeNSFW: true})
|
||||
|
||||
if containsTitle(got, "剧一 E01") {
|
||||
t.Fatalf("result must exclude the source itself: %v", got)
|
||||
}
|
||||
if containsTitle(got, "剧一 E02") {
|
||||
t.Fatalf("result must exclude other episodes of the same series: %v", got)
|
||||
}
|
||||
if !containsTitle(got, "另一部动作剧") {
|
||||
t.Fatalf("result = %v, want it to contain 另一部动作剧", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 类型重合度高的条目要排在前面。
|
||||
func TestSimilarPrefersGenreOverlap(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
|
||||
source := seedSimilarMedia(t, repos, libID, "源片", "Action,Adventure", 2010, 7)
|
||||
seedSimilarMedia(t, repos, libID, "同类型", "Action,Adventure", 2010, 7)
|
||||
seedSimilarMedia(t, repos, libID, "弱相关", "Comedy", 2010, 7)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := similarTitles(t, svc, source.ID, MediaVisibility{IncludeNSFW: true})
|
||||
|
||||
if len(got) < 2 {
|
||||
t.Fatalf("result = %v, want at least 2 entries", got)
|
||||
}
|
||||
if got[0] != "同类型" {
|
||||
t.Fatalf("result = %v, want 同类型 ranked first", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 不可见媒体库的条目不能被推荐。
|
||||
func TestSimilarRespectsVisibility(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
sourceLib := seedDiscoveryLibrary(t, repos, "movie")
|
||||
hiddenLib := seedDiscoveryLibrary(t, repos, "movie")
|
||||
|
||||
source := seedSimilarMedia(t, repos, sourceLib, "源片", "Action", 2010, 7)
|
||||
seedSimilarMedia(t, repos, hiddenLib, "隐藏片", "Action", 2010, 7)
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
got := similarTitles(t, svc, source.ID, MediaVisibility{IncludeNSFW: true, AllowedLibraryIDs: []string{sourceLib}})
|
||||
|
||||
if containsTitle(got, "隐藏片") {
|
||||
t.Fatalf("hidden library leaked into similar: %v", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 源条目不可见或不存在时返回空,不报错:客户端不该因此看到 500。
|
||||
func TestSimilarUnknownSourceReturnsEmpty(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
|
||||
rows, err := svc.SimilarCandidates(context.Background(), "missing", 12, MediaVisibility{IncludeNSFW: true})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(rows) != 0 {
|
||||
t.Fatalf("rows = %v, want empty", rows)
|
||||
}
|
||||
}
|
||||
|
||||
// limit 生效,且不返回重复条目。
|
||||
func TestSimilarHonoursLimit(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
source := seedSimilarMedia(t, repos, libID, "源片", "Action", 2010, 7)
|
||||
for i := 0; i < 5; i++ {
|
||||
seedSimilarMedia(t, repos, libID, "候选"+string(rune('A'+i)), "Action", 2010, 7)
|
||||
}
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
rows, err := svc.SimilarCandidates(context.Background(), source.ID, 3, MediaVisibility{IncludeNSFW: true})
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(rows) != 3 {
|
||||
t.Fatalf("rows = %d, want 3", len(rows))
|
||||
}
|
||||
seen := map[string]bool{}
|
||||
for _, row := range rows {
|
||||
if seen[row.ID] {
|
||||
t.Fatalf("duplicate row %q in result", row.Title)
|
||||
}
|
||||
seen[row.ID] = true
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,136 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"testing"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// newDiscoveryTestDB 建好内存库并返回 repository 容器。
|
||||
func newDiscoveryTestDB(t *testing.T) *repository.Container {
|
||||
t.Helper()
|
||||
return repository.New(newServiceTestDB(t))
|
||||
}
|
||||
|
||||
func seedDiscoveryLibrary(t *testing.T, repos *repository.Container, typ string) string {
|
||||
t.Helper()
|
||||
lib := &model.Library{Name: "库-" + typ, Path: "/media/" + typ, Type: typ, Enabled: true}
|
||||
if err := repos.Library.Create(context.Background(), lib); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
return lib.ID
|
||||
}
|
||||
|
||||
func seedDiscoveryMedia(t *testing.T, repos *repository.Container, m *model.Media) {
|
||||
t.Helper()
|
||||
if err := repos.DB.WithContext(context.Background()).Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
func findGenre(genres []GenreCount, name string) int {
|
||||
for _, g := range genres {
|
||||
if g.Name == name {
|
||||
return g.Count
|
||||
}
|
||||
}
|
||||
return -1
|
||||
}
|
||||
|
||||
func TestAggregateGenresSplitsAndCounts(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: libID, Title: "A", Path: "/media/movie/a.mkv", Genres: "Action,Drama",
|
||||
})
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: libID, Title: "B", Path: "/media/movie/b.mkv", Genres: "action",
|
||||
})
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
genres, err := svc.AggregateGenres(context.Background(), MediaVisibility{IncludeNSFW: true}, "")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
// 大小写不同视为同一类型,展示名保留首次出现的写法。
|
||||
if got := findGenre(genres, "Action"); got != 2 {
|
||||
t.Fatalf("Action count = %d, want 2 (genres=%+v)", got, genres)
|
||||
}
|
||||
if got := findGenre(genres, "Drama"); got != 1 {
|
||||
t.Fatalf("Drama count = %d, want 1 (genres=%+v)", got, genres)
|
||||
}
|
||||
}
|
||||
|
||||
// 中文全角逗号在刮削结果里同样常见,必须一并切分。
|
||||
func TestAggregateGenresHandlesFullWidthComma(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
libID := seedDiscoveryLibrary(t, repos, "movie")
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: libID, Title: "A", Path: "/media/movie/a.mkv", Genres: "科幻,悬疑",
|
||||
})
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
genres, err := svc.AggregateGenres(context.Background(), MediaVisibility{IncludeNSFW: true}, "")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if findGenre(genres, "科幻") != 1 || findGenre(genres, "悬疑") != 1 {
|
||||
t.Fatalf("genres = %+v, want 科幻:1 and 悬疑:1", genres)
|
||||
}
|
||||
}
|
||||
|
||||
// libraryID 非空时只统计该库,供媒体库页面的筛选项使用。
|
||||
func TestAggregateGenresScopedToLibrary(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
movieLib := seedDiscoveryLibrary(t, repos, "movie")
|
||||
tvLib := seedDiscoveryLibrary(t, repos, "tv")
|
||||
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: movieLib, Title: "A", Path: "/media/movie/a.mkv", Genres: "Action",
|
||||
})
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: tvLib, Title: "B", Path: "/media/tv/b.mkv", Genres: "Comedy",
|
||||
})
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
genres, err := svc.AggregateGenres(context.Background(), MediaVisibility{IncludeNSFW: true}, movieLib)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if findGenre(genres, "Comedy") != -1 {
|
||||
t.Fatalf("Comedy must not appear when scoped to the movie library: %+v", genres)
|
||||
}
|
||||
if findGenre(genres, "Action") != 1 {
|
||||
t.Fatalf("Action count = %d, want 1", findGenre(genres, "Action"))
|
||||
}
|
||||
}
|
||||
|
||||
// 可见性过滤必须生效:不可见的库不应泄漏类型统计。
|
||||
func TestAggregateGenresRespectsVisibility(t *testing.T) {
|
||||
repos := newDiscoveryTestDB(t)
|
||||
allowedLib := seedDiscoveryLibrary(t, repos, "movie")
|
||||
otherLib := seedDiscoveryLibrary(t, repos, "movie")
|
||||
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: allowedLib, Title: "A", Path: "/media/a/a.mkv", Genres: "Action",
|
||||
})
|
||||
seedDiscoveryMedia(t, repos, &model.Media{
|
||||
LibraryID: otherLib, Title: "B", Path: "/media/b/b.mkv", Genres: "Secret",
|
||||
})
|
||||
|
||||
svc := NewMediaDiscoveryService(zap.NewNop(), repos)
|
||||
genres, err := svc.AggregateGenres(context.Background(),
|
||||
MediaVisibility{IncludeNSFW: true, AllowedLibraryIDs: []string{allowedLib}}, "")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if findGenre(genres, "Secret") != -1 {
|
||||
t.Fatalf("hidden library leaked into genres: %+v", genres)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,152 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"math/rand"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// LibraryFacets 是媒体库筛选面板需要的元数据:可选类型与年份区间。
|
||||
type LibraryFacets struct {
|
||||
Genres []GenreCount `json:"genres"`
|
||||
YearMin int `json:"year_min"`
|
||||
YearMax int `json:"year_max"`
|
||||
}
|
||||
|
||||
// libraryFilterFrom 组装「可见性 + 用户筛选」的最终仓储条件,
|
||||
// 与列表查询保持完全一致的语义。
|
||||
func libraryFilterFrom(visibility MediaVisibility, filters MediaListFilters) repository.MediaQueryFilter {
|
||||
return filters.apply(repository.MediaQueryFilter{
|
||||
IncludeNSFW: visibility.IncludeNSFW,
|
||||
AllowedLibraryIDs: visibility.AllowedLibraryIDs,
|
||||
HiddenLibraryIDs: visibility.HiddenLibraryIDs,
|
||||
})
|
||||
}
|
||||
|
||||
// LibraryFacets 返回某个库的筛选项。类型统计复用 MediaDiscoveryService,
|
||||
// 避免在筛选面板与 Emby /Genres 之间出现两套口径。
|
||||
//
|
||||
// 作用范围必须与列表查询一致:列表用的是「合并网盘库」后的库 ID 集合,因此这
|
||||
// 里也把可见性收窄到同一集合,否则筛选项会漏掉列表里真实存在的条目。
|
||||
func (s *MediaService) LibraryFacets(
|
||||
ctx context.Context,
|
||||
libraryID string,
|
||||
visibility MediaVisibility,
|
||||
discovery *MediaDiscoveryService,
|
||||
) (LibraryFacets, error) {
|
||||
var facets LibraryFacets
|
||||
if s == nil || s.repo == nil || s.repo.Media == nil {
|
||||
return facets, nil
|
||||
}
|
||||
visibility = ExpandMediaVisibilityForMergedCloudLibraries(ctx, s.repo, visibility)
|
||||
merged, err := MergedLibraryIDsForLibrary(ctx, s.repo, libraryID)
|
||||
if err != nil {
|
||||
return facets, err
|
||||
}
|
||||
scoped, ok := scopeVisibilityToLibraries(visibility, merged)
|
||||
if !ok {
|
||||
facets.Genres = []GenreCount{}
|
||||
return facets, nil
|
||||
}
|
||||
|
||||
yearMin, yearMax, err := s.repo.Media.YearRange(ctx, libraryFilterFrom(scoped, MediaListFilters{}))
|
||||
if err != nil {
|
||||
return facets, err
|
||||
}
|
||||
facets.YearMin = yearMin
|
||||
facets.YearMax = yearMax
|
||||
|
||||
if discovery != nil {
|
||||
genres, err := discovery.AggregateGenres(ctx, scoped, "")
|
||||
if err != nil {
|
||||
return facets, err
|
||||
}
|
||||
facets.Genres = genres
|
||||
}
|
||||
if facets.Genres == nil {
|
||||
facets.Genres = []GenreCount{}
|
||||
}
|
||||
return facets, nil
|
||||
}
|
||||
|
||||
// scopeVisibilityToLibraries 把可见性收窄到给定库集合。
|
||||
//
|
||||
// 返回 ok=false 表示「这些库与用户的可见性没有交集」——此时必须返回空结果,
|
||||
// 而不是退化成不过滤,否则受限用户会看到别人的库。
|
||||
func scopeVisibilityToLibraries(visibility MediaVisibility, libraryIDs []string) (MediaVisibility, bool) {
|
||||
allowed := make(map[string]struct{}, len(visibility.AllowedLibraryIDs))
|
||||
for _, id := range visibility.AllowedLibraryIDs {
|
||||
allowed[id] = struct{}{}
|
||||
}
|
||||
out := make([]string, 0, len(libraryIDs))
|
||||
for _, id := range libraryIDs {
|
||||
if len(allowed) > 0 {
|
||||
if _, ok := allowed[id]; !ok {
|
||||
continue
|
||||
}
|
||||
}
|
||||
out = append(out, id)
|
||||
}
|
||||
if len(out) == 0 {
|
||||
return visibility, false
|
||||
}
|
||||
visibility.AllowedLibraryIDs = out
|
||||
return visibility, true
|
||||
}
|
||||
|
||||
// RandomMedia 在「可见性 + 筛选」的结果集里随机取一条。
|
||||
//
|
||||
// 实现是「先 COUNT 再随机 offset」的两段查询:SQLite 没有 TABLESAMPLE,
|
||||
// ORDER BY RANDOM() 又会对整库排序(大库上会拖垮磁盘),因此用等价的
|
||||
// 偏移量取法,且两种数据库方言完全一致。
|
||||
//
|
||||
// 返回 (nil, nil) 表示结果集为空,由调用方决定响应码。
|
||||
func (s *MediaService) RandomMedia(
|
||||
ctx context.Context,
|
||||
libraryID string,
|
||||
visibility MediaVisibility,
|
||||
filters MediaListFilters,
|
||||
) (*model.Media, error) {
|
||||
if s == nil || s.repo == nil || s.repo.Media == nil {
|
||||
return nil, nil
|
||||
}
|
||||
visibility = ExpandMediaVisibilityForMergedCloudLibraries(ctx, s.repo, visibility)
|
||||
libraryIDs, err := MergedLibraryIDsForLibrary(ctx, s.repo, libraryID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
filter := libraryFilterFrom(visibility, filters)
|
||||
|
||||
_, total, err := s.repo.Media.ListByLibrariesFiltered(ctx, libraryIDs, 0, 1, filter)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if total <= 0 {
|
||||
return nil, nil
|
||||
}
|
||||
|
||||
// 超大结果集直接对全部记录随机 OFFSET 会让数据库扫描海量行(SQLite 逐行计数)。
|
||||
// 当总量超过阈值时,收窄到按更新时间最新的前 N 条(列表排序首列是
|
||||
// release_date / updated_at,前 randomPoolCap 行即为"最新"子集),
|
||||
// 偏移量取其中随机位置,兼顾性能与覆盖面。
|
||||
const randomPoolCap = 5000
|
||||
effectiveTotal := total
|
||||
if effectiveTotal > randomPoolCap {
|
||||
effectiveTotal = randomPoolCap
|
||||
}
|
||||
offset := 0
|
||||
if effectiveTotal > 1 {
|
||||
offset = rand.Intn(int(effectiveTotal))
|
||||
}
|
||||
items, err := s.repo.Media.ListByLibrariesFilteredNoCount(ctx, libraryIDs, offset, 1, filter)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if len(items) == 0 {
|
||||
return nil, nil
|
||||
}
|
||||
s.attachLibraryMetadata(ctx, items)
|
||||
return &items[0], nil
|
||||
}
|
||||
@@ -0,0 +1,88 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"testing"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
)
|
||||
|
||||
// 系列路径的筛选在内存里复现 SQL 语义,必须与仓储侧一致,否则会出现
|
||||
// 「电影库能筛、剧集库筛不动」的行为差异。
|
||||
func TestMediaRowMatchesFilters(t *testing.T) {
|
||||
row := &model.Media{
|
||||
Base: model.Base{ID: "m1"},
|
||||
Title: "片",
|
||||
Genres: "Action,Drama",
|
||||
Year: 2015,
|
||||
Rating: 7.5,
|
||||
}
|
||||
|
||||
cases := []struct {
|
||||
name string
|
||||
filters MediaListFilters
|
||||
completed map[string]bool
|
||||
want bool
|
||||
}{
|
||||
{name: "no filters", filters: MediaListFilters{}, want: true},
|
||||
{name: "genre hit", filters: MediaListFilters{Genres: []string{"Action"}}, want: true},
|
||||
{name: "genre miss", filters: MediaListFilters{Genres: []string{"Comedy"}}, want: false},
|
||||
{name: "year in range", filters: MediaListFilters{YearMin: 2010, YearMax: 2020}, want: true},
|
||||
{name: "year below min", filters: MediaListFilters{YearMin: 2016}, want: false},
|
||||
{name: "year above max", filters: MediaListFilters{YearMax: 2014}, want: false},
|
||||
{name: "rating ok", filters: MediaListFilters{RatingMin: 7}, want: true},
|
||||
{name: "rating too high", filters: MediaListFilters{RatingMin: 8}, want: false},
|
||||
{name: "unwatched passes", filters: MediaListFilters{Unwatched: true}, want: true},
|
||||
{
|
||||
name: "unwatched excludes completed",
|
||||
filters: MediaListFilters{Unwatched: true},
|
||||
completed: map[string]bool{"m1": true},
|
||||
want: false,
|
||||
},
|
||||
}
|
||||
|
||||
for _, tc := range cases {
|
||||
t.Run(tc.name, func(t *testing.T) {
|
||||
if got := mediaRowMatchesFilters(row, tc.filters, tc.completed); got != tc.want {
|
||||
t.Fatalf("matched = %t, want %t", got, tc.want)
|
||||
}
|
||||
})
|
||||
}
|
||||
}
|
||||
|
||||
// 多词类型(如 "Science Fiction")在内存筛选中必须整词命中。
|
||||
func TestMediaRowMatchesFiltersMultiWordGenre(t *testing.T) {
|
||||
row := &model.Media{
|
||||
Base: model.Base{ID: "m2"},
|
||||
Title: "科幻片",
|
||||
Genres: "Science Fiction,Drama",
|
||||
}
|
||||
cases := []struct {
|
||||
name string
|
||||
filters MediaListFilters
|
||||
want bool
|
||||
}{
|
||||
{name: "multi-word hit", filters: MediaListFilters{Genres: []string{"Science Fiction"}}, want: true},
|
||||
{name: "partial word miss", filters: MediaListFilters{Genres: []string{"Science"}}, want: false},
|
||||
{name: "case insensitive hit", filters: MediaListFilters{Genres: []string{"science fiction"}}, want: true},
|
||||
}
|
||||
for _, tc := range cases {
|
||||
t.Run(tc.name, func(t *testing.T) {
|
||||
if got := mediaRowMatchesFilters(row, tc.filters, nil); got != tc.want {
|
||||
t.Fatalf("matched = %t, want %t", got, tc.want)
|
||||
}
|
||||
})
|
||||
}
|
||||
}
|
||||
|
||||
// 无筛选时 empty() 为真,调用方据此走带缓存的原路径。
|
||||
func TestMediaListFiltersEmpty(t *testing.T) {
|
||||
if !(MediaListFilters{}).empty() {
|
||||
t.Fatal("zero filters must be reported as empty")
|
||||
}
|
||||
if (MediaListFilters{Genres: []string{"Action"}}).empty() {
|
||||
t.Fatal("genre filter must not be reported as empty")
|
||||
}
|
||||
if (MediaListFilters{Unwatched: true}).empty() {
|
||||
t.Fatal("unwatched filter must not be reported as empty")
|
||||
}
|
||||
}
|
||||
@@ -12,11 +12,63 @@ import (
|
||||
)
|
||||
|
||||
// ListMedia paginates media items inside a library.
|
||||
// MediaListFilters 是列表接口的可选筛选条件(来自查询串或库内筛选面板)。
|
||||
//
|
||||
// 与 MediaVisibility 分开:可见性是权限约束(服务端强制),这些是用户主动
|
||||
// 选择的浏览条件,两者在 SQL 层是「与」关系。
|
||||
type MediaListFilters struct {
|
||||
Genres []string
|
||||
YearMin int
|
||||
YearMax int
|
||||
RatingMin float64
|
||||
Unwatched bool
|
||||
// UserID 是「未观看」判定所需的账号;为空时 Unwatched 被忽略。
|
||||
UserID string
|
||||
}
|
||||
|
||||
// empty 报告是否没有任何筛选条件。调用方据此走缓存友好的默认路径。
|
||||
func (f MediaListFilters) empty() bool {
|
||||
return len(f.Genres) == 0 && f.YearMin <= 0 && f.YearMax <= 0 &&
|
||||
f.RatingMin <= 0 && !f.Unwatched
|
||||
}
|
||||
|
||||
// apply 把筛选条件叠加到仓储过滤条件上。
|
||||
func (f MediaListFilters) apply(filter repository.MediaQueryFilter) repository.MediaQueryFilter {
|
||||
if len(f.Genres) > 0 {
|
||||
filter.Genres = f.Genres
|
||||
}
|
||||
if f.YearMin > 0 {
|
||||
filter.YearMin = f.YearMin
|
||||
}
|
||||
if f.YearMax > 0 {
|
||||
filter.YearMax = f.YearMax
|
||||
}
|
||||
if f.RatingMin > 0 {
|
||||
filter.RatingMin = f.RatingMin
|
||||
}
|
||||
if f.Unwatched && strings.TrimSpace(f.UserID) != "" {
|
||||
filter.UnwatchedOnly = true
|
||||
filter.UnwatchedUserID = f.UserID
|
||||
}
|
||||
return filter
|
||||
}
|
||||
|
||||
func (s *MediaService) ListMedia(ctx context.Context, libraryID string, page, pageSize int) ([]model.Media, int64, error) {
|
||||
return s.ListMediaVisible(ctx, libraryID, page, pageSize, MediaVisibility{IncludeNSFW: true})
|
||||
}
|
||||
|
||||
func (s *MediaService) ListMediaVisible(ctx context.Context, libraryID string, page, pageSize int, visibility MediaVisibility) ([]model.Media, int64, error) {
|
||||
return s.ListMediaVisibleFiltered(ctx, libraryID, page, pageSize, visibility, MediaListFilters{})
|
||||
}
|
||||
|
||||
// ListMediaVisibleFiltered 在可见性之上叠加用户筛选条件。
|
||||
func (s *MediaService) ListMediaVisibleFiltered(
|
||||
ctx context.Context,
|
||||
libraryID string,
|
||||
page, pageSize int,
|
||||
visibility MediaVisibility,
|
||||
filters MediaListFilters,
|
||||
) ([]model.Media, int64, error) {
|
||||
if pageSize <= 0 {
|
||||
pageSize = 50
|
||||
}
|
||||
@@ -31,11 +83,11 @@ func (s *MediaService) ListMediaVisible(ctx context.Context, libraryID string, p
|
||||
if err != nil {
|
||||
return nil, 0, err
|
||||
}
|
||||
filter := repository.MediaQueryFilter{
|
||||
filter := filters.apply(repository.MediaQueryFilter{
|
||||
IncludeNSFW: visibility.IncludeNSFW,
|
||||
AllowedLibraryIDs: visibility.AllowedLibraryIDs,
|
||||
HiddenLibraryIDs: visibility.HiddenLibraryIDs,
|
||||
}
|
||||
})
|
||||
cacheKey := s.mediaListCacheKey(libraryID, libraryIDs, page, pageSize, filter)
|
||||
var cached mediaListCacheValue
|
||||
if s.cache != nil && s.cache.GetJSON(ctx, cacheKey, &cached) {
|
||||
@@ -54,7 +106,6 @@ func (s *MediaService) ListMediaVisible(ctx context.Context, libraryID string, p
|
||||
}
|
||||
|
||||
func (s *MediaService) ListMediaVisibleGrouped(ctx context.Context, libraryID string, page, pageSize int, visibility MediaVisibility) ([]MediaItem, int64, error) {
|
||||
page, pageSize = normalizeGroupedMediaPage(page, pageSize)
|
||||
grouped, err := s.GroupedMediaVisible(ctx, libraryID, visibility)
|
||||
if err != nil {
|
||||
return nil, 0, err
|
||||
@@ -65,16 +116,29 @@ func (s *MediaService) ListMediaVisibleGrouped(ctx context.Context, libraryID st
|
||||
// GroupedMediaVisible returns the complete version-grouped media list before pagination.
|
||||
// The result is cached as an immutable slice; sort/pagination callers must copy it before mutating.
|
||||
func (s *MediaService) GroupedMediaVisible(ctx context.Context, libraryID string, visibility MediaVisibility) ([]MediaItem, error) {
|
||||
return s.GroupedMediaVisibleFiltered(ctx, libraryID, visibility, MediaListFilters{})
|
||||
}
|
||||
|
||||
// GroupedMediaVisibleFiltered 在可见性之上叠加用户筛选条件。
|
||||
//
|
||||
// 版本分组的筛选必须作用在原始行上(先筛后分组):否则「按类型筛选」会把
|
||||
// 同一部作品的不同版本拆到不同筛选结果里,出现重复卡片。
|
||||
func (s *MediaService) GroupedMediaVisibleFiltered(
|
||||
ctx context.Context,
|
||||
libraryID string,
|
||||
visibility MediaVisibility,
|
||||
filters MediaListFilters,
|
||||
) ([]MediaItem, error) {
|
||||
visibility = ExpandMediaVisibilityForMergedCloudLibraries(ctx, s.repo, visibility)
|
||||
libraryIDs, err := MergedLibraryIDsForLibrary(ctx, s.repo, libraryID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
filter := repository.MediaQueryFilter{
|
||||
filter := filters.apply(repository.MediaQueryFilter{
|
||||
IncludeNSFW: visibility.IncludeNSFW,
|
||||
AllowedLibraryIDs: visibility.AllowedLibraryIDs,
|
||||
HiddenLibraryIDs: visibility.HiddenLibraryIDs,
|
||||
}
|
||||
})
|
||||
itemsCacheKey := s.groupedItemsCacheKey(libraryID, libraryIDs, filter)
|
||||
value, err, _ := s.groupedMediaFlight.Do(itemsCacheKey, func() (any, error) {
|
||||
if s.cache != nil {
|
||||
@@ -86,7 +150,7 @@ func (s *MediaService) GroupedMediaVisible(ctx context.Context, libraryID string
|
||||
}
|
||||
loadCtx, cancel := context.WithTimeout(context.WithoutCancel(ctx), 2*time.Minute)
|
||||
defer cancel()
|
||||
items, err := s.listMediaVisibleForGrouping(loadCtx, libraryID, visibility)
|
||||
items, err := s.listMediaVisibleForGrouping(loadCtx, libraryID, visibility, filters)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
@@ -105,17 +169,17 @@ func (s *MediaService) GroupedMediaVisible(ctx context.Context, libraryID string
|
||||
return nil, nil
|
||||
}
|
||||
|
||||
func (s *MediaService) listMediaVisibleForGrouping(ctx context.Context, libraryID string, visibility MediaVisibility) ([]model.Media, error) {
|
||||
func (s *MediaService) listMediaVisibleForGrouping(ctx context.Context, libraryID string, visibility MediaVisibility, filters MediaListFilters) ([]model.Media, error) {
|
||||
visibility = ExpandMediaVisibilityForMergedCloudLibraries(ctx, s.repo, visibility)
|
||||
libraryIDs, err := MergedLibraryIDsForLibrary(ctx, s.repo, libraryID)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
filter := repository.MediaQueryFilter{
|
||||
filter := filters.apply(repository.MediaQueryFilter{
|
||||
IncludeNSFW: visibility.IncludeNSFW,
|
||||
AllowedLibraryIDs: visibility.AllowedLibraryIDs,
|
||||
HiddenLibraryIDs: visibility.HiddenLibraryIDs,
|
||||
}
|
||||
})
|
||||
// 版本分组的 URL 分页发生在 Go 进程内,响应里的 total 是分组后的数量,
|
||||
// 不需要数据库再为原始行做一次 COUNT(*)。全量 COUNT 在超大媒体库上
|
||||
// 会重复扫描整个 library_id 范围,而这里只关心是否存在截断风险。
|
||||
@@ -133,8 +197,7 @@ func (s *MediaService) listMediaVisibleForGrouping(ctx context.Context, libraryI
|
||||
}
|
||||
|
||||
// GetMedia returns a single media row.
|
||||
func (s *MediaService) GetMedia(ctx context.Context, id string) (*model.Media, error) {
|
||||
media, err := s.repo.Media.FindByID(ctx, id)
|
||||
func (s *MediaService) GetMedia(ctx context.Context, id string) (*model.Media, error) { media, err := s.repo.Media.FindByID(ctx, id)
|
||||
if err != nil || media == nil {
|
||||
return media, err
|
||||
}
|
||||
|
||||
@@ -0,0 +1,321 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"crypto/sha256"
|
||||
"encoding/hex"
|
||||
"errors"
|
||||
"fmt"
|
||||
"os"
|
||||
"strings"
|
||||
"sync"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/helper"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// 探测结果的缓存与预算策略。
|
||||
const (
|
||||
// mediaProbeTimeout 是一次后台探测的总预算(含把 strm 目标解析成直链)。
|
||||
mediaProbeTimeout = 90 * time.Second
|
||||
// mediaProbeFailureRetry 是探测失败后允许重新探测的间隔。失败的结果也会落库,
|
||||
// 否则每次播放都会为一个坏源重跑一次。
|
||||
mediaProbeFailureRetry = 6 * time.Hour
|
||||
// mediaProbeErrorLimit 限制落库的错误信息长度(列宽 512 字节,错误里可能
|
||||
// 带 URL,截断同时避免超长)。
|
||||
mediaProbeErrorLimit = 200
|
||||
)
|
||||
|
||||
// mediaProber 是 MediaProbeService 需要的探测能力。抽成接口是为了在测试里注入
|
||||
// 桩,避免依赖真实 ffprobe 二进制。
|
||||
type mediaProber interface {
|
||||
ProbeFull(ctx context.Context, input ProbeInput) (*FullProbeResult, error)
|
||||
}
|
||||
|
||||
// MediaProbeService 用 ffprobe 提取媒体的基础信息(容器、每路轨道、内嵌章节)
|
||||
// 并落库缓存。
|
||||
//
|
||||
// 定位是「播放时顺带补齐媒体信息」:STRM / 云盘媒体在扫描阶段拿不到时长,而
|
||||
// 播放链路要用缓存里的时长来换算「延续到片尾」这类区间,详情页将来也直接读这份
|
||||
// 媒体信息。
|
||||
//
|
||||
// 它**不参与片头/片尾判定**:章节标题绝大多数没有语义(生产库实测抽样 64 个
|
||||
// 文件,命中 0 个),拿它去猜跳过点只会给出错误的位置,时间轴数据仍然只信
|
||||
// TheIntroDB。
|
||||
//
|
||||
// 核心约束:一次探测要 2~4.5 秒(远端直链要跨洋跑几次 HTTP 事务),所以只允许
|
||||
// 异步跑,播放链路永远只读缓存。
|
||||
type MediaProbeService struct {
|
||||
log *zap.Logger
|
||||
repo *repository.Container
|
||||
probe mediaProber
|
||||
// resolve 把 strm 播放目标解析成最终直链(含绑定 UA 的请求头)。与转码、
|
||||
// 内嵌字幕发现走同一条换链路径,否则会踩到网盘 CDN 的防盗链 403。
|
||||
resolve func(ctx context.Context, raw, userAgent string) (*StrmPlayResult, error)
|
||||
|
||||
mu sync.Mutex
|
||||
inFlight map[string]struct{}
|
||||
}
|
||||
|
||||
// NewMediaProbeService is the constructor.
|
||||
func NewMediaProbeService(log *zap.Logger, repo *repository.Container, probe *FFprobeService) *MediaProbeService {
|
||||
svc := &MediaProbeService{
|
||||
log: log,
|
||||
repo: repo,
|
||||
inFlight: make(map[string]struct{}),
|
||||
}
|
||||
if probe != nil {
|
||||
svc.probe = probe
|
||||
}
|
||||
return svc
|
||||
}
|
||||
|
||||
// SetPlayTargetResolver injects the strm → direct-link resolver.
|
||||
func (s *MediaProbeService) SetPlayTargetResolver(resolve func(ctx context.Context, raw, userAgent string) (*StrmPlayResult, error)) *MediaProbeService {
|
||||
if s != nil {
|
||||
s.resolve = resolve
|
||||
}
|
||||
return s
|
||||
}
|
||||
|
||||
// EnsureAsync 保证这部媒体的探测已排上队,并立刻返回。
|
||||
//
|
||||
// 已经有同一条媒体的探测在跑、或服务未配置好时返回 false;这次新排上一条返回
|
||||
// true——调用方据此告诉客户端「稍后再拉一次」。
|
||||
func (s *MediaProbeService) EnsureAsync(m *model.Media) bool {
|
||||
if s == nil || s.probe == nil || s.repo == nil || m == nil || strings.TrimSpace(m.ID) == "" {
|
||||
return false
|
||||
}
|
||||
if !s.reserve(m.ID) {
|
||||
return false
|
||||
}
|
||||
// 复制一份媒体行:调用方的对象可能属于请求作用域,后台协程不该继续引用它。
|
||||
snapshot := *m
|
||||
helper.Go(s.log, "service.mediaProbe", func() {
|
||||
defer s.release(snapshot.ID)
|
||||
s.run(context.Background(), &snapshot)
|
||||
})
|
||||
return true
|
||||
}
|
||||
|
||||
func (s *MediaProbeService) reserve(mediaID string) bool {
|
||||
s.mu.Lock()
|
||||
defer s.mu.Unlock()
|
||||
if s.inFlight == nil {
|
||||
s.inFlight = make(map[string]struct{})
|
||||
}
|
||||
if _, running := s.inFlight[mediaID]; running {
|
||||
return false
|
||||
}
|
||||
s.inFlight[mediaID] = struct{}{}
|
||||
return true
|
||||
}
|
||||
|
||||
func (s *MediaProbeService) release(mediaID string) {
|
||||
s.mu.Lock()
|
||||
delete(s.inFlight, mediaID)
|
||||
s.mu.Unlock()
|
||||
}
|
||||
|
||||
// run 执行一次探测并落库。它跑在后台,没有调用方能接收错误,所以任何失败都只
|
||||
// 记录、不外抛。
|
||||
func (s *MediaProbeService) run(ctx context.Context, m *model.Media) {
|
||||
ctx, cancel := context.WithTimeout(ctx, mediaProbeTimeout)
|
||||
defer cancel()
|
||||
|
||||
input, err := s.probeInput(ctx, m)
|
||||
if err != nil {
|
||||
s.markFailure(ctx, m.ID, err)
|
||||
return
|
||||
}
|
||||
result, err := s.probe.ProbeFull(ctx, input)
|
||||
if err != nil {
|
||||
s.markFailure(ctx, m.ID, err)
|
||||
return
|
||||
}
|
||||
if err := s.persistProbe(ctx, m, result); err != nil {
|
||||
s.markFailure(ctx, m.ID, err)
|
||||
}
|
||||
}
|
||||
|
||||
// probeInput 把媒体行解析成 ffprobe 能直接打开的输入。
|
||||
//
|
||||
// 本地文件给路径;STRM / 云盘先解析成最终直链并带上绑定的请求头——直链与 UA
|
||||
// 必须配套,用错会被 CDN 拒绝。
|
||||
func (s *MediaProbeService) probeInput(ctx context.Context, m *model.Media) (ProbeInput, error) {
|
||||
if m == nil {
|
||||
return ProbeInput{}, ErrMediaNotFound
|
||||
}
|
||||
if !isStrmMediaRow(m) {
|
||||
if _, err := os.Stat(m.Path); err != nil {
|
||||
return ProbeInput{}, ErrMediaNotFound
|
||||
}
|
||||
return ProbeInput{Source: m.Path}, nil
|
||||
}
|
||||
raw := strings.TrimSpace(m.STRMURL)
|
||||
if raw == "" && strings.HasSuffix(strings.ToLower(strings.TrimSpace(m.Path)), ".strm") {
|
||||
parsed, err := readLocalSTRMTarget(m.Path)
|
||||
if err == nil {
|
||||
raw = strings.TrimSpace(parsed)
|
||||
}
|
||||
}
|
||||
if raw == "" {
|
||||
return ProbeInput{}, errors.New("strm play target missing")
|
||||
}
|
||||
if s.resolve != nil {
|
||||
resolved, err := s.resolve(ctx, raw, "")
|
||||
if err != nil {
|
||||
return ProbeInput{}, err
|
||||
}
|
||||
in, err := transcodeInputFromPlayResult(resolved)
|
||||
if err != nil {
|
||||
return ProbeInput{}, err
|
||||
}
|
||||
return ProbeInput{Source: in.Source, Headers: in.Headers}, nil
|
||||
}
|
||||
if isHTTPPlaybackTarget(raw) {
|
||||
return ProbeInput{Source: raw}, nil
|
||||
}
|
||||
return ProbeInput{}, errors.New("strm probe source unavailable")
|
||||
}
|
||||
|
||||
// persistProbe 把一次成功的探测落库。
|
||||
func (s *MediaProbeService) persistProbe(ctx context.Context, m *model.Media, result *FullProbeResult) error {
|
||||
if s.repo == nil || s.repo.MediaProbe == nil {
|
||||
return errors.New("media probe repository not wired")
|
||||
}
|
||||
payload, err := result.PayloadJSON()
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
row := &model.MediaProbe{
|
||||
MediaID: m.ID,
|
||||
Signature: mediaProbeSignature(m),
|
||||
Source: mediaProbeInputKind(m),
|
||||
Container: result.Container,
|
||||
DurationSec: result.DurationSec,
|
||||
BitRate: result.BitRate,
|
||||
Width: firstStreamDimension(result, "video", true),
|
||||
Height: firstStreamDimension(result, "video", false),
|
||||
VideoCodec: firstStreamCodec(result, "video"),
|
||||
AudioCodec: firstStreamCodec(result, "audio"),
|
||||
VideoStreams: len(result.StreamsOfType("video")),
|
||||
AudioStreams: len(result.StreamsOfType("audio")),
|
||||
SubtitleStreams: len(result.StreamsOfType("subtitle")),
|
||||
ChapterCount: len(result.Chapters),
|
||||
Payload: payload,
|
||||
ProbedAt: time.Now(),
|
||||
}
|
||||
if err := s.repo.MediaProbe.Upsert(ctx, row); err != nil {
|
||||
return err
|
||||
}
|
||||
s.backfillDuration(ctx, m, result.DurationSec)
|
||||
return nil
|
||||
}
|
||||
|
||||
// backfillDuration 把探测到的时长补进 media.duration_sec。STRM / 云盘媒体在扫描
|
||||
// 阶段拿不到时长,而末段区间(end_ms = 0)要靠它才能换算出真实结束时间。
|
||||
func (s *MediaProbeService) backfillDuration(ctx context.Context, m *model.Media, durationSec int) {
|
||||
if s.repo == nil || s.repo.DB == nil || m == nil || durationSec <= 0 || m.DurationSec > 0 {
|
||||
return
|
||||
}
|
||||
err := s.repo.DB.WithContext(ctx).Model(&model.Media{}).
|
||||
Where("id = ? AND duration_sec <= 0", m.ID).
|
||||
Update("duration_sec", durationSec).Error
|
||||
if err != nil && s.log != nil {
|
||||
s.log.Debug("backfill probed duration failed", zap.String("media_id", m.ID), zap.Error(err))
|
||||
}
|
||||
}
|
||||
|
||||
func (s *MediaProbeService) markFailure(ctx context.Context, mediaID string, probeErr error) {
|
||||
if s == nil || s.repo == nil || probeErr == nil {
|
||||
return
|
||||
}
|
||||
message := truncateProbeError(probeErr)
|
||||
if err := s.repo.MediaProbe.MarkFailure(ctx, mediaID, message, time.Now()); err != nil && s.log != nil {
|
||||
s.log.Debug("record media probe failure failed", zap.String("media_id", mediaID), zap.Error(err))
|
||||
}
|
||||
if s.log != nil {
|
||||
s.log.Debug("media probe failed", zap.String("media_id", mediaID), zap.Error(probeErr))
|
||||
}
|
||||
}
|
||||
|
||||
// truncateProbeError 限制错误信息长度。错误里可能带被拒绝的直链,落库时截断,
|
||||
// 避免超长并减少敏感内容。
|
||||
func truncateProbeError(err error) string {
|
||||
message := strings.TrimSpace(err.Error())
|
||||
runes := []rune(message)
|
||||
if len(runes) > mediaProbeErrorLimit {
|
||||
return string(runes[:mediaProbeErrorLimit])
|
||||
}
|
||||
return message
|
||||
}
|
||||
|
||||
// mediaProbeInputKind 记录输入形态,供详情页判断「这个时长是本地读的还是远端读的」。
|
||||
func mediaProbeInputKind(m *model.Media) string {
|
||||
if m == nil {
|
||||
return ""
|
||||
}
|
||||
if isStrmMediaRow(m) {
|
||||
return "strm"
|
||||
}
|
||||
return "local"
|
||||
}
|
||||
|
||||
// mediaProbeSignature 是「探的是哪个文件」的指纹。
|
||||
//
|
||||
// 本地文件用路径 + 大小 + 修改时间;STRM / 云盘没有本地文件,用固化的播放目标,
|
||||
// 且绝不能用解析后的直链(每次签名都不同,缓存会永远失效)。整体做哈希:
|
||||
// 既固定长度,也不把路径或 pickcode 再抄一份进数据库。
|
||||
func mediaProbeSignature(m *model.Media) string {
|
||||
if m == nil {
|
||||
return ""
|
||||
}
|
||||
var base string
|
||||
if isStrmMediaRow(m) {
|
||||
target := strings.TrimSpace(m.STRMURL)
|
||||
if target == "" {
|
||||
target = strings.TrimSpace(m.Path)
|
||||
}
|
||||
base = "strm|" + target
|
||||
} else if info, err := os.Stat(m.Path); err == nil {
|
||||
base = fmt.Sprintf("local|%s|%d|%d", m.Path, info.Size(), info.ModTime().Unix())
|
||||
} else {
|
||||
base = "local|" + m.Path
|
||||
}
|
||||
sum := sha256.Sum256([]byte(base))
|
||||
return hex.EncodeToString(sum[:16])
|
||||
}
|
||||
|
||||
func firstStreamCodec(result *FullProbeResult, kind string) string {
|
||||
if result == nil {
|
||||
return ""
|
||||
}
|
||||
for _, stream := range result.Streams {
|
||||
if stream.Type == kind && stream.Codec != "" {
|
||||
return stream.Codec
|
||||
}
|
||||
}
|
||||
return ""
|
||||
}
|
||||
|
||||
// firstStreamDimension 取第一路指定类型轨道的宽(width=true)或高。
|
||||
func firstStreamDimension(result *FullProbeResult, kind string, width bool) int {
|
||||
if result == nil {
|
||||
return 0
|
||||
}
|
||||
for _, stream := range result.Streams {
|
||||
if stream.Type != kind {
|
||||
continue
|
||||
}
|
||||
if width {
|
||||
return stream.Width
|
||||
}
|
||||
return stream.Height
|
||||
}
|
||||
return 0
|
||||
}
|
||||
@@ -0,0 +1,308 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"os"
|
||||
"path/filepath"
|
||||
"strings"
|
||||
"sync"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// stubProber 是 mediaProber 的测试桩:可以拦住探测(gate)用来验证并发去重,
|
||||
// 也可以直接返回预置结果或错误。
|
||||
type stubProber struct {
|
||||
gate chan struct{}
|
||||
result *FullProbeResult
|
||||
err error
|
||||
|
||||
mu sync.Mutex
|
||||
calls int
|
||||
last ProbeInput
|
||||
}
|
||||
|
||||
func (s *stubProber) ProbeFull(_ context.Context, input ProbeInput) (*FullProbeResult, error) {
|
||||
s.mu.Lock()
|
||||
s.calls++
|
||||
s.last = input
|
||||
gate := s.gate
|
||||
result := s.result
|
||||
err := s.err
|
||||
s.mu.Unlock()
|
||||
if gate != nil {
|
||||
<-gate
|
||||
}
|
||||
return result, err
|
||||
}
|
||||
|
||||
func (s *stubProber) callCount() int {
|
||||
s.mu.Lock()
|
||||
defer s.mu.Unlock()
|
||||
return s.calls
|
||||
}
|
||||
|
||||
func (s *stubProber) lastInput() ProbeInput {
|
||||
s.mu.Lock()
|
||||
defer s.mu.Unlock()
|
||||
return s.last
|
||||
}
|
||||
|
||||
func chapterProbeResult() *FullProbeResult {
|
||||
return &FullProbeResult{
|
||||
Container: "matroska,webm",
|
||||
DurationSec: 1451,
|
||||
BitRate: 8_000_000,
|
||||
Streams: []ProbeStream{
|
||||
{Index: 0, Type: "video", Codec: "hevc", Width: 3840, Height: 2160},
|
||||
{Index: 1, Type: "audio", Codec: "eac3"},
|
||||
{Index: 2, Type: "subtitle", Codec: "ass"},
|
||||
},
|
||||
Chapters: []ProbeChapter{
|
||||
{Index: 0, StartMs: 0, EndMs: 95_000, Title: "Chapter 01"},
|
||||
{Index: 1, StartMs: 228_664, EndMs: 246_143, Title: "Opening"},
|
||||
{Index: 2, StartMs: 3_431_000, EndMs: 0, Title: "End Credits"},
|
||||
},
|
||||
}
|
||||
}
|
||||
|
||||
// newProbeFixture 建一条本地媒体(真实落在临时目录里,因为 probeInput 会 stat
|
||||
// 它)和一个可注入桩的 MediaProbeService。
|
||||
func newProbeFixture(t *testing.T) (*MediaProbeService, *repository.Container, *model.Media) {
|
||||
t.Helper()
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
dir := t.TempDir()
|
||||
path := filepath.Join(dir, "S01E01.mkv")
|
||||
if err := os.WriteFile(path, []byte("not-really-a-video"), 0o600); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
m := &model.Media{
|
||||
Base: model.Base{ID: "ep-1"},
|
||||
LibraryID: "lib-anime",
|
||||
SeriesID: "s-1",
|
||||
Title: "某剧",
|
||||
Path: path,
|
||||
SeasonNum: 1,
|
||||
EpisodeNum: 1,
|
||||
}
|
||||
if err := repos.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
svc := NewMediaProbeService(zap.NewNop(), repos, nil)
|
||||
return svc, repos, m
|
||||
}
|
||||
|
||||
func waitForCondition(t *testing.T, timeout time.Duration, cond func() bool) {
|
||||
t.Helper()
|
||||
deadline := time.Now().Add(timeout)
|
||||
for time.Now().Before(deadline) {
|
||||
if cond() {
|
||||
return
|
||||
}
|
||||
time.Sleep(5 * time.Millisecond)
|
||||
}
|
||||
t.Fatal("condition was not met before the deadline")
|
||||
}
|
||||
|
||||
func TestMediaProbeRunPersistsProbeRow(t *testing.T) {
|
||||
svc, repos, m := newProbeFixture(t)
|
||||
prober := &stubProber{result: chapterProbeResult()}
|
||||
svc.probe = prober
|
||||
|
||||
// 直接调 run(而不是 EnsureAsync)以获得确定性的断言:这里要验证的是落库,
|
||||
// 不是调度。
|
||||
svc.run(context.Background(), m)
|
||||
|
||||
if got := prober.lastInput().Source; got != m.Path {
|
||||
t.Fatalf("probe source = %q, want the local path %q", got, m.Path)
|
||||
}
|
||||
|
||||
probe, err := repos.MediaProbe.Get(t.Context(), m.ID)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if probe == nil {
|
||||
t.Fatal("probe row missing")
|
||||
}
|
||||
if probe.Container != "matroska,webm" || probe.DurationSec != 1451 || probe.ChapterCount != 3 {
|
||||
t.Fatalf("probe summary = %#v", probe)
|
||||
}
|
||||
if probe.VideoStreams != 1 || probe.AudioStreams != 1 || probe.SubtitleStreams != 1 {
|
||||
t.Fatalf("stream counts = %d/%d/%d", probe.VideoStreams, probe.AudioStreams, probe.SubtitleStreams)
|
||||
}
|
||||
if probe.Width != 3840 || probe.Height != 2160 || probe.VideoCodec != "hevc" || probe.AudioCodec != "eac3" {
|
||||
t.Fatalf("probe primaries = %#v", probe)
|
||||
}
|
||||
if probe.Source != "local" || probe.Signature == "" {
|
||||
t.Fatalf("probe source/signature = %q/%q", probe.Source, probe.Signature)
|
||||
}
|
||||
if probe.LastError != "" {
|
||||
t.Fatalf("last error = %q, want empty", probe.LastError)
|
||||
}
|
||||
if !strings.Contains(probe.Payload, "hevc") {
|
||||
t.Fatalf("payload should carry the parsed streams: %s", probe.Payload)
|
||||
}
|
||||
|
||||
// 时长回填:STRM / 云盘媒体扫描时拿不到时长,末段区间要靠它换算结束时间。
|
||||
var refreshed model.Media
|
||||
if err := repos.DB.First(&refreshed, "id = ?", m.ID).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if refreshed.DurationSec != 1451 {
|
||||
t.Fatalf("media duration = %d, want the probed 1451", refreshed.DurationSec)
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeFailureKeepsPreviousSummary(t *testing.T) {
|
||||
svc, repos, m := newProbeFixture(t)
|
||||
prober := &stubProber{result: chapterProbeResult()}
|
||||
svc.probe = prober
|
||||
svc.run(context.Background(), m)
|
||||
|
||||
prober.err = errors.New("ffprobe full: exit status 1")
|
||||
svc.run(context.Background(), m)
|
||||
|
||||
probe, err := repos.MediaProbe.Get(t.Context(), m.ID)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if probe == nil || probe.LastError == "" {
|
||||
t.Fatal("a failed re-probe must record the error")
|
||||
}
|
||||
// 关键:失败只更新时间与错误信息,上一次成功的媒体信息必须留着——
|
||||
// 否则一次失败的重探会把已经拿到的时长(片尾区间换算要用)抹掉。
|
||||
if probe.DurationSec != 1451 || probe.Container != "matroska,webm" || probe.Payload == "" {
|
||||
t.Fatalf("a failed re-probe wiped the previous summary: %#v", probe)
|
||||
}
|
||||
}
|
||||
|
||||
// 探测有结论后就不再重探;失败要等冷却期过去才允许重试。
|
||||
func TestMediaProbeSettledSkipsReprobeButStaleFailureRetries(t *testing.T) {
|
||||
if !mediaProbeSettled(&model.MediaProbe{ProbedAt: time.Now()}) {
|
||||
t.Fatal("a completed probe is settled")
|
||||
}
|
||||
if !mediaProbeSettled(&model.MediaProbe{ProbedAt: time.Now(), LastError: "boom"}) {
|
||||
t.Fatal("a recent failure is settled: it must not be retried on every play")
|
||||
}
|
||||
if mediaProbeSettled(&model.MediaProbe{ProbedAt: time.Now().Add(-mediaProbeFailureRetry - time.Minute), LastError: "boom"}) {
|
||||
t.Fatal("a failure past the cooldown should be retried")
|
||||
}
|
||||
if mediaProbeSettled(nil) {
|
||||
t.Fatal("a missing probe row is not settled")
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeEnsureAsyncDedupesInFlightProbes(t *testing.T) {
|
||||
svc, _, m := newProbeFixture(t)
|
||||
gate := make(chan struct{})
|
||||
prober := &stubProber{result: chapterProbeResult(), gate: gate}
|
||||
svc.probe = prober
|
||||
|
||||
if !svc.EnsureAsync(m) {
|
||||
t.Fatal("first EnsureAsync should enqueue a probe")
|
||||
}
|
||||
// 同一条媒体在跑的时候不能重复排队:否则每次播放请求都会再起一次 3 秒探测。
|
||||
if svc.EnsureAsync(m) {
|
||||
t.Fatal("second EnsureAsync must report that a probe is already running")
|
||||
}
|
||||
|
||||
close(gate)
|
||||
waitForCondition(t, 5*time.Second, func() bool {
|
||||
svc.mu.Lock()
|
||||
defer svc.mu.Unlock()
|
||||
return len(svc.inFlight) == 0
|
||||
})
|
||||
if got := prober.callCount(); got != 1 {
|
||||
t.Fatalf("probe calls = %d, want 1", got)
|
||||
}
|
||||
// 跑完之后允许再次排队(例如失败冷却期到了之后的重试)。
|
||||
if !svc.EnsureAsync(m) {
|
||||
t.Fatal("EnsureAsync should enqueue again once the previous run finished")
|
||||
}
|
||||
waitForCondition(t, 5*time.Second, func() bool { return prober.callCount() == 2 })
|
||||
}
|
||||
|
||||
func TestMediaProbeEnsureAsyncWithoutProberIsNotPending(t *testing.T) {
|
||||
svc, _, m := newProbeFixture(t)
|
||||
// probe 未注入(ffprobe 不可用时就是这样):不能谎报「提取中」,否则客户端
|
||||
// 会白轮询一轮。
|
||||
if svc.EnsureAsync(m) {
|
||||
t.Fatal("EnsureAsync must return false without a prober")
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeInputRejectsMissingLocalFile(t *testing.T) {
|
||||
svc, _, _ := newProbeFixture(t)
|
||||
_, err := svc.probeInput(t.Context(), &model.Media{
|
||||
Base: model.Base{ID: "missing"}, Path: filepath.Join(t.TempDir(), "nope.mkv"),
|
||||
})
|
||||
if !errors.Is(err, ErrMediaNotFound) {
|
||||
t.Fatalf("err = %v, want ErrMediaNotFound", err)
|
||||
}
|
||||
}
|
||||
|
||||
func TestMediaProbeInputResolvesStrmWithHeaders(t *testing.T) {
|
||||
svc := &MediaProbeService{}
|
||||
svc.SetPlayTargetResolver(func(_ context.Context, raw, userAgent string) (*StrmPlayResult, error) {
|
||||
if raw != "https://pan.example.com/api/strm/play/115?v=1" {
|
||||
t.Fatalf("resolver got raw = %q", raw)
|
||||
}
|
||||
if userAgent != "" {
|
||||
t.Fatalf("userAgent = %q, want empty for a background probe", userAgent)
|
||||
}
|
||||
return &StrmPlayResult{RedirectURL: "https://cdn.example.com/a.mkv"}, nil
|
||||
})
|
||||
input, err := svc.probeInput(t.Context(), &model.Media{
|
||||
Base: model.Base{ID: "strm-1"},
|
||||
Path: "/media/a.mkv.strm",
|
||||
STRMURL: "https://pan.example.com/api/strm/play/115?v=1",
|
||||
})
|
||||
if err != nil {
|
||||
t.Fatalf("probeInput: %v", err)
|
||||
}
|
||||
if input.Source != "https://cdn.example.com/a.mkv" {
|
||||
t.Fatalf("source = %q, want the resolved direct link", input.Source)
|
||||
}
|
||||
}
|
||||
|
||||
// 签名不能把播放目标(含 pickcode)再抄一份进数据库,所以整体做哈希。
|
||||
func TestMediaProbeSignatureHidesPlayTargetAndTracksFileChanges(t *testing.T) {
|
||||
dir := t.TempDir()
|
||||
path := filepath.Join(dir, "movie.mkv")
|
||||
if err := os.WriteFile(path, []byte("v1"), 0o600); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
local := &model.Media{Base: model.Base{ID: "l-1"}, Path: path}
|
||||
first := mediaProbeSignature(local)
|
||||
if len(first) != 32 {
|
||||
t.Fatalf("signature = %q, want a 32-char hex digest", first)
|
||||
}
|
||||
if strings.Contains(first, "movie.mkv") {
|
||||
t.Fatalf("signature leaked the path: %q", first)
|
||||
}
|
||||
if err := os.WriteFile(path, []byte("v2-changed-size"), 0o600); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if mediaProbeSignature(local) == first {
|
||||
t.Fatal("the signature must change when the file changes")
|
||||
}
|
||||
|
||||
strm := &model.Media{
|
||||
Base: model.Base{ID: "s-1"},
|
||||
Path: "/media/movie.mkv.strm",
|
||||
STRMURL: "https://pan.example.com/api/strm/play/115?pickcode=secret-pickcode",
|
||||
}
|
||||
strmSig := mediaProbeSignature(strm)
|
||||
if strings.Contains(strmSig, "secret-pickcode") || strings.Contains(strmSig, "pan.example.com") {
|
||||
t.Fatalf("strm signature leaked the play target: %q", strmSig)
|
||||
}
|
||||
if strmSig == "" {
|
||||
t.Fatal("strm signature must not be empty")
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,281 @@
|
||||
// Package service — 片头/片尾片段(intro / recap / credits / preview)。
|
||||
//
|
||||
// 播放器只认本地库里的片段数据;外部提供方(当前为 TheIntroDB)在播放时按需
|
||||
// 补齐并落库,因此同一部片第二次播放时不再产生任何外网请求。
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// 片段数据的缓存时长。命中过说明社区库里已有记录、数据很少变动,可以放很久;
|
||||
// 未命中说明这部片还没人贡献,隔一段时间再试一次即可——负缓存是必须的,否则
|
||||
// 每次播放一部没有片段数据的影片都会打一次外网。
|
||||
const (
|
||||
segmentFoundTTL = 30 * 24 * time.Hour
|
||||
segmentMissingTTL = 7 * 24 * time.Hour
|
||||
)
|
||||
|
||||
// SegmentView 是播放器消费的最小片段结构,避免把库内字段(source 等)暴露给前端。
|
||||
type SegmentView struct {
|
||||
Kind string `json:"kind"`
|
||||
StartMs int64 `json:"start_ms"`
|
||||
EndMs int64 `json:"end_ms"`
|
||||
}
|
||||
|
||||
// ToSegmentViews 转换库内行为对外视图。
|
||||
func ToSegmentViews(rows []model.MediaSegment) []SegmentView {
|
||||
out := make([]SegmentView, 0, len(rows))
|
||||
for _, row := range rows {
|
||||
out = append(out, SegmentView{Kind: row.Kind, StartMs: row.StartMs, EndMs: row.EndMs})
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
// MediaSegmentService 负责把外部片头片尾数据补齐到本地并供播放器读取。
|
||||
type MediaSegmentService struct {
|
||||
log *zap.Logger
|
||||
repo *repository.Container
|
||||
introdb *IntroDBService
|
||||
// probe 负责从文件内嵌章节里提取片头/片尾(异步、落库)。未注入时只用
|
||||
// TheIntroDB。
|
||||
probe *MediaProbeService
|
||||
}
|
||||
|
||||
// NewMediaSegmentService is the constructor.
|
||||
func NewMediaSegmentService(log *zap.Logger, repo *repository.Container) *MediaSegmentService {
|
||||
return &MediaSegmentService{log: log, repo: repo}
|
||||
}
|
||||
|
||||
// SetIntroDB wires the provider. Without it the service only reads cached rows.
|
||||
func (s *MediaSegmentService) SetIntroDB(p *IntroDBService) *MediaSegmentService {
|
||||
if s != nil {
|
||||
s.introdb = p
|
||||
}
|
||||
return s
|
||||
}
|
||||
|
||||
// SetProbe wires the in-file chapter extractor. Without it the ffprobe source
|
||||
// simply yields nothing and auto falls back to TheIntroDB.
|
||||
func (s *MediaSegmentService) SetProbe(p *MediaProbeService) *MediaSegmentService {
|
||||
if s != nil {
|
||||
s.probe = p
|
||||
}
|
||||
return s
|
||||
}
|
||||
|
||||
// ListForPlayback returns the segments known for a media item, refreshing from
|
||||
// the provider when the cache is stale.
|
||||
//
|
||||
// 它不做任何阻塞起播的事情——调用方是在播放已经开始之后用一次独立请求进来的,
|
||||
// 抓取失败也只是少一个「跳过片头」按钮,绝不能让播放报错。
|
||||
//
|
||||
// 时间轴数据只来自 TheIntroDB。顺带在返回前起一次异步探测补齐媒体信息(主要是
|
||||
// STRM 媒体的时长),但探测结果不参与片段判定,详见 MediaProbeService 的说明。
|
||||
func (s *MediaSegmentService) ListForPlayback(ctx context.Context, m *model.Media) ([]model.MediaSegment, error) {
|
||||
if s == nil || s.repo == nil || m == nil || m.ID == "" {
|
||||
return nil, nil
|
||||
}
|
||||
// 用 defer 保证探测一定在本次请求所有数据库读写之后才启动:后台探测自己也要
|
||||
// 写库,若在本次写事务还没结束时启动,两个写事务会抢同一把锁(SQLite 下就是
|
||||
// SQLITE_BUSY,实测能直接把社区库的落库打失败)。
|
||||
defer s.ensureMediaProbe(ctx, m)
|
||||
return s.introDBSegments(ctx, m)
|
||||
}
|
||||
|
||||
// ensureMediaProbe 在还没探过(或上次失败已过冷却期)时起一次异步探测。
|
||||
//
|
||||
// 它只为「补齐媒体信息」服务:失败只是拿不到时长,不影响播放,也不影响片段。
|
||||
func (s *MediaSegmentService) ensureMediaProbe(ctx context.Context, m *model.Media) {
|
||||
if s == nil || s.probe == nil || m == nil {
|
||||
return
|
||||
}
|
||||
cached, err := s.repo.MediaProbe.Get(ctx, m.ID)
|
||||
if err != nil {
|
||||
s.debug("get media probe failed", m.ID, err)
|
||||
return
|
||||
}
|
||||
if mediaProbeSettled(cached) {
|
||||
return
|
||||
}
|
||||
s.probe.EnsureAsync(m)
|
||||
}
|
||||
|
||||
// mediaProbeSettled 判断这部媒体的探测是否已经「有结论」——成功过,或者失败但还在
|
||||
// 冷却期内。有结论就不必再探;失败且已过冷却期时返回 false,让下一次播放重试。
|
||||
func mediaProbeSettled(row *model.MediaProbe) bool {
|
||||
if row == nil {
|
||||
return false
|
||||
}
|
||||
if strings.TrimSpace(row.LastError) == "" {
|
||||
return true
|
||||
}
|
||||
return time.Since(row.ProbedAt) < mediaProbeFailureRetry
|
||||
}
|
||||
|
||||
// introDBSegments 读社区库的片段,缓存过期时按调用方的预算抓一次并落库。
|
||||
func (s *MediaSegmentService) introDBSegments(ctx context.Context, m *model.Media) ([]model.MediaSegment, error) {
|
||||
cached, err := s.repo.MediaSegment.ListByMediaSource(ctx, m.ID, IntroDBSource)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
ledger, err := s.repo.MediaSegment.GetFetch(ctx, m.ID, IntroDBSource)
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
if ledger != nil && ledgerFresh(ledger) {
|
||||
return cached, nil
|
||||
}
|
||||
refreshed, attempted, err := s.refresh(ctx, m)
|
||||
if err != nil {
|
||||
// 社区库不可达或返回异常:沿用已有缓存,不影响播放。
|
||||
logIntroDBFailure(s.log, 0, err)
|
||||
return cached, nil
|
||||
}
|
||||
if !attempted {
|
||||
return cached, nil
|
||||
}
|
||||
return refreshed, nil
|
||||
}
|
||||
|
||||
func (s *MediaSegmentService) debug(message, mediaID string, err error) {
|
||||
if s == nil || s.log == nil {
|
||||
return
|
||||
}
|
||||
s.log.Debug(message, zap.String("media_id", mediaID), zap.Error(err))
|
||||
}
|
||||
|
||||
// refresh 向提供方查询并落库,返回 (rows, 是否真的发起过查询, error)。
|
||||
//
|
||||
// attempted=false 表示这部媒体缺少可查询的外部 ID(最常见的原因是还没刮削,
|
||||
// 剧集也还没关联到 Series),此时刻意不写负缓存:等元数据补齐后下次播放就能查到。
|
||||
func (s *MediaSegmentService) refresh(ctx context.Context, m *model.Media) ([]model.MediaSegment, bool, error) {
|
||||
if s.introdb == nil {
|
||||
return nil, false, nil
|
||||
}
|
||||
tmdbID, season, episode := s.queryIDs(ctx, m)
|
||||
if tmdbID <= 0 {
|
||||
return nil, false, nil
|
||||
}
|
||||
// 用脱离请求的 context:客户端可能在抓取完成前就离开了播放页,但结果仍然
|
||||
// 要落库,这样下一次播放直接命中缓存。
|
||||
//
|
||||
// 但 WithoutCancel 会丢掉 deadline,所以这里要主动把调用方原本愿意等待的
|
||||
// 剩余时间取回来:Emby 等第三方客户端会在起播前后同步请求片段,若调用方只
|
||||
// 打算等 5 秒,不能因为一次外网抓取把它拖到 10 秒。
|
||||
budget := introDBTimeout + 2*time.Second
|
||||
if deadline, ok := ctx.Deadline(); ok {
|
||||
if remaining := time.Until(deadline); remaining < budget {
|
||||
budget = remaining
|
||||
}
|
||||
}
|
||||
if budget <= 0 {
|
||||
// 调用方的预算已经用完:直接放弃本次抓取。返回 attempted=false,
|
||||
// 调用方保留自己的缓存,也不会写入负缓存(下次还有机会)。
|
||||
return nil, false, nil
|
||||
}
|
||||
fetchCtx, cancel := context.WithTimeout(context.WithoutCancel(ctx), budget)
|
||||
defer cancel()
|
||||
|
||||
spans, err := s.introdb.Fetch(fetchCtx, tmdbID, season, episode)
|
||||
if err != nil {
|
||||
return nil, true, err
|
||||
}
|
||||
rows := make([]model.MediaSegment, 0, len(spans))
|
||||
for _, span := range spans {
|
||||
rows = append(rows, model.MediaSegment{
|
||||
MediaID: m.ID,
|
||||
SeriesID: m.SeriesID,
|
||||
Kind: span.Kind,
|
||||
StartMs: span.StartMs,
|
||||
EndMs: span.EndMs,
|
||||
Source: IntroDBSource,
|
||||
})
|
||||
}
|
||||
if err := s.repo.MediaSegment.ReplaceForMedia(fetchCtx, m.ID, IntroDBSource, rows); err != nil {
|
||||
return nil, true, err
|
||||
}
|
||||
if err := s.repo.MediaSegment.UpsertFetch(fetchCtx, &model.MediaSegmentFetch{
|
||||
MediaID: m.ID,
|
||||
Source: IntroDBSource,
|
||||
FetchedAt: time.Now(),
|
||||
Found: len(rows) > 0,
|
||||
}); err != nil {
|
||||
return nil, true, err
|
||||
}
|
||||
return rows, true, nil
|
||||
}
|
||||
|
||||
// queryIDs resolves the provider query key. Movies use their own TMDb id.
|
||||
//
|
||||
// 剧集需要「剧集级」TMDb id 加季/集。优先取 Series.TMDbID;但有些刮削路径
|
||||
// 不建 Series 行,而是把剧集级 id 直接写在 Media.TMDbID 上(生产环境动漫库
|
||||
// 实测如此:同一剧名下各集共用同一个 id,52/52 个剧名都唯一)。这类行原先
|
||||
// 一律解析不出 id,等于整库查不到任何片段,所以这里补一条兜底。
|
||||
//
|
||||
// 兜底必须验证「是不是剧集级 id」:Media.TMDbID 在另一些刮削路径下存的是
|
||||
// 单集自己的 id,拿它去查会命中别的片子。判据是多集共用(见
|
||||
// MediaRepository.ExistsSiblingWithTMDbID)——单集 id 不会在兄弟集上重复。
|
||||
func (s *MediaSegmentService) queryIDs(ctx context.Context, m *model.Media) (tmdbID, season, episode int) {
|
||||
if m.SeasonNum > 0 || m.EpisodeNum > 0 {
|
||||
return s.episodeQueryIDs(ctx, m)
|
||||
}
|
||||
if m.TMDbID > 0 {
|
||||
return m.TMDbID, 0, 0
|
||||
}
|
||||
return 0, 0, 0
|
||||
}
|
||||
|
||||
func (s *MediaSegmentService) episodeQueryIDs(ctx context.Context, m *model.Media) (tmdbID, season, episode int) {
|
||||
if m.SeasonNum <= 0 || m.EpisodeNum <= 0 {
|
||||
return 0, 0, 0
|
||||
}
|
||||
if seriesTMDbID := s.seriesTMDbID(ctx, m); seriesTMDbID > 0 {
|
||||
return seriesTMDbID, m.SeasonNum, m.EpisodeNum
|
||||
}
|
||||
if !s.mediaTMDbIDLooksLikeSeries(ctx, m) {
|
||||
return 0, 0, 0
|
||||
}
|
||||
return m.TMDbID, m.SeasonNum, m.EpisodeNum
|
||||
}
|
||||
|
||||
// seriesTMDbID returns the series-level TMDb id, or 0 when the row has no
|
||||
// Series association or that Series was never matched.
|
||||
func (s *MediaSegmentService) seriesTMDbID(ctx context.Context, m *model.Media) int {
|
||||
if strings.TrimSpace(m.SeriesID) == "" {
|
||||
return 0
|
||||
}
|
||||
series, err := s.repo.Series.FindByID(ctx, m.SeriesID)
|
||||
if err != nil || series == nil || series.TMDbID <= 0 {
|
||||
return 0
|
||||
}
|
||||
return series.TMDbID
|
||||
}
|
||||
|
||||
// mediaTMDbIDLooksLikeSeries reports whether Media.TMDbID can stand in for the
|
||||
// series id: only an id shared by other episodes of the same show qualifies.
|
||||
func (s *MediaSegmentService) mediaTMDbIDLooksLikeSeries(ctx context.Context, m *model.Media) bool {
|
||||
if s == nil || s.repo == nil || m == nil || m.TMDbID <= 0 {
|
||||
return false
|
||||
}
|
||||
return s.repo.Media.ExistsSiblingWithTMDbID(ctx, m)
|
||||
}
|
||||
|
||||
// ledgerFresh reports whether a previous lookup is still within its TTL.
|
||||
func ledgerFresh(row *model.MediaSegmentFetch) bool {
|
||||
if row == nil {
|
||||
return false
|
||||
}
|
||||
ttl := segmentMissingTTL
|
||||
if row.Found {
|
||||
ttl = segmentFoundTTL
|
||||
}
|
||||
return time.Since(row.FetchedAt) < ttl
|
||||
}
|
||||
@@ -0,0 +1,77 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
)
|
||||
|
||||
// 播放请求要顺带把媒体信息(主要是 STRM 媒体的时长)补齐,但探测不能影响片段:
|
||||
// ListForPlayback 只读社区库,探测在返回前才异步排上队。
|
||||
func TestListForPlaybackTriggersMediaProbe(t *testing.T) {
|
||||
probeSvc, repos, m := newProbeFixture(t)
|
||||
prober := &stubProber{result: chapterProbeResult()}
|
||||
probeSvc.probe = prober
|
||||
|
||||
segments := NewMediaSegmentService(zap.NewNop(), repos).SetProbe(probeSvc)
|
||||
|
||||
rows, err := segments.ListForPlayback(t.Context(), m)
|
||||
if err != nil {
|
||||
t.Fatalf("ListForPlayback: %v", err)
|
||||
}
|
||||
if len(rows) != 0 {
|
||||
t.Fatalf("rows = %#v, want none without a provider", rows)
|
||||
}
|
||||
|
||||
// 探测是异步的:等它跑完并落库。
|
||||
waitForCondition(t, 5*time.Second, func() bool { return prober.callCount() >= 1 })
|
||||
probeRow, err := repos.MediaProbe.Get(t.Context(), m.ID)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if probeRow == nil {
|
||||
t.Fatal("the playback path should have probed the media info")
|
||||
}
|
||||
|
||||
// 已经有结论的媒体不该被反复探测:每次播放重跑一次 2~4.5 秒的远端读取太贵。
|
||||
if _, err := segments.ListForPlayback(t.Context(), m); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
time.Sleep(50 * time.Millisecond)
|
||||
if got := prober.callCount(); got != 1 {
|
||||
t.Fatalf("probe calls = %d, want 1 (a settled probe must not repeat)", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 探测失败也要有结论:冷却期内不再重探。
|
||||
func TestListForPlaybackDoesNotReprobeWithinFailureCooldown(t *testing.T) {
|
||||
probeSvc, repos, m := newProbeFixture(t)
|
||||
prober := &stubProber{result: chapterProbeResult()}
|
||||
probeSvc.probe = prober
|
||||
if err := repos.MediaProbe.MarkFailure(t.Context(), m.ID, "boom", time.Now()); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
segments := NewMediaSegmentService(zap.NewNop(), repos).SetProbe(probeSvc)
|
||||
if _, err := segments.ListForPlayback(t.Context(), m); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
time.Sleep(50 * time.Millisecond)
|
||||
if got := prober.callCount(); got != 0 {
|
||||
t.Fatalf("probe calls = %d, want 0 inside the cooldown", got)
|
||||
}
|
||||
}
|
||||
|
||||
// 没注入探测服务时(ffprobe 不可用的精简部署)播放链路必须照常工作。
|
||||
func TestListForPlaybackWithoutProbeStillWorks(t *testing.T) {
|
||||
_, repos, m := newProbeFixture(t)
|
||||
segments := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
rows, err := segments.ListForPlayback(t.Context(), m)
|
||||
if err != nil {
|
||||
t.Fatalf("ListForPlayback: %v", err)
|
||||
}
|
||||
if len(rows) != 0 {
|
||||
t.Fatalf("rows = %#v, want none", rows)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,401 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"sync/atomic"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
func newSegmentServiceFixture(t *testing.T, handler http.HandlerFunc) (*MediaSegmentService, *repository.Container, *int32) {
|
||||
t.Helper()
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
var calls int32
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
|
||||
atomic.AddInt32(&calls, 1)
|
||||
handler(w, r)
|
||||
}))
|
||||
t.Cleanup(server.Close)
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos).
|
||||
SetIntroDB(NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL))
|
||||
return svc, repos, &calls
|
||||
}
|
||||
|
||||
func writeJSONBody(body string) http.HandlerFunc {
|
||||
return func(w http.ResponseWriter, _ *http.Request) {
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(body))
|
||||
}
|
||||
}
|
||||
|
||||
// 剧集必须用「剧集级」TMDb id 查询,而 Media.TMDbID 存的是单集自己的 id:
|
||||
// 刮削写的是 episode 的 tmdb id(见 local_metadata_test.go 的约束)。
|
||||
func TestQueryIDsUsesSeriesTMDbForEpisodes(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
ctx := t.Context()
|
||||
|
||||
if err := repos.DB.Create(&model.Series{
|
||||
Base: model.Base{ID: "s-1"}, Title: "Breaking Bad", TMDbID: 1396,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
episode := &model.Media{
|
||||
Base: model.Base{ID: "ep-1"},
|
||||
SeriesID: "s-1",
|
||||
SeasonNum: 1,
|
||||
EpisodeNum: 2,
|
||||
TMDbID: 4375419, // 单集 id,不是剧集 id
|
||||
}
|
||||
tmdbID, season, episodeNum := svc.queryIDs(ctx, episode)
|
||||
if tmdbID != 1396 {
|
||||
t.Fatalf("tmdbID = %d, want the series id 1396 (not the episode id)", tmdbID)
|
||||
}
|
||||
if season != 1 || episodeNum != 2 {
|
||||
t.Fatalf("season/episode = %d/%d, want 1/2", season, episodeNum)
|
||||
}
|
||||
}
|
||||
|
||||
func TestQueryIDsForMovieUsesOwnTMDb(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
|
||||
tmdbID, season, episode := svc.queryIDs(t.Context(), &model.Media{
|
||||
Base: model.Base{ID: "mv-1"}, TMDbID: 27205,
|
||||
})
|
||||
if tmdbID != 27205 || season != 0 || episode != 0 {
|
||||
t.Fatalf("query = (%d,%d,%d), want (27205,0,0)", tmdbID, season, episode)
|
||||
}
|
||||
}
|
||||
|
||||
func TestQueryIDsIsNotResolvableBeforeScrape(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
ctx := t.Context()
|
||||
|
||||
// 剧集还没关联 Series:解析不出来,但也不能当成「查过且没有」。
|
||||
if tmdbID, _, _ := svc.queryIDs(ctx, &model.Media{
|
||||
Base: model.Base{ID: "ep-orphan"}, SeasonNum: 1, EpisodeNum: 1,
|
||||
}); tmdbID != 0 {
|
||||
t.Fatalf("tmdbID = %d, want 0", tmdbID)
|
||||
}
|
||||
// 没刮削过的电影同理。
|
||||
if tmdbID, _, _ := svc.queryIDs(ctx, &model.Media{Base: model.Base{ID: "mv-noscrape"}}); tmdbID != 0 {
|
||||
t.Fatalf("tmdbID = %d, want 0", tmdbID)
|
||||
}
|
||||
}
|
||||
|
||||
// 部分刮削路径(生产环境动漫库实测如此)不建 Series 行,而是把「剧集级」
|
||||
// TMDb id 直接写在 Media.TMDbID 上:同一剧名下各集共用同一个 id。
|
||||
// 原先这类行一律解析不出 id,整个动漫库等于查不到任何片段。
|
||||
func TestQueryIDsFallsBackToMediaTMDbWhenSiblingsShareIt(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
ctx := t.Context()
|
||||
|
||||
episodes := []*model.Media{
|
||||
{Base: model.Base{ID: "ep-6"}, LibraryID: "lib-anime", Title: "便·当", Path: "/anime/ben-to/S01E06.mkv", SeasonNum: 1, EpisodeNum: 6, TMDbID: 61970},
|
||||
{Base: model.Base{ID: "ep-7"}, LibraryID: "lib-anime", Title: "便·当", Path: "/anime/ben-to/S01E07.mkv", SeasonNum: 1, EpisodeNum: 7, TMDbID: 61970},
|
||||
}
|
||||
for _, ep := range episodes {
|
||||
if err := repos.DB.Create(ep).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
tmdbID, season, episode := svc.queryIDs(ctx, episodes[0])
|
||||
if tmdbID != 61970 || season != 1 || episode != 6 {
|
||||
t.Fatalf("query = (%d,%d,%d), want (61970,1,6): a shared id is a series id", tmdbID, season, episode)
|
||||
}
|
||||
}
|
||||
|
||||
// 反例(重要):另一些刮削路径把「单集自己的」id 写在 Media.TMDbID 上,
|
||||
// 每集都不同。这种 id 不能当剧集 id 用——拿它去查会命中完全不相干的片子。
|
||||
func TestQueryIDsRejectsPerEpisodeTMDbWithoutSiblings(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
ctx := t.Context()
|
||||
|
||||
episodes := []*model.Media{
|
||||
{Base: model.Base{ID: "ep-1"}, LibraryID: "lib-tv", Title: "某剧", Path: "/tv/some/S01E01.mkv", SeasonNum: 1, EpisodeNum: 1, TMDbID: 4_375_419},
|
||||
{Base: model.Base{ID: "ep-2"}, LibraryID: "lib-tv", Title: "某剧", Path: "/tv/some/S01E02.mkv", SeasonNum: 1, EpisodeNum: 2, TMDbID: 4_375_420},
|
||||
}
|
||||
for _, ep := range episodes {
|
||||
if err := repos.DB.Create(ep).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
if tmdbID, _, _ := svc.queryIDs(ctx, episodes[0]); tmdbID != 0 {
|
||||
t.Fatalf("tmdbID = %d, want 0: a per-episode id must not be used as a series id", tmdbID)
|
||||
}
|
||||
}
|
||||
|
||||
// Series 行存在时永远优先,哪怕 Media.TMDbID 看起来也像个共用 id。
|
||||
func TestQueryIDsPrefersSeriesTMDbOverSharedMediaTMDb(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
ctx := t.Context()
|
||||
|
||||
if err := repos.DB.Create(&model.Series{
|
||||
Base: model.Base{ID: "s-1"}, Title: "便·当", TMDbID: 1396,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
episodes := []*model.Media{
|
||||
{Base: model.Base{ID: "ep-a"}, SeriesID: "s-1", LibraryID: "lib-anime", Title: "便·当", Path: "/anime/ben-to/S01E06.mkv", SeasonNum: 1, EpisodeNum: 6, TMDbID: 61970},
|
||||
{Base: model.Base{ID: "ep-b"}, SeriesID: "s-1", LibraryID: "lib-anime", Title: "便·当", Path: "/anime/ben-to/S01E07.mkv", SeasonNum: 1, EpisodeNum: 7, TMDbID: 61970},
|
||||
}
|
||||
for _, ep := range episodes {
|
||||
if err := repos.DB.Create(ep).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
if tmdbID, _, _ := svc.queryIDs(ctx, episodes[0]); tmdbID != 1396 {
|
||||
t.Fatalf("tmdbID = %d, want the Series id 1396", tmdbID)
|
||||
}
|
||||
}
|
||||
|
||||
// 关联了 Series 但那条 Series 没刮到 id 时,仍然走 Media.TMDbID 兜底。
|
||||
func TestQueryIDsFallsBackWhenSeriesHasNoTMDb(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos)
|
||||
ctx := t.Context()
|
||||
|
||||
if err := repos.DB.Create(&model.Series{
|
||||
Base: model.Base{ID: "s-2"}, Title: "便·当", TMDbID: 0,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
episodes := []*model.Media{
|
||||
{Base: model.Base{ID: "ep-c"}, SeriesID: "s-2", Path: "/anime/ben-to/S01E06.mkv", SeasonNum: 1, EpisodeNum: 6, TMDbID: 61970},
|
||||
{Base: model.Base{ID: "ep-d"}, SeriesID: "s-2", Path: "/anime/ben-to/S01E07.mkv", SeasonNum: 1, EpisodeNum: 7, TMDbID: 61970},
|
||||
}
|
||||
for _, ep := range episodes {
|
||||
if err := repos.DB.Create(ep).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
if tmdbID, _, _ := svc.queryIDs(ctx, episodes[0]); tmdbID != 61970 {
|
||||
t.Fatalf("tmdbID = %d, want the shared Media id 61970", tmdbID)
|
||||
}
|
||||
}
|
||||
|
||||
func TestListForPlaybackQueriesEpisodesWithSharedSeriesTMDb(t *testing.T) {
|
||||
svc, repos, calls := newSegmentServiceFixture(t, writeJSONBody(introDBTVPayload))
|
||||
ctx := t.Context()
|
||||
episodes := []*model.Media{
|
||||
{Base: model.Base{ID: "ep-x"}, LibraryID: "lib-anime", Title: "便·当",
|
||||
Path: "/anime/ben-to/S01E06.mkv", SeasonNum: 1, EpisodeNum: 6, TMDbID: 61970},
|
||||
{Base: model.Base{ID: "ep-y"}, LibraryID: "lib-anime", Title: "便·当",
|
||||
Path: "/anime/ben-to/S01E07.mkv", SeasonNum: 1, EpisodeNum: 7, TMDbID: 61970},
|
||||
}
|
||||
for _, ep := range episodes {
|
||||
if err := repos.DB.Create(ep).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
rows, err := svc.ListForPlayback(ctx, episodes[0])
|
||||
if err != nil {
|
||||
t.Fatalf("call: %v", err)
|
||||
}
|
||||
if len(rows) != 2 {
|
||||
t.Fatalf("rows = %#v, want the two spans the provider returned", rows)
|
||||
}
|
||||
if got := atomic.LoadInt32(calls); got != 1 {
|
||||
t.Fatalf("provider calls = %d, want 1", got)
|
||||
}
|
||||
}
|
||||
|
||||
func TestListForPlaybackFetchesOnceThenServesCache(t *testing.T) {
|
||||
svc, repos, calls := newSegmentServiceFixture(t, writeJSONBody(introDBMoviePayload))
|
||||
ctx := t.Context()
|
||||
m := &model.Media{Base: model.Base{ID: "mv-1"}, Path: "/movies/inception.mkv", TMDbID: 27205}
|
||||
if err := repos.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
for i := 0; i < 3; i++ {
|
||||
rows, err := svc.ListForPlayback(ctx, m)
|
||||
if err != nil {
|
||||
t.Fatalf("call #%d: %v", i+1, err)
|
||||
}
|
||||
if len(rows) != 1 {
|
||||
t.Fatalf("call #%d rows = %#v, want 1", i+1, rows)
|
||||
}
|
||||
}
|
||||
if got := atomic.LoadInt32(calls); got != 1 {
|
||||
t.Fatalf("provider calls = %d, want 1 (later plays must hit the local cache)", got)
|
||||
}
|
||||
got, err := repos.MediaSegment.ListByMedia(ctx, "mv-1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(got) != 1 || got[0].Kind != model.SegmentKindIntro || got[0].StartMs != 0 || got[0].EndMs != 38_000 {
|
||||
t.Fatalf("persisted rows = %#v", got)
|
||||
}
|
||||
if got[0].Source != IntroDBSource {
|
||||
t.Fatalf("source = %q, want %q", got[0].Source, IntroDBSource)
|
||||
}
|
||||
}
|
||||
|
||||
func TestListForPlaybackCachesMisses(t *testing.T) {
|
||||
svc, repos, calls := newSegmentServiceFixture(t, func(w http.ResponseWriter, _ *http.Request) {
|
||||
w.WriteHeader(http.StatusNotFound)
|
||||
})
|
||||
ctx := t.Context()
|
||||
m := &model.Media{Base: model.Base{ID: "mv-2"}, Path: "/movies/nobody-knows.mkv", TMDbID: 424242}
|
||||
if err := repos.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
for i := 0; i < 2; i++ {
|
||||
rows, err := svc.ListForPlayback(ctx, m)
|
||||
if err != nil {
|
||||
t.Fatalf("call #%d: %v", i+1, err)
|
||||
}
|
||||
if len(rows) != 0 {
|
||||
t.Fatalf("call #%d rows = %#v, want none", i+1, rows)
|
||||
}
|
||||
}
|
||||
// 负缓存是必需的:否则每次播放这部片都会重新打一次外网。
|
||||
if got := atomic.LoadInt32(calls); got != 1 {
|
||||
t.Fatalf("provider calls = %d, want 1 (a miss must be cached too)", got)
|
||||
}
|
||||
ledger, err := repos.MediaSegment.GetFetch(ctx, "mv-2", IntroDBSource)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if ledger == nil || ledger.Found {
|
||||
t.Fatalf("ledger = %#v, want a recorded miss", ledger)
|
||||
}
|
||||
}
|
||||
|
||||
func TestListForPlaybackSkipsProviderWithoutExternalID(t *testing.T) {
|
||||
svc, repos, calls := newSegmentServiceFixture(t, writeJSONBody(introDBMoviePayload))
|
||||
ctx := t.Context()
|
||||
m := &model.Media{Base: model.Base{ID: "mv-3"}, Path: "/movies/unscraped.mkv"}
|
||||
if err := repos.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
if _, err := svc.ListForPlayback(ctx, m); err != nil {
|
||||
t.Fatalf("call: %v", err)
|
||||
}
|
||||
if got := atomic.LoadInt32(calls); got != 0 {
|
||||
t.Fatalf("provider calls = %d, want 0 without a tmdb id", got)
|
||||
}
|
||||
// 关键:解析不出外部 ID 时不能写负缓存,否则刮削完成后就永远不会再查了。
|
||||
ledger, err := repos.MediaSegment.GetFetch(ctx, "mv-3", IntroDBSource)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if ledger != nil {
|
||||
t.Fatalf("ledger = %#v, want none while metadata is still missing", ledger)
|
||||
}
|
||||
}
|
||||
|
||||
func TestListForPlaybackKeepsCacheWhenProviderFails(t *testing.T) {
|
||||
var calls int32
|
||||
server := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, _ *http.Request) {
|
||||
if atomic.AddInt32(&calls, 1) == 1 {
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(introDBMoviePayload))
|
||||
return
|
||||
}
|
||||
w.WriteHeader(http.StatusInternalServerError)
|
||||
}))
|
||||
defer server.Close()
|
||||
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
svc := NewMediaSegmentService(zap.NewNop(), repos).
|
||||
SetIntroDB(NewIntroDBService(zap.NewNop()).SetBaseURL(server.URL))
|
||||
ctx := t.Context()
|
||||
m := &model.Media{Base: model.Base{ID: "mv-4"}, Path: "/movies/flaky.mkv", TMDbID: 27205}
|
||||
if err := repos.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
if rows, err := svc.ListForPlayback(ctx, m); err != nil || len(rows) != 1 {
|
||||
t.Fatalf("first call rows=%#v err=%v", rows, err)
|
||||
}
|
||||
// 让缓存过期,制造一次会失败的刷新。
|
||||
if err := repos.DB.Model(&model.MediaSegmentFetch{}).
|
||||
Where("media_id = ?", "mv-4").
|
||||
Update("fetched_at", time.Now().Add(-segmentFoundTTL-time.Hour)).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
rows, err := svc.ListForPlayback(ctx, m)
|
||||
if err != nil {
|
||||
t.Fatalf("provider failure must not surface as an error: %v", err)
|
||||
}
|
||||
if len(rows) != 1 {
|
||||
t.Fatalf("rows = %#v, want the previous cache kept", rows)
|
||||
}
|
||||
}
|
||||
|
||||
func TestListForPlaybackRespectsCallerDeadline(t *testing.T) {
|
||||
// 第三方客户端(Emby)会在起播路径上同步请求片段,它给的超时必须生效,
|
||||
// 不能被一次外网抓取拖住;同时超时不能变成「负缓存」,否则就再也补不上了。
|
||||
svc, repos, calls := newSegmentServiceFixture(t, func(w http.ResponseWriter, _ *http.Request) {
|
||||
time.Sleep(400 * time.Millisecond)
|
||||
w.Header().Set("Content-Type", "application/json")
|
||||
_, _ = w.Write([]byte(introDBMoviePayload))
|
||||
})
|
||||
ctx := t.Context()
|
||||
m := &model.Media{Base: model.Base{ID: "mv-5"}, Path: "/movies/budget.mkv", TMDbID: 27205}
|
||||
if err := repos.DB.Create(m).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
budgeted, cancel := context.WithTimeout(ctx, 50*time.Millisecond)
|
||||
defer cancel()
|
||||
rows, err := svc.ListForPlayback(budgeted, m)
|
||||
if err != nil {
|
||||
t.Fatalf("an exhausted fetch budget must not surface as an error: %v", err)
|
||||
}
|
||||
if len(rows) != 0 {
|
||||
t.Fatalf("rows = %#v, want none when the caller's budget ran out", rows)
|
||||
}
|
||||
if got := atomic.LoadInt32(calls); got != 1 {
|
||||
t.Fatalf("provider calls = %d, want 1 (the attempt was made then abandoned)", got)
|
||||
}
|
||||
ledger, err := repos.MediaSegment.GetFetch(ctx, "mv-5", IntroDBSource)
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if ledger != nil {
|
||||
t.Fatal("a timed-out fetch must not be recorded as a negative cache entry")
|
||||
}
|
||||
|
||||
// 预算正常时(下一次播放)仍然能补上。
|
||||
rows, err = svc.ListForPlayback(ctx, m)
|
||||
if err != nil || len(rows) != 1 {
|
||||
t.Fatalf("second call rows=%#v err=%v, want the fetched segment", rows, err)
|
||||
}
|
||||
}
|
||||
|
||||
func TestLedgerFreshUsesLongerTTLWhenDataWasFound(t *testing.T) {
|
||||
now := time.Now()
|
||||
found := &model.MediaSegmentFetch{FetchedAt: now.Add(-segmentMissingTTL), Found: true}
|
||||
if !ledgerFresh(found) {
|
||||
t.Fatal("a hit should still be fresh just past the miss TTL")
|
||||
}
|
||||
miss := &model.MediaSegmentFetch{FetchedAt: now.Add(-segmentMissingTTL), Found: false}
|
||||
if ledgerFresh(miss) {
|
||||
t.Fatal("a miss should expire after the miss TTL")
|
||||
}
|
||||
if ledgerFresh(nil) {
|
||||
t.Fatal("a missing ledger must not be considered fresh")
|
||||
}
|
||||
}
|
||||
@@ -147,6 +147,98 @@ func (s *MediaService) ListLibrarySeriesCards(ctx context.Context, libraryID str
|
||||
return cards, total, nil
|
||||
}
|
||||
|
||||
// ListLibrarySeriesCardsFiltered 在系列卡片上应用筛选。
|
||||
//
|
||||
// 语义:先对原始剧集行做筛选,再分组 —— 于是「剧里任意一集命中条件」即可保留
|
||||
// 该剧。这比只筛代表行更符合直觉(用户勾选「动作」是想要动作剧,而不是
|
||||
// 「第一集恰好是动作的剧」)。
|
||||
//
|
||||
// 无筛选时直接走带缓存的原路径,避免平白多一次全库分组。
|
||||
func (s *MediaService) ListLibrarySeriesCardsFiltered(
|
||||
ctx context.Context,
|
||||
libraryID string,
|
||||
visibility MediaVisibility,
|
||||
filters MediaListFilters,
|
||||
) ([]SeriesCard, int64, error) {
|
||||
if filters.empty() {
|
||||
return s.ListLibrarySeriesCards(ctx, libraryID, visibility)
|
||||
}
|
||||
rows, err := s.libraryRowsWithIndex(ctx, libraryID, visibility)
|
||||
if err != nil {
|
||||
return nil, 0, err
|
||||
}
|
||||
completed := s.completedMediaIDSet(ctx, filters)
|
||||
kept := make([]model.Media, 0, len(rows.Rows))
|
||||
for _, row := range rows.Rows {
|
||||
if !mediaRowMatchesFilters(&row, filters, completed) {
|
||||
continue
|
||||
}
|
||||
kept = append(kept, row)
|
||||
}
|
||||
cards := groupMediaSeriesCards(kept)
|
||||
if cards == nil {
|
||||
cards = []SeriesCard{}
|
||||
}
|
||||
return cards, int64(len(cards)), nil
|
||||
}
|
||||
|
||||
// mediaRowMatchesFilters 在内存里复现 SQL 层的筛选语义。
|
||||
//
|
||||
// 系列路径无法直接复用仓储过滤(它基于整库共享缓存),因此这里必须与
|
||||
// applyMediaQueryFilter 保持同一套判定,否则会出现「电影库能筛、剧集库不同」
|
||||
// 的行为差异。
|
||||
func mediaRowMatchesFilters(row *model.Media, filters MediaListFilters, completed map[string]bool) bool {
|
||||
if row == nil {
|
||||
return false
|
||||
}
|
||||
if filters.YearMin > 0 && row.Year < filters.YearMin {
|
||||
return false
|
||||
}
|
||||
if filters.YearMax > 0 && row.Year > filters.YearMax {
|
||||
return false
|
||||
}
|
||||
if filters.RatingMin > 0 && float64(row.Rating) < filters.RatingMin {
|
||||
return false
|
||||
}
|
||||
if filters.Unwatched && completed[row.ID] {
|
||||
return false
|
||||
}
|
||||
if len(filters.Genres) > 0 {
|
||||
rowGenres := genreSet(row.Genres)
|
||||
matched := false
|
||||
for _, want := range filters.Genres {
|
||||
if _, ok := rowGenres[strings.ToLower(strings.TrimSpace(want))]; ok {
|
||||
matched = true
|
||||
break
|
||||
}
|
||||
}
|
||||
if !matched {
|
||||
return false
|
||||
}
|
||||
}
|
||||
return true
|
||||
}
|
||||
|
||||
// completedMediaIDSet 返回该用户已标记看完的媒体 ID 集合(未启用未观看筛选时
|
||||
// 返回 nil,避免无谓查询)。
|
||||
func (s *MediaService) completedMediaIDSet(ctx context.Context, filters MediaListFilters) map[string]bool {
|
||||
userID := strings.TrimSpace(filters.UserID)
|
||||
if !filters.Unwatched || userID == "" {
|
||||
return nil
|
||||
}
|
||||
var rows []model.PlaybackHistory
|
||||
if err := s.repo.DB.WithContext(ctx).
|
||||
Where("user_id = ? AND completed = ?", userID, true).
|
||||
Find(&rows).Error; err != nil {
|
||||
return nil
|
||||
}
|
||||
out := make(map[string]bool, len(rows))
|
||||
for _, row := range rows {
|
||||
out[row.MediaID] = true
|
||||
}
|
||||
return out
|
||||
}
|
||||
|
||||
func (s *MediaService) ListRecentSeriesCards(ctx context.Context, limit int, visibility MediaVisibility) ([]SeriesCard, error) {
|
||||
if limit <= 0 {
|
||||
limit = 24
|
||||
|
||||
@@ -36,6 +36,7 @@ type SchedulerService struct {
|
||||
organizePipeline *OrganizePipelineService
|
||||
hub *Hub
|
||||
tasks *TaskTrackerService
|
||||
expiryWatcher *TelegramExpiryWatcher
|
||||
cacheDir string
|
||||
now func() time.Time
|
||||
|
||||
@@ -59,6 +60,11 @@ func (s *SchedulerService) SetOrganizePipeline(pipeline *OrganizePipelineService
|
||||
s.organizePipeline = pipeline
|
||||
}
|
||||
|
||||
// SetExpiryWatcher 注入账号到期巡检。未注入时(例如测试)该任务不注册。
|
||||
func (s *SchedulerService) SetExpiryWatcher(watcher *TelegramExpiryWatcher) {
|
||||
s.expiryWatcher = watcher
|
||||
}
|
||||
|
||||
// ImageCachePolicy 是一次图片缓存清理要用的策略(全部为 0 表示不做任何清理)。
|
||||
type ImageCachePolicy struct {
|
||||
TotalBytes int64
|
||||
@@ -139,6 +145,14 @@ func (s *SchedulerService) Start(ctx context.Context) {
|
||||
run: s.jobCleanImageCache,
|
||||
},
|
||||
}
|
||||
// 到期提醒只在配置了巡检器时注册,避免测试与未启用通知的部署跑空转任务。
|
||||
if s.expiryWatcher != nil {
|
||||
s.jobs = append(s.jobs, &scheduledJob{
|
||||
name: "telegram_expiry_warning",
|
||||
interval: 24 * time.Hour,
|
||||
run: s.jobTelegramExpiryWarning,
|
||||
})
|
||||
}
|
||||
for _, j := range s.jobs {
|
||||
initialDelay := 15 * time.Second
|
||||
if j.name == "library_scan" || j.name == "organize_source" {
|
||||
|
||||
@@ -169,6 +169,14 @@ func (s *SchedulerService) organizeSourceInterval(ctx context.Context) time.Dura
|
||||
return time.Duration(seconds) * time.Second
|
||||
}
|
||||
|
||||
// jobTelegramExpiryWarning 每日巡检即将到期的账号并提醒用户。
|
||||
func (s *SchedulerService) jobTelegramExpiryWarning(ctx context.Context) error {
|
||||
if s.expiryWatcher == nil {
|
||||
return nil
|
||||
}
|
||||
return s.expiryWatcher.RunOnce(ctx)
|
||||
}
|
||||
|
||||
// jobCleanTranscodeCache deletes HLS artefacts older than 24h.
|
||||
func (s *SchedulerService) jobCleanTranscodeCache(ctx context.Context) error {
|
||||
if s.cacheDir == "" {
|
||||
|
||||
@@ -35,6 +35,8 @@ type Container struct {
|
||||
Fanart *FanartProvider
|
||||
Scraper *ScraperService
|
||||
Playback *PlaybackService
|
||||
Segments *MediaSegmentService
|
||||
MediaProbe *MediaProbeService
|
||||
ImageProxy *ImageProxy
|
||||
Watcher *WatcherService
|
||||
Subtitle *SubtitleService
|
||||
@@ -59,6 +61,9 @@ type Container struct {
|
||||
Token *TokenService
|
||||
ApiConfig *ApiConfigService
|
||||
Device *DeviceService
|
||||
Telegram *TelegramService
|
||||
TelegramExpiry *TelegramExpiryWatcher
|
||||
Discovery *MediaDiscoveryService
|
||||
Cache *RuntimeCacheService
|
||||
Sessions *SessionTrackerService
|
||||
RecognitionWords *RecognitionWordsService
|
||||
@@ -103,6 +108,11 @@ func (c *Container) Boot() {
|
||||
// 启动调度器定时任务
|
||||
c.Scheduler.Start(c.stopCtx)
|
||||
|
||||
// Telegram 通知轮询(未启用或未配置 Token 时直接返回)
|
||||
if c.Telegram != nil {
|
||||
c.Telegram.Start(c.stopCtx)
|
||||
}
|
||||
|
||||
// 远程 Emby 挂载兼容迁移:清理已删账号的残留挂载;旧账号无挂载时自动全量挂载
|
||||
if c.EmbyRemote != nil {
|
||||
c.EmbyRemote.CleanupOrphanMounts(c.stopCtx)
|
||||
|
||||
@@ -42,11 +42,22 @@ func newServiceContainer(cfg *config.Config, log *zap.Logger, repos *repository.
|
||||
builder.initContentServices()
|
||||
builder.initAccessAndStorageServices()
|
||||
builder.initIdentityServices()
|
||||
// Telegram 在 initIdentityServices 里构建,这里把失败告警接到任务状态机上。
|
||||
builder.wireTaskNotifications()
|
||||
builder.initImageProxy()
|
||||
builder.attachRuntimeContext()
|
||||
return builder.c
|
||||
}
|
||||
|
||||
// wireTaskNotifications 把任务失败通知接到 Telegram。必须在 Tasks 与 Telegram
|
||||
// 都已构建之后调用:早于两者其一会静默漏接。
|
||||
func (b *serviceContainerBuilder) wireTaskNotifications() {
|
||||
if b.c.Tasks == nil || b.c.Telegram == nil {
|
||||
return
|
||||
}
|
||||
b.c.Tasks.SetFailureNotifier(b.c.Telegram.SendToAdmin)
|
||||
}
|
||||
|
||||
func (b *serviceContainerBuilder) startRealtimeServices() {
|
||||
b.c.WSHub = NewHub(b.log)
|
||||
helper.Go(b.log, "ws.hub", b.c.WSHub.Run)
|
||||
@@ -110,12 +121,17 @@ func (b *serviceContainerBuilder) initContentServices() {
|
||||
b.c.DLNA = NewDLNAService(b.log)
|
||||
b.c.Storage = NewStorageService(b.log, b.repos)
|
||||
b.c.Emby = NewEmbyService(b.cfg, b.log, b.repos).SetTMDbProvider(b.c.TMDb).SetAdultProvider(b.c.Scraper.adult)
|
||||
// 发现类查询(NextUp / Similar / Genres):Emby 兼容层与媒体库筛选共用。
|
||||
b.c.Discovery = NewMediaDiscoveryService(b.log, b.repos)
|
||||
b.c.Emby.SetDiscovery(b.c.Discovery)
|
||||
b.c.EmbyRemote = NewEmbyRemoteService(b.cfg, b.log, b.repos, b.c.Crypto).SetRuntimeCache(b.c.Cache)
|
||||
b.c.Emby.SetEmbyRemote(b.c.EmbyRemote)
|
||||
b.c.Backup = NewBackupService(b.cfg, b.log, b.repos.DB)
|
||||
b.c.Media = NewMediaService(b.cfg, b.log, b.repos).SetRuntimeCache(b.c.Cache)
|
||||
b.c.Stream = NewStreamService(b.cfg, b.log, b.repos, b.c.Transcoder)
|
||||
b.c.Playback = NewPlaybackService(b.log, b.repos).SetEmbyRemote(b.c.EmbyRemote)
|
||||
// 片头/片尾片段:播放时按需向 TheIntroDB 补齐并落库,供下次直接命中。
|
||||
b.c.Segments = NewMediaSegmentService(b.log, b.repos).SetIntroDB(NewIntroDBService(b.log))
|
||||
b.c.Subtitle = NewSubtitleService(b.cfg, b.log, b.repos)
|
||||
b.c.Profile = NewProfileService(b.log, b.repos)
|
||||
b.c.Audit = NewAuditService(b.log, b.repos)
|
||||
@@ -131,6 +147,14 @@ func (b *serviceContainerBuilder) initContentServices() {
|
||||
b.c.Transcoder.SetStrmPlayTargetResolver(b.c.Strm.ResolvePlayTarget)
|
||||
b.c.Transcoder.SetProbe(b.c.FFprobe)
|
||||
b.c.Subtitle.SetStrmPlayTargetResolver(b.c.Strm.ResolvePlayTarget)
|
||||
// 播放时的媒体信息提取(ffprobe 章节 → 跳过片头/片尾):完全异步,播放链路
|
||||
// 只读缓存。换链复用与转码/字幕同一条路径,避免 CDN 防盗链 403。
|
||||
b.c.MediaProbe = NewMediaProbeService(b.log, b.repos, b.c.FFprobe).
|
||||
SetPlayTargetResolver(b.c.Strm.ResolvePlayTargetWithUA)
|
||||
b.c.Segments.SetProbe(b.c.MediaProbe)
|
||||
// 播放链路:/Videos/{id}/stream 与 /api/stream/{id} 在服务端完成换链后直接
|
||||
// 302 到最终直链,客户端少跟随一次 302(高延迟线路上省一个往返)。
|
||||
b.c.Stream.SetStrmPlayTargetResolver(b.c.Strm.ResolvePlayTargetWithUA)
|
||||
// 弹幕识别需要把远程 Emby 条目解析为 Media 元数据及可拉取前 16MB 的直链 URL。
|
||||
if b.c.EmbyRemote != nil {
|
||||
b.c.Danmaku.SetRemoteMediaResolver(func(ctx context.Context, encodedID string) (*model.Media, string, error) {
|
||||
@@ -161,6 +185,7 @@ func (b *serviceContainerBuilder) initAccessAndStorageServices() {
|
||||
b.c.Database = NewDatabaseAdminService(b.cfg, b.log, b.repos, b.repos.DB)
|
||||
b.c.Emby.SetRuntimeCache(b.c.Cache)
|
||||
b.c.Emby.SetSubtitleService(b.c.Subtitle)
|
||||
b.c.Emby.SetDiscovery(b.c.Discovery)
|
||||
b.c.Scheduler = NewSchedulerService(
|
||||
b.log, b.repos, b.c.Scan, b.c.Transcoder,
|
||||
b.c.Organizer, b.c.WSHub, b.cfg.Cache.CacheDir,
|
||||
@@ -190,6 +215,15 @@ func (b *serviceContainerBuilder) initIdentityServices() {
|
||||
b.c.Sessions = NewSessionTrackerService(b.log)
|
||||
b.c.Device = NewDeviceService(b.log, b.repos)
|
||||
b.c.Device.SetSessionTracker(b.c.Sessions)
|
||||
// Telegram 通知:未启用时 Start 不会占用 goroutine,SendToUser 静默跳过。
|
||||
b.c.Telegram = NewTelegramService(b.log, b.repos)
|
||||
b.c.Device.SetNotifier(b.c.Telegram.SendToUser)
|
||||
b.c.Device.SetAdminNotifier(b.c.Telegram.SendToAdmin)
|
||||
// 账号到期巡检:只负责发现与去重,发送复用同一个 Telegram 通道。
|
||||
b.c.TelegramExpiry = NewTelegramExpiryWatcher(b.log, b.repos)
|
||||
b.c.TelegramExpiry.SetUserNotifier(b.c.Telegram.SendToUser)
|
||||
// SetExpiryWatcher must run AFTER TelegramExpiry is constructed.
|
||||
b.c.Scheduler.SetExpiryWatcher(b.c.TelegramExpiry)
|
||||
b.c.ApiConfig = NewApiConfigService(b.cfg, b.log, b.repos, b.c.Crypto)
|
||||
}
|
||||
|
||||
|
||||
@@ -0,0 +1,200 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"net/http"
|
||||
"net/http/httptest"
|
||||
"net/url"
|
||||
"strings"
|
||||
"testing"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/config"
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
"github.com/truewhile/MeBox/internal/service/cloud"
|
||||
)
|
||||
|
||||
// directRedirectTestRepo 建一个带网盘账号表的库:normalizeCloudPlayTarget 需要
|
||||
// StrmAccount 才能判断 strm 目标是不是本机账号生成的。
|
||||
func directRedirectTestRepo(t *testing.T) *repository.Container {
|
||||
t.Helper()
|
||||
return repository.New(newServiceTestDB(t, &model.Media{}, &model.Setting{}, &model.StrmAccount{}))
|
||||
}
|
||||
|
||||
func seedCloudSTRMMedia(t *testing.T, repos *repository.Container, id, strmURL string) {
|
||||
t.Helper()
|
||||
if err := repos.DB.Create(&model.Media{
|
||||
Base: model.Base{ID: id},
|
||||
Title: "Cloud",
|
||||
Path: "cloud://cloud115/Movie.mkv",
|
||||
Container: "strm",
|
||||
STRMURL: strmURL,
|
||||
}).Error; err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
// 服务端能换到最终直链时必须直接 302 过去:客户端原本要跟着
|
||||
// /Videos/{id}/stream → /api/strm/play 两次 302,现在缩成一跳。
|
||||
func TestServeFileRedirectsStraightToResolvedDirectURL(t *testing.T) {
|
||||
repos := directRedirectTestRepo(t)
|
||||
seedCloudSTRMMedia(t, repos, "cloud-direct", "/api/strm/play/cloud115/video.mkv?acct=a1&pickcode=pc1")
|
||||
direct := "https://cdnfhnfile.115cdn.net/637b/Movie.mkv?t=1&k=sig"
|
||||
|
||||
var gotRaw, gotUA string
|
||||
svc := NewStreamService(&config.Config{}, zap.NewNop(), repos, nil).
|
||||
SetStrmPlayTargetResolver(func(_ context.Context, raw, userAgent string) (*StrmPlayResult, error) {
|
||||
gotRaw, gotUA = raw, userAgent
|
||||
// 生产环境 115 直链就是这样返回的:绑定 UA、Proxy=false。
|
||||
return &StrmPlayResult{
|
||||
RedirectURL: direct,
|
||||
Link: &cloud.DirectLink{URL: direct, Headers: map[string]string{"User-Agent": userAgent}},
|
||||
}, nil
|
||||
})
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "http://nas.local:18080/api/stream/cloud-direct?token=jwt123", nil)
|
||||
req.Header.Set("User-Agent", "RodelPlayer/2.2607.7.0")
|
||||
w := httptest.NewRecorder()
|
||||
|
||||
if err := svc.ServeFile(w, req, "cloud-direct"); err != nil {
|
||||
t.Fatalf("ServeFile: %v", err)
|
||||
}
|
||||
if w.Code != http.StatusFound {
|
||||
t.Fatalf("status = %d, want 302", w.Code)
|
||||
}
|
||||
loc := w.Header().Get("Location")
|
||||
if loc != direct {
|
||||
t.Fatalf("Location = %q, want the resolved direct link %q", loc, direct)
|
||||
}
|
||||
if strings.Contains(loc, "jwt123") || strings.Contains(loc, "media_id=") {
|
||||
t.Fatalf("internal auth query must not leak to the CDN link: %q", loc)
|
||||
}
|
||||
if got := w.Header().Get("Cache-Control"); !strings.Contains(got, "no-store") {
|
||||
t.Fatalf("direct redirect must stay uncacheable, got %q", got)
|
||||
}
|
||||
// 换链必须带播放器 UA(115 直链绑定换取时的 UA,且按 UA 分键缓存)。
|
||||
if gotUA != "RodelPlayer/2.2607.7.0" {
|
||||
t.Fatalf("resolver UA = %q, want the player UA", gotUA)
|
||||
}
|
||||
if !strings.Contains(gotRaw, "pickcode=pc1") {
|
||||
t.Fatalf("resolver raw = %q, want the strm target", gotRaw)
|
||||
}
|
||||
}
|
||||
|
||||
// 只要拿不到「客户端自己能直接拉取的直链」,就必须回退到改动前的 strm 端点跳转,
|
||||
// 保证行为不会比改动前更差。
|
||||
func TestServeFileFallsBackWhenDirectResolveUnavailable(t *testing.T) {
|
||||
strmURL := "/api/strm/play/cloud115/video.mkv?acct=a1&pickcode=pc1"
|
||||
cases := []struct {
|
||||
name string
|
||||
result *StrmPlayResult
|
||||
wantErr error
|
||||
}{
|
||||
{name: "换链失败", wantErr: errors.New("115 换链失败")},
|
||||
{
|
||||
name: "需要服务端反向代理",
|
||||
result: &StrmPlayResult{
|
||||
Proxy: true,
|
||||
Link: &cloud.DirectLink{URL: "https://cdn.example/x", Headers: map[string]string{"Authorization": "Basic x"}},
|
||||
},
|
||||
},
|
||||
{name: "没有直链(别的 MeBox 实例)", result: &StrmPlayResult{RedirectURL: "https://other.example/api/strm/play/cloud115/video.mkv?acct=o&pickcode=p"}},
|
||||
{name: "解析到本地文件", result: &StrmPlayResult{LocalPath: "/media/Movie.mkv"}},
|
||||
{name: "返回 nil", result: nil},
|
||||
{
|
||||
name: "链接要求额外请求头",
|
||||
result: &StrmPlayResult{
|
||||
RedirectURL: "https://cdn.example/x",
|
||||
Link: &cloud.DirectLink{
|
||||
URL: "https://cdn.example/x",
|
||||
Headers: map[string]string{"User-Agent": "ua", "Authorization": "Bearer t"},
|
||||
},
|
||||
},
|
||||
},
|
||||
}
|
||||
|
||||
for _, tc := range cases {
|
||||
t.Run(tc.name, func(t *testing.T) {
|
||||
repos := directRedirectTestRepo(t)
|
||||
seedCloudSTRMMedia(t, repos, "cloud-fallback", strmURL)
|
||||
svc := NewStreamService(&config.Config{}, zap.NewNop(), repos, nil).
|
||||
SetStrmPlayTargetResolver(func(context.Context, string, string) (*StrmPlayResult, error) {
|
||||
return tc.result, tc.wantErr
|
||||
})
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "http://nas.local:18080/api/stream/cloud-fallback?token=jwt123", nil)
|
||||
w := httptest.NewRecorder()
|
||||
|
||||
if err := svc.ServeFile(w, req, "cloud-fallback"); err != nil {
|
||||
t.Fatalf("ServeFile: %v", err)
|
||||
}
|
||||
if w.Code != http.StatusFound {
|
||||
t.Fatalf("status = %d, want 302", w.Code)
|
||||
}
|
||||
loc := w.Header().Get("Location")
|
||||
if !strings.Contains(loc, "/api/strm/play/cloud115/video.mkv") {
|
||||
t.Fatalf("Location = %q, want the strm endpoint fallback", loc)
|
||||
}
|
||||
if strings.Contains(loc, "cdn.example") || strings.Contains(loc, "other.example") {
|
||||
t.Fatalf("Location = %q, must not point at an unusable direct link", loc)
|
||||
}
|
||||
})
|
||||
}
|
||||
}
|
||||
|
||||
// 没有注入解析器(测试/精简部署)时保持原有跳转,不受本次优化影响。
|
||||
func TestServeFileKeepsSTRMEndpointWithoutResolver(t *testing.T) {
|
||||
repos := directRedirectTestRepo(t)
|
||||
seedCloudSTRMMedia(t, repos, "cloud-plain", "/api/strm/play/cloud115/video.mkv?acct=a1&pickcode=pc1")
|
||||
svc := NewStreamService(&config.Config{}, zap.NewNop(), repos, nil)
|
||||
|
||||
req := httptest.NewRequest(http.MethodGet, "http://nas.local:18080/api/stream/cloud-plain?token=jwt123", nil)
|
||||
w := httptest.NewRecorder()
|
||||
if err := svc.ServeFile(w, req, "cloud-plain"); err != nil {
|
||||
t.Fatalf("ServeFile: %v", err)
|
||||
}
|
||||
if loc := w.Header().Get("Location"); !strings.Contains(loc, "/api/strm/play/cloud115/video.mkv") {
|
||||
t.Fatalf("Location = %q, want the strm endpoint", loc)
|
||||
}
|
||||
}
|
||||
|
||||
// playbackQueryWithUA 负责把播放器 UA 透传给换链方,同时不能改动原 URL。
|
||||
func TestPlaybackQueryWithUAInjectsUserAgent(t *testing.T) {
|
||||
u, err := url.Parse("/api/strm/play/cloud115/video.mkv?acct=a1&pickcode=pc1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
q := playbackQueryWithUA(u, " RodelPlayer/2.2607.7.0 ")
|
||||
if got := q.Get("__ua"); got != "RodelPlayer/2.2607.7.0" {
|
||||
t.Fatalf("__ua = %q, want the trimmed player UA", got)
|
||||
}
|
||||
if q.Get("pickcode") != "pc1" || q.Get("acct") != "a1" {
|
||||
t.Fatalf("original query lost: %v", q)
|
||||
}
|
||||
if strings.Contains(u.RawQuery, "__ua") {
|
||||
t.Fatalf("source URL must not be mutated: %q", u.RawQuery)
|
||||
}
|
||||
if got := playbackQueryWithUA(u, " ").Get("__ua"); got != "" {
|
||||
t.Fatalf("blank UA must not be injected, got %q", got)
|
||||
}
|
||||
if got := playbackQueryWithUA(nil, "ua").Get("__ua"); got != "ua" {
|
||||
t.Fatalf("nil URL must still accept the UA, got %q", got)
|
||||
}
|
||||
}
|
||||
|
||||
// ResolvePlayTargetWithUA 是 ResolvePlayTarget 的 UA 版本:空 UA 时行为必须与
|
||||
// 原方法完全一致(外部直链透传)。
|
||||
func TestResolvePlayTargetWithUAKeepsPassthroughBehaviour(t *testing.T) {
|
||||
svc := &StrmService{}
|
||||
raw := "https://cdn.example.test/Movie.mkv?sign=1"
|
||||
got, err := svc.ResolvePlayTargetWithUA(context.Background(), raw, "RodelPlayer/1.0")
|
||||
if err != nil {
|
||||
t.Fatalf("ResolvePlayTargetWithUA: %v", err)
|
||||
}
|
||||
if got == nil || got.RedirectURL != raw {
|
||||
t.Fatalf("result = %+v, want passthrough of %q", got, raw)
|
||||
}
|
||||
}
|
||||
@@ -6,6 +6,7 @@ import (
|
||||
"net/url"
|
||||
"os"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
@@ -33,6 +34,14 @@ func (s *StreamService) ServeFileWithCloudMode(w http.ResponseWriter, r *http.Re
|
||||
if !cloudPlaybackModeEnabled(r.Context(), s.repo, cloudMode) {
|
||||
return ErrCloudPlaybackDisabled
|
||||
}
|
||||
// 能在服务端换到最终直链就直接 302 过去:客户端少跟随一次 302,等于
|
||||
// 省掉一次「DNS+TCP+TLS+请求」的往返。解析结果同时写进 strm 层直链
|
||||
// 缓存,后续 /api/strm/play 请求直接命中。
|
||||
if direct, ok := s.resolveDirectPlayTargetURL(r, strmURL); ok {
|
||||
setCloudRedirectNoStore(w)
|
||||
http.Redirect(w, r, direct, http.StatusFound)
|
||||
return nil
|
||||
}
|
||||
// 云盘播放 URL 先规范化为相对路径,免疫扫描时固化的旧 host;
|
||||
// 指向别的 MeBox 实例的地址保持原样,按第三方直链透传。
|
||||
target := normalizeCloudPlayTarget(r.Context(), s.repo, s.cfg, r, strmURL)
|
||||
@@ -72,6 +81,43 @@ func setCloudRedirectNoStore(w http.ResponseWriter) {
|
||||
w.Header().Set("Expires", "0")
|
||||
}
|
||||
|
||||
// directPlayResolveTimeout 是服务端换链的等待上限。115 开放平台在跨太平洋线路
|
||||
// 上单次换链实测 0.4–1.1s,这里给足余量;一旦超时就回退到原来的 strm 端点跳转,
|
||||
// 由 /api/strm/play 再去换链,最坏情况只是回到改动前的行为。
|
||||
const directPlayResolveTimeout = 10 * time.Second
|
||||
|
||||
// resolveDirectPlayTargetURL 尝试在服务端把 strm 目标解析成客户端可直接拉取的
|
||||
// 最终直链,供调用方直接 302。
|
||||
//
|
||||
// 只在「明确的直链」上短路:需要服务端反向代理(云盘 WebDAV 等必须附加请求头)、
|
||||
// 解析到本地文件、以及解析失败都会返回 false,由调用方按改动前的方式回退到
|
||||
// strm 端点跳转,行为不会变差。
|
||||
func (s *StreamService) resolveDirectPlayTargetURL(r *http.Request, raw string) (string, bool) {
|
||||
if s == nil || s.strmResolve == nil || r == nil {
|
||||
return "", false
|
||||
}
|
||||
ctx, cancel := context.WithTimeout(r.Context(), directPlayResolveTimeout)
|
||||
defer cancel()
|
||||
// 必须带播放器 UA:115 直链绑定换取时的 UA,且按 UA 分键缓存,换错会拿到
|
||||
// 与播放器不匹配(或未命中缓存)的地址。
|
||||
result, err := s.strmResolve(ctx, raw, r.Header.Get("User-Agent"))
|
||||
if err != nil || result == nil || result.Proxy || result.Link == nil {
|
||||
return "", false
|
||||
}
|
||||
// 客户端只能自带 User-Agent 这类基础请求头。链接一旦要求其它头(Referer /
|
||||
// Authorization),就必须继续由服务端反向代理,不能在这里短路。
|
||||
for name := range result.Link.Headers {
|
||||
if !strings.EqualFold(strings.TrimSpace(name), "User-Agent") {
|
||||
return "", false
|
||||
}
|
||||
}
|
||||
direct := strings.TrimSpace(result.RedirectURL)
|
||||
if direct == "" {
|
||||
return "", false
|
||||
}
|
||||
return direct, true
|
||||
}
|
||||
|
||||
func isCloudPlaybackTarget(raw string) bool {
|
||||
_, _, ok := parseCloudMediaPlaybackURL(raw)
|
||||
return ok
|
||||
|
||||
@@ -33,6 +33,10 @@ type StreamService struct {
|
||||
log *zap.Logger
|
||||
repo *repository.Container
|
||||
transcoder *TranscoderService
|
||||
// strmResolve 把 strm 目标解析成最终直链。注入后 /Videos/{id}/stream 能直接
|
||||
// 302 到 CDN 地址,省掉 /api/strm/play 那一跳;未注入时保持原有的两跳行为,
|
||||
// 因此测试与精简部署不受影响。
|
||||
strmResolve func(ctx context.Context, raw, userAgent string) (*StrmPlayResult, error)
|
||||
}
|
||||
|
||||
// NewStreamService is the constructor.
|
||||
@@ -45,6 +49,16 @@ func NewStreamService(cfg *config.Config, log *zap.Logger, repo *repository.Cont
|
||||
}
|
||||
}
|
||||
|
||||
// SetStrmPlayTargetResolver 注入 strm 播放目标解析器(通常为
|
||||
// StrmService.ResolvePlayTargetWithUA)。注入后播放链路会在服务端完成换链并直接
|
||||
// 302 到最终直链,避免客户端在高延迟线路上多跟随一次 302。
|
||||
func (s *StreamService) SetStrmPlayTargetResolver(resolve func(ctx context.Context, raw, userAgent string) (*StrmPlayResult, error)) *StreamService {
|
||||
if s != nil {
|
||||
s.strmResolve = resolve
|
||||
}
|
||||
return s
|
||||
}
|
||||
|
||||
// ErrMediaNotFound is returned when the media row or its file is missing.
|
||||
var ErrMediaNotFound = errors.New("media not found")
|
||||
|
||||
|
||||
@@ -124,6 +124,16 @@ func (s *StrmService) resolveLocalPlay(ctx context.Context, rawPath string) (*St
|
||||
// - 绝对 http(s) 链接(直接透传,包含别的 MeBox / MediaStationGo 实例的播放端点)
|
||||
// - 其余协议(webdav:// 等)返回错误,由调用方决定是否静默跳过
|
||||
func (s *StrmService) ResolvePlayTarget(ctx context.Context, raw string) (*StrmPlayResult, error) {
|
||||
return s.ResolvePlayTargetWithUA(ctx, raw, "")
|
||||
}
|
||||
|
||||
// ResolvePlayTargetWithUA 与 ResolvePlayTarget 相同,但会把调用方的 User-Agent
|
||||
// 透传给需要按 UA 换取直链的提供方(115 直链绑定换取时的 UA,换错会被 CDN 拒绝)。
|
||||
//
|
||||
// 用途:播放链路在服务端直接把 strm 目标解析成最终直链并 302(见
|
||||
// StreamService.resolveDirectPlayTargetURL),此时必须带上播放器的 UA,才能拿到
|
||||
// 与 /api/strm/play 端点一致的、按 UA 分键缓存的那条直链。
|
||||
func (s *StrmService) ResolvePlayTargetWithUA(ctx context.Context, raw, userAgent string) (*StrmPlayResult, error) {
|
||||
raw = strings.TrimSpace(raw)
|
||||
if raw == "" {
|
||||
return nil, errors.New("空播放目标")
|
||||
@@ -150,14 +160,14 @@ func (s *StrmService) ResolvePlayTarget(ctx context.Context, raw string) (*StrmP
|
||||
if len(segs) < 1 || strings.TrimSpace(segs[0]) == "" {
|
||||
return nil, errors.New("无效的 strm 播放地址")
|
||||
}
|
||||
return s.ResolvePlay(ctx, segs[0], u.Query())
|
||||
return s.ResolvePlay(ctx, segs[0], playbackQueryWithUA(u, userAgent))
|
||||
case strings.HasPrefix(lowerPath, "/api/cloud/play/"):
|
||||
typ := strings.TrimSpace(strings.TrimPrefix(u.Path, "/api/cloud/play/"))
|
||||
acct, err := s.firstEnabledAccountOf(ctx, typ)
|
||||
if err != nil || acct == nil {
|
||||
return nil, errors.New("没有可用的网盘账号,无法解析直链")
|
||||
}
|
||||
q := u.Query()
|
||||
q := playbackQueryWithUA(u, userAgent)
|
||||
q.Set("acct", acct.ID)
|
||||
return s.ResolvePlay(ctx, typ, q)
|
||||
case u.Scheme == "http" || u.Scheme == "https":
|
||||
@@ -167,6 +177,19 @@ func (s *StrmService) ResolvePlayTarget(ctx context.Context, raw string) (*StrmP
|
||||
}
|
||||
}
|
||||
|
||||
// playbackQueryWithUA 复制播放目标的查询串并注入 __ua。ResolvePlay 的云盘提供方
|
||||
// 据此按播放器 UA 换取直链,与 /api/strm/play 端点写入 __ua 的语义保持一致。
|
||||
func playbackQueryWithUA(u *url.URL, userAgent string) url.Values {
|
||||
q := url.Values{}
|
||||
if u != nil {
|
||||
q = url.Values(u.Query())
|
||||
}
|
||||
if ua := strings.TrimSpace(userAgent); ua != "" {
|
||||
q.Set("__ua", ua)
|
||||
}
|
||||
return q
|
||||
}
|
||||
|
||||
// isLocalPlaybackTarget 报告播放地址是否属于本机。这里没有 HTTP 请求上下文,
|
||||
// 「本机」由 strm.base_url / 各同步目录覆盖的 base_url / 本机网盘账号共同界定
|
||||
// (见 isInternalPlaybackTarget)。
|
||||
|
||||
@@ -1,6 +1,9 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"html"
|
||||
"strings"
|
||||
"sync"
|
||||
"time"
|
||||
|
||||
@@ -59,6 +62,9 @@ type TaskTrackerService struct {
|
||||
log *zap.Logger
|
||||
hub *Hub
|
||||
|
||||
// failureNotifier 在任务以失败收尾时通知管理员(Telegram)。nil 时静默。
|
||||
failureNotifier func(ctx context.Context, text string)
|
||||
|
||||
mu sync.Mutex
|
||||
active map[string]*BackgroundTask
|
||||
recent []BackgroundTask
|
||||
@@ -179,8 +185,48 @@ func (t *TaskTrackerService) finish(id string, err error, update TaskUpdate) {
|
||||
if len(t.recent) > t.maxRecent {
|
||||
t.recent = t.recent[:t.maxRecent]
|
||||
}
|
||||
notifier := t.failureNotifier
|
||||
t.mu.Unlock()
|
||||
t.publish(snapshot)
|
||||
|
||||
// 失败通知放在锁外发送:网络请求绝不能阻塞任务状态机。
|
||||
if err != nil && notifier != nil {
|
||||
notifier(context.Background(), formatTaskFailureAlert(snapshot))
|
||||
}
|
||||
}
|
||||
|
||||
// SetFailureNotifier 注入任务失败时的管理员通知回调。
|
||||
func (t *TaskTrackerService) SetFailureNotifier(fn func(ctx context.Context, text string)) {
|
||||
if t == nil {
|
||||
return
|
||||
}
|
||||
t.mu.Lock()
|
||||
t.failureNotifier = fn
|
||||
t.mu.Unlock()
|
||||
}
|
||||
|
||||
// formatTaskFailureAlert 生成面向管理员的失败摘要。错误信息可能很长
|
||||
// (ffmpeg 输出等),这里截断,避免超出 Telegram 单条消息长度。
|
||||
func formatTaskFailureAlert(task BackgroundTask) string {
|
||||
const maxErrRunes = 500
|
||||
text := strings.TrimSpace(task.Error)
|
||||
runes := []rune(text)
|
||||
if len(runes) > maxErrRunes {
|
||||
text = string(runes[:maxErrRunes]) + "…"
|
||||
}
|
||||
var b strings.Builder
|
||||
b.WriteString("⚠️ 任务失败:<b>")
|
||||
b.WriteString(html.EscapeString(task.Name))
|
||||
b.WriteString("</b>")
|
||||
if task.SourcePath != "" {
|
||||
b.WriteString("\n来源:")
|
||||
b.WriteString(html.EscapeString(task.SourcePath))
|
||||
}
|
||||
if text != "" {
|
||||
b.WriteString("\n错误:")
|
||||
b.WriteString(html.EscapeString(text))
|
||||
}
|
||||
return b.String()
|
||||
}
|
||||
|
||||
func (t *TaskTrackerService) currentTime() time.Time {
|
||||
|
||||
@@ -0,0 +1,513 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"bytes"
|
||||
"context"
|
||||
"crypto/rand"
|
||||
"encoding/json"
|
||||
"errors"
|
||||
"fmt"
|
||||
"io"
|
||||
"net/http"
|
||||
"regexp"
|
||||
"strings"
|
||||
"sync"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/helper"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// Telegram 通知相关的设置键。全部存在 settings 表,由管理员在「设备与通知」
|
||||
// 设置分组里维护;带安全默认值:未启用时所有发送静默跳过。
|
||||
const (
|
||||
SettingTelegramEnabled = "telegram.enabled" // 总开关(默认关)
|
||||
SettingTelegramBotToken = "telegram.bot_token" // Bot API Token
|
||||
SettingTelegramAdminChatID = "telegram.admin_chat_id" // 管理员接收运维通知的会话 ID
|
||||
)
|
||||
|
||||
// telegramBindAlphabet 去掉容易看错的 0/O/1/I,降低手抄绑定码时的出错率。
|
||||
const telegramBindAlphabet = "ABCDEFGHJKLMNPQRSTUVWXYZ23456789"
|
||||
|
||||
const (
|
||||
// telegramBindTTL 是绑定码的有效期。到期后必须重新生成。
|
||||
telegramBindTTL = 5 * time.Minute
|
||||
// telegramAPITimeout 覆盖单次 sendMessage 请求。
|
||||
telegramAPITimeout = 10 * time.Second
|
||||
// telegramPollClientTimeout 是长轮询专用 HTTP 客户端的超时,必须 > telegramPollTimeout。
|
||||
telegramPollClientTimeout = 35 * time.Second
|
||||
// telegramPollTimeout 是 getUpdates 的长轮询等待秒数。
|
||||
telegramPollTimeout = 30
|
||||
// telegramPollBackoff 是长轮询失败后的重试间隔,避免打爆 API。
|
||||
telegramPollBackoff = 5 * time.Second
|
||||
// telegramDisabledCheckInterval 是禁用状态下检查配置变化的间隔。
|
||||
telegramDisabledCheckInterval = 10 * time.Second
|
||||
)
|
||||
|
||||
var (
|
||||
// ErrTelegramBindInvalid 表示绑定码不存在(不存在、已被使用,或已被新码取代)。
|
||||
ErrTelegramBindInvalid = errors.New("telegram bind code not found")
|
||||
// ErrTelegramBindExpired 表示绑定码已过期。
|
||||
ErrTelegramBindExpired = errors.New("telegram bind code expired")
|
||||
)
|
||||
|
||||
// telegramBindPending 记录一个待消费的绑定码。
|
||||
type telegramBindPending struct {
|
||||
UserID string
|
||||
ExpiresAt time.Time
|
||||
}
|
||||
|
||||
// TelegramService 负责把通知发到 Telegram,并提供账号绑定。
|
||||
//
|
||||
// 范围被刻意收窄:Bot 只处理 /bind 与 /start 两条命令,不做开注、签到、
|
||||
// 兑换码等命令体系。绑定走「网页生成一次性码 → Bot 端 /bind <code>」,
|
||||
// 这样服务端不需要用户手工填写 chat id。
|
||||
type TelegramService struct {
|
||||
log *zap.Logger
|
||||
repo *repository.Container
|
||||
|
||||
mu sync.Mutex
|
||||
pending map[string]telegramBindPending // code -> pending
|
||||
byUser map[string]string // userID -> code(同一用户只保留最新码)
|
||||
|
||||
// apiBase 允许测试指向本地假服务;生产固定为 Telegram 官方地址。
|
||||
apiBase string
|
||||
// lastUpdateID 是 getUpdates 的增量水位,避免重复处理同一条命令。
|
||||
lastUpdateID int64
|
||||
// client 可注入,便于测试替换传输层(sendMessage 等短请求)。
|
||||
client *http.Client
|
||||
// pollClient 专用于 getUpdates 长轮询,超时须 > telegramPollTimeout。
|
||||
pollClient *http.Client
|
||||
}
|
||||
|
||||
// NewTelegramService 构建 TelegramService。
|
||||
func NewTelegramService(log *zap.Logger, repo *repository.Container) *TelegramService {
|
||||
return &TelegramService{
|
||||
log: log,
|
||||
repo: repo,
|
||||
pending: make(map[string]telegramBindPending),
|
||||
byUser: make(map[string]string),
|
||||
apiBase: "https://api.telegram.org",
|
||||
client: &http.Client{Timeout: telegramAPITimeout},
|
||||
pollClient: &http.Client{Timeout: telegramPollClientTimeout},
|
||||
}
|
||||
}
|
||||
|
||||
// Start 在后台运行 Bot 命令长轮询。goroutine 始终启动;
|
||||
// 未启用或未配置 Token 时 pollLoop 内部休眠等待配置就绪,ctx 结束时停止。
|
||||
func (s *TelegramService) Start(ctx context.Context) {
|
||||
if s == nil || s.repo == nil {
|
||||
return
|
||||
}
|
||||
helper.Go(s.log, "service.telegramBotPoll", func() { s.pollLoop(ctx) })
|
||||
if s.log != nil {
|
||||
s.log.Info("telegram poller started")
|
||||
}
|
||||
}
|
||||
|
||||
type telegramConfig struct {
|
||||
Enabled bool
|
||||
BotToken string
|
||||
AdminID string
|
||||
}
|
||||
|
||||
func (s *TelegramService) config(ctx context.Context) telegramConfig {
|
||||
return telegramConfig{
|
||||
Enabled: s.enabled(ctx),
|
||||
BotToken: s.setting(ctx, SettingTelegramBotToken),
|
||||
AdminID: s.setting(ctx, SettingTelegramAdminChatID),
|
||||
}
|
||||
}
|
||||
|
||||
func (s *TelegramService) setting(ctx context.Context, key string) string {
|
||||
if s == nil || s.repo == nil || s.repo.Setting == nil {
|
||||
return ""
|
||||
}
|
||||
v, err := s.repo.Setting.Get(ctx, key)
|
||||
if err != nil {
|
||||
return ""
|
||||
}
|
||||
return strings.TrimSpace(v)
|
||||
}
|
||||
|
||||
func (s *TelegramService) enabled(ctx context.Context) bool {
|
||||
return parseBoolSetting(s.setting(ctx, SettingTelegramEnabled), false)
|
||||
}
|
||||
|
||||
// SendToUser 把消息发给用户绑定的 Telegram 会话。未绑定、未启用或发送失败
|
||||
// 都只记日志并返回:通知永远不能影响触发它的业务流程。
|
||||
func (s *TelegramService) SendToUser(ctx context.Context, userID, htmlText string) {
|
||||
if s == nil || s.repo == nil || userID == "" || strings.TrimSpace(htmlText) == "" {
|
||||
return
|
||||
}
|
||||
u, err := s.repo.User.FindByID(ctx, userID)
|
||||
if err != nil || u == nil {
|
||||
return
|
||||
}
|
||||
chatID := strings.TrimSpace(u.TelegramChatID)
|
||||
if chatID == "" {
|
||||
return
|
||||
}
|
||||
if err := s.sendMessage(ctx, chatID, htmlText); err != nil {
|
||||
s.warn("telegram send to user failed", userID, err)
|
||||
}
|
||||
}
|
||||
|
||||
// SendToAdmin 把消息发给管理员会话,用于运维类事件(任务失败等)。
|
||||
func (s *TelegramService) SendToAdmin(ctx context.Context, htmlText string) {
|
||||
if s == nil || s.repo == nil || strings.TrimSpace(htmlText) == "" {
|
||||
return
|
||||
}
|
||||
chatID := s.setting(ctx, SettingTelegramAdminChatID)
|
||||
if chatID == "" {
|
||||
return
|
||||
}
|
||||
if err := s.sendMessage(ctx, chatID, htmlText); err != nil {
|
||||
s.warn("telegram send to admin failed", chatID, err)
|
||||
}
|
||||
}
|
||||
|
||||
func (s *TelegramService) warn(msg, target string, err error) {
|
||||
if s.log == nil {
|
||||
return
|
||||
}
|
||||
s.log.Warn(msg, zap.String("target", target), zap.Error(err))
|
||||
}
|
||||
|
||||
// Configured 报告通知是否已具备发送条件:启用 + Token + 管理员会话都齐了。
|
||||
func (s *TelegramService) Configured(ctx context.Context) bool {
|
||||
if s == nil {
|
||||
return false
|
||||
}
|
||||
cfg := s.config(ctx)
|
||||
return cfg.Enabled && cfg.BotToken != "" && cfg.AdminID != ""
|
||||
}
|
||||
|
||||
// SendToAdminChecked 是需要把失败反馈给管理员的场景(例如设置页的测试按钮)。
|
||||
// 它配置未就绪时返回错误;普通事件通知仍应使用静默的 SendToAdmin。
|
||||
func (s *TelegramService) SendToAdminChecked(ctx context.Context, htmlText string) error {
|
||||
if s == nil || s.repo == nil {
|
||||
return errors.New("telegram service unavailable")
|
||||
}
|
||||
chatID := s.setting(ctx, SettingTelegramAdminChatID)
|
||||
if chatID == "" {
|
||||
return errors.New("未配置管理员 Chat ID")
|
||||
}
|
||||
if !s.enabled(ctx) {
|
||||
return errors.New("Telegram 通知未启用")
|
||||
}
|
||||
if s.setting(ctx, SettingTelegramBotToken) == "" {
|
||||
return errors.New("未配置 Bot Token")
|
||||
}
|
||||
return s.sendMessage(ctx, chatID, htmlText)
|
||||
}
|
||||
|
||||
// sendMessage 是唯一的出网点。所有前置条件在这里统一校验。
|
||||
func (s *TelegramService) sendMessage(ctx context.Context, chatID, htmlText string) error {
|
||||
cfg := s.config(ctx)
|
||||
if !cfg.Enabled || cfg.BotToken == "" {
|
||||
return nil
|
||||
}
|
||||
payload := map[string]any{
|
||||
"chat_id": chatID,
|
||||
"text": htmlText,
|
||||
"parse_mode": "HTML",
|
||||
}
|
||||
return s.call(ctx, cfg.BotToken, "sendMessage", payload, nil)
|
||||
}
|
||||
|
||||
// call 发起一次 Bot API 调用(使用短请求客户端)。
|
||||
func (s *TelegramService) call(ctx context.Context, token, method string, payload map[string]any, out any) error {
|
||||
return s.callWithClient(ctx, s.client, token, method, payload, out)
|
||||
}
|
||||
|
||||
// callWithClient 发起一次 Bot API 调用,允许注入自定义 HTTP 客户端(例如长轮询专用)。
|
||||
// 失败时返回 Telegram 的 description,便于排查是 Token 错误、chat 不存在还是被限流。
|
||||
func (s *TelegramService) callWithClient(ctx context.Context, client *http.Client, token, method string, payload map[string]any, out any) error {
|
||||
body, err := json.Marshal(payload)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
url := fmt.Sprintf("%s/bot%s/%s", s.apiBase, token, method)
|
||||
req, err := http.NewRequestWithContext(ctx, http.MethodPost, url, bytes.NewReader(body))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
req.Header.Set("Content-Type", "application/json")
|
||||
|
||||
if client == nil {
|
||||
client = &http.Client{Timeout: telegramAPITimeout}
|
||||
}
|
||||
resp, err := client.Do(req)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
defer func() { _ = resp.Body.Close() }()
|
||||
|
||||
raw, err := io.ReadAll(io.LimitReader(resp.Body, 1<<20))
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
var envelope struct {
|
||||
OK bool `json:"ok"`
|
||||
Description string `json:"description"`
|
||||
Result json.RawMessage `json:"result"`
|
||||
}
|
||||
if err := json.Unmarshal(raw, &envelope); err != nil {
|
||||
return fmt.Errorf("telegram %s: decode response: %w", method, err)
|
||||
}
|
||||
if !envelope.OK {
|
||||
if envelope.Description == "" {
|
||||
envelope.Description = fmt.Sprintf("http %d", resp.StatusCode)
|
||||
}
|
||||
return fmt.Errorf("telegram %s: %s", method, envelope.Description)
|
||||
}
|
||||
if out != nil && len(envelope.Result) > 0 {
|
||||
return json.Unmarshal(envelope.Result, out)
|
||||
}
|
||||
return nil
|
||||
}
|
||||
|
||||
// StartBind 生成一次性绑定码。同一用户重复调用时旧码立即失效。
|
||||
func (s *TelegramService) StartBind(ctx context.Context, userID string) (string, error) {
|
||||
if s == nil || strings.TrimSpace(userID) == "" {
|
||||
return "", errors.New("telegram bind: empty user id")
|
||||
}
|
||||
code, err := randomBindCode()
|
||||
if err != nil {
|
||||
return "", err
|
||||
}
|
||||
s.mu.Lock()
|
||||
defer s.mu.Unlock()
|
||||
if prev, ok := s.byUser[userID]; ok {
|
||||
delete(s.pending, prev)
|
||||
}
|
||||
s.pending[code] = telegramBindPending{UserID: userID, ExpiresAt: time.Now().Add(telegramBindTTL)}
|
||||
s.byUser[userID] = code
|
||||
return code, nil
|
||||
}
|
||||
|
||||
// CompleteBind 消费绑定码并写入用户的 TelegramChatID。
|
||||
// 只在数据库写入成功后才删除 pending 中的绑定码;失败时码保留以便重试。
|
||||
func (s *TelegramService) CompleteBind(ctx context.Context, code, chatID string) error {
|
||||
if s == nil || s.repo == nil {
|
||||
return ErrTelegramBindInvalid
|
||||
}
|
||||
code = strings.ToUpper(strings.TrimSpace(code))
|
||||
chatID = strings.TrimSpace(chatID)
|
||||
if code == "" || chatID == "" {
|
||||
return ErrTelegramBindInvalid
|
||||
}
|
||||
|
||||
// 先读取,不删除——只有在操作成功后才消费绑定码。
|
||||
s.mu.Lock()
|
||||
pending, ok := s.pending[code]
|
||||
s.mu.Unlock()
|
||||
if !ok {
|
||||
return ErrTelegramBindInvalid
|
||||
}
|
||||
|
||||
if time.Now().After(pending.ExpiresAt) {
|
||||
// 过期码:删除并返回,不再保留。
|
||||
s.mu.Lock()
|
||||
delete(s.pending, code)
|
||||
if s.byUser[pending.UserID] == code {
|
||||
delete(s.byUser, pending.UserID)
|
||||
}
|
||||
s.mu.Unlock()
|
||||
return ErrTelegramBindExpired
|
||||
}
|
||||
|
||||
if err := s.repo.User.UpdateFields(ctx, pending.UserID, map[string]any{"telegram_chat_id": chatID}); err != nil {
|
||||
// DB 失败时保留 pending,调用方可重试。
|
||||
return err
|
||||
}
|
||||
|
||||
// 写入成功后再消费绑定码。
|
||||
s.mu.Lock()
|
||||
delete(s.pending, code)
|
||||
if s.byUser[pending.UserID] == code {
|
||||
delete(s.byUser, pending.UserID)
|
||||
}
|
||||
s.mu.Unlock()
|
||||
return nil
|
||||
}
|
||||
|
||||
// Unbind 清空用户的 Telegram 绑定。
|
||||
func (s *TelegramService) Unbind(ctx context.Context, userID string) error {
|
||||
if s == nil || s.repo == nil {
|
||||
return nil
|
||||
}
|
||||
s.mu.Lock()
|
||||
if code, ok := s.byUser[userID]; ok {
|
||||
delete(s.pending, code)
|
||||
delete(s.byUser, userID)
|
||||
}
|
||||
s.mu.Unlock()
|
||||
return s.repo.User.UpdateFields(ctx, userID, map[string]any{"telegram_chat_id": ""})
|
||||
}
|
||||
|
||||
// Status 返回绑定状态与脱敏后的会话 ID,供个人资料页展示。
|
||||
func (s *TelegramService) Status(ctx context.Context, userID string) (bool, string) {
|
||||
if s == nil || s.repo == nil || userID == "" {
|
||||
return false, ""
|
||||
}
|
||||
u, err := s.repo.User.FindByID(ctx, userID)
|
||||
if err != nil || u == nil || strings.TrimSpace(u.TelegramChatID) == "" {
|
||||
return false, ""
|
||||
}
|
||||
return true, MaskSecret(u.TelegramChatID)
|
||||
}
|
||||
|
||||
// MaskSecret 保留首尾各两个字符,中间以 *** 取代。用于 Token 与会话 ID
|
||||
// 这类「界面需要辨识、但不应完整下发」的凭据。
|
||||
func MaskSecret(value string) string {
|
||||
value = strings.TrimSpace(value)
|
||||
if value == "" {
|
||||
return ""
|
||||
}
|
||||
r := []rune(value)
|
||||
if len(r) <= 4 {
|
||||
return "***"
|
||||
}
|
||||
return string(r[:2]) + "***" + string(r[len(r)-2:])
|
||||
}
|
||||
|
||||
func randomBindCode() (string, error) {
|
||||
buf := make([]byte, 6)
|
||||
if _, err := rand.Read(buf); err != nil {
|
||||
return "", err
|
||||
}
|
||||
out := make([]byte, 6)
|
||||
for i, b := range buf {
|
||||
out[i] = telegramBindAlphabet[int(b)%len(telegramBindAlphabet)]
|
||||
}
|
||||
return string(out), nil
|
||||
}
|
||||
|
||||
var telegramBindCommandPattern = regexp.MustCompile(`(?i)^/bind(?:@\w+)?\s+(\S+)\s*$`)
|
||||
|
||||
// pollLoop 长轮询 Bot 更新,只处理绑定相关的两条命令。
|
||||
// 当 Telegram 未启用或 Token 未配置时,休眠后继续循环以便配置变更后自动激活。
|
||||
func (s *TelegramService) pollLoop(ctx context.Context) {
|
||||
for {
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
return
|
||||
default:
|
||||
}
|
||||
|
||||
cfg := s.config(ctx)
|
||||
if !cfg.Enabled || cfg.BotToken == "" {
|
||||
if !sleepCtx(ctx, telegramDisabledCheckInterval) {
|
||||
return
|
||||
}
|
||||
continue
|
||||
}
|
||||
updates, err := s.fetchUpdates(ctx, cfg.BotToken)
|
||||
if err != nil {
|
||||
if s.log != nil && ctx.Err() == nil {
|
||||
s.log.Warn("telegram getUpdates failed", zap.Error(err))
|
||||
}
|
||||
if !sleepCtx(ctx, telegramPollBackoff) {
|
||||
return
|
||||
}
|
||||
continue
|
||||
}
|
||||
for _, u := range updates {
|
||||
if u.UpdateID >= s.lastUpdateID {
|
||||
s.lastUpdateID = u.UpdateID + 1
|
||||
}
|
||||
s.handleUpdate(ctx, cfg.BotToken, u)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
type telegramUpdate struct {
|
||||
UpdateID int64 `json:"update_id"`
|
||||
Message *struct {
|
||||
Text string `json:"text"`
|
||||
Chat struct {
|
||||
ID int64 `json:"id"`
|
||||
} `json:"chat"`
|
||||
} `json:"message"`
|
||||
}
|
||||
|
||||
func (s *TelegramService) fetchUpdates(ctx context.Context, token string) ([]telegramUpdate, error) {
|
||||
s.mu.Lock()
|
||||
offset := s.lastUpdateID
|
||||
s.mu.Unlock()
|
||||
|
||||
payload := map[string]any{
|
||||
"timeout": telegramPollTimeout,
|
||||
// 只取消息更新,避免把频道/回调查询也塞进来。
|
||||
"allowed_updates": []string{"message"},
|
||||
}
|
||||
if offset > 0 {
|
||||
payload["offset"] = offset
|
||||
}
|
||||
var updates []telegramUpdate
|
||||
if err := s.callWithClient(ctx, s.pollClient, token, "getUpdates", payload, &updates); err != nil {
|
||||
return nil, err
|
||||
}
|
||||
return updates, nil
|
||||
}
|
||||
|
||||
func (s *TelegramService) handleUpdate(ctx context.Context, token string, u telegramUpdate) {
|
||||
if u.Message == nil {
|
||||
return
|
||||
}
|
||||
text := strings.TrimSpace(u.Message.Text)
|
||||
chatID := fmt.Sprintf("%d", u.Message.Chat.ID)
|
||||
if chatID == "0" || text == "" {
|
||||
return
|
||||
}
|
||||
|
||||
if match := telegramBindCommandPattern.FindStringSubmatch(text); match != nil {
|
||||
s.replyBind(ctx, token, chatID, match[1])
|
||||
return
|
||||
}
|
||||
if strings.HasPrefix(strings.ToLower(text), "/start") {
|
||||
if err := s.call(ctx, token, "sendMessage", map[string]any{
|
||||
"chat_id": chatID,
|
||||
"text": "MeBox 通知绑定:在网页「个人资料 → Telegram 通知」生成 6 位绑定码,然后发送 <code>/bind 绑定码</code>。",
|
||||
"parse_mode": "HTML",
|
||||
}, nil); err != nil {
|
||||
s.warn("telegram /start reply failed", chatID, err)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
func (s *TelegramService) replyBind(ctx context.Context, token, chatID, code string) {
|
||||
message := ""
|
||||
switch err := s.CompleteBind(ctx, code, chatID); {
|
||||
case err == nil:
|
||||
message = "✅ 绑定成功,之后 MeBox 的账号与设备通知会发到这里。"
|
||||
case errors.Is(err, ErrTelegramBindExpired):
|
||||
message = "⌛️ 绑定码已过期,请在网页重新生成。"
|
||||
case errors.Is(err, ErrTelegramBindInvalid):
|
||||
message = "❌ 绑定码无效,请在网页重新生成后再试。"
|
||||
default:
|
||||
message = "⚠️ 绑定失败,请稍后重试或查看服务日志。"
|
||||
}
|
||||
if err := s.call(ctx, token, "sendMessage", map[string]any{
|
||||
"chat_id": chatID,
|
||||
"text": message,
|
||||
}, nil); err != nil {
|
||||
s.warn("telegram bind reply failed", chatID, err)
|
||||
}
|
||||
}
|
||||
|
||||
// sleepCtx 等待指定时长,ctx 结束则提前返回 false。
|
||||
func sleepCtx(ctx context.Context, d time.Duration) bool {
|
||||
timer := time.NewTimer(d)
|
||||
defer timer.Stop()
|
||||
select {
|
||||
case <-ctx.Done():
|
||||
return false
|
||||
case <-timer.C:
|
||||
return true
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,211 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"errors"
|
||||
"strings"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// 任务失败必须通知管理员:否则只会停留在任务队列里等人自己发现。
|
||||
func TestTaskFailureNotifiesAdmin(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
tracker := NewTaskTrackerService(zap.NewNop(), nil)
|
||||
|
||||
type call struct{ text string }
|
||||
var adminCalls []call
|
||||
tracker.SetFailureNotifier(func(_ context.Context, text string) {
|
||||
adminCalls = append(adminCalls, call{text})
|
||||
})
|
||||
|
||||
h := tracker.Start(TaskKindOrganize, "自动整理", TaskUpdate{})
|
||||
h.Finish(errors.New("disk full"), TaskUpdate{})
|
||||
|
||||
if len(adminCalls) != 1 {
|
||||
t.Fatalf("admin notifications = %d, want 1", len(adminCalls))
|
||||
}
|
||||
if !strings.Contains(adminCalls[0].text, "自动整理") {
|
||||
t.Fatalf("notification = %q, want it to name the task", adminCalls[0].text)
|
||||
}
|
||||
if !strings.Contains(adminCalls[0].text, "disk full") {
|
||||
t.Fatalf("notification = %q, want it to carry the error", adminCalls[0].text)
|
||||
}
|
||||
_ = repos
|
||||
}
|
||||
|
||||
// 动态字段须 HTML 转义,避免路径/错误里的 <>& 破坏 parse_mode。
|
||||
func TestTaskFailureAlertEscapesHTML(t *testing.T) {
|
||||
got := formatTaskFailureAlert(BackgroundTask{
|
||||
Name: "整理 <script>",
|
||||
SourcePath: "C:\\a&b>c",
|
||||
Error: "fail <b>now</b>",
|
||||
})
|
||||
for _, bad := range []string{"<script>", "a&b>c", "<b>now</b>"} {
|
||||
if strings.Contains(got, bad) {
|
||||
t.Fatalf("alert still contains raw %q: %s", bad, got)
|
||||
}
|
||||
}
|
||||
for _, want := range []string{"整理 <script>", "a&b>c", "fail <b>now</b>"} {
|
||||
if !strings.Contains(got, want) {
|
||||
t.Fatalf("alert missing escaped %q: %s", want, got)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// 成功结束的任务不应触发失败通知。
|
||||
func TestTaskSuccessDoesNotNotifyAdmin(t *testing.T) {
|
||||
tracker := NewTaskTrackerService(zap.NewNop(), nil)
|
||||
var count int
|
||||
tracker.SetFailureNotifier(func(context.Context, string) { count++ })
|
||||
|
||||
h := tracker.Start(TaskKindOrganize, "自动整理", TaskUpdate{})
|
||||
h.Finish(nil, TaskUpdate{})
|
||||
|
||||
if count != 0 {
|
||||
t.Fatalf("admin notifications = %d, want 0", count)
|
||||
}
|
||||
}
|
||||
|
||||
// 未接线通知时,任务路径必须照常完成。
|
||||
func TestTaskTrackerWorksWithoutNotifier(t *testing.T) {
|
||||
tracker := NewTaskTrackerService(zap.NewNop(), nil)
|
||||
h := tracker.Start(TaskKindScan, "扫描", TaskUpdate{})
|
||||
h.Finish(errors.New("boom"), TaskUpdate{})
|
||||
}
|
||||
|
||||
func TestExpiryWarningsTargetDueUsersOnly(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
now := time.Date(2026, 9, 22, 12, 0, 0, 0, time.Local)
|
||||
ctx := context.Background()
|
||||
|
||||
// 48h 内到期(落在 "3d" 桶:1-3 天)→ 应该提醒
|
||||
soon := now.Add(48 * time.Hour)
|
||||
// 三十天后到期 → 不应提醒
|
||||
far := now.Add(30 * 24 * time.Hour)
|
||||
for _, u := range []*model.User{
|
||||
{Base: model.Base{ID: "u-soon"}, Username: "soon", PasswordHash: "x", Role: "user", IsActive: true, ExpiredAt: &soon, TelegramChatID: "111"},
|
||||
{Base: model.Base{ID: "u-far"}, Username: "far", PasswordHash: "x", Role: "user", IsActive: true, ExpiredAt: &far, TelegramChatID: "222"},
|
||||
{Base: model.Base{ID: "u-never"}, Username: "never", PasswordHash: "x", Role: "user", IsActive: true, TelegramChatID: "333"},
|
||||
} {
|
||||
if err := repos.User.Create(ctx, u); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
svc := NewTelegramExpiryWatcher(zap.NewNop(), repos)
|
||||
svc.now = func() time.Time { return now }
|
||||
|
||||
var notified []string
|
||||
svc.SetUserNotifier(func(_ context.Context, userID, _ string) { notified = append(notified, userID) })
|
||||
|
||||
if err := svc.RunOnce(ctx); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(notified) != 1 || notified[0] != "u-soon" {
|
||||
t.Fatalf("notified = %v, want [u-soon]", notified)
|
||||
}
|
||||
|
||||
// 同一桶重复运行不得重复打扰。
|
||||
notified = nil
|
||||
if err := svc.RunOnce(ctx); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(notified) != 0 {
|
||||
t.Fatalf("second run notified %v, want none", notified)
|
||||
}
|
||||
}
|
||||
|
||||
// 未绑定 Telegram 的到期用户不应被通知,且不应写入标记键。
|
||||
func TestExpirySkipsUnboundUsers(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
now := time.Date(2026, 9, 22, 12, 0, 0, 0, time.Local)
|
||||
ctx := context.Background()
|
||||
|
||||
soon := now.Add(48 * time.Hour)
|
||||
// 未绑定(TelegramChatID 为空)
|
||||
unbound := &model.User{Base: model.Base{ID: "u-unbound"}, Username: "unbound", PasswordHash: "x", Role: "user", IsActive: true, ExpiredAt: &soon}
|
||||
// 已绑定
|
||||
bound := &model.User{Base: model.Base{ID: "u-bound"}, Username: "bound", PasswordHash: "x", Role: "user", IsActive: true, ExpiredAt: &soon, TelegramChatID: "999"}
|
||||
for _, u := range []*model.User{unbound, bound} {
|
||||
if err := repos.User.Create(ctx, u); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
svc := NewTelegramExpiryWatcher(zap.NewNop(), repos)
|
||||
svc.now = func() time.Time { return now }
|
||||
|
||||
var notified []string
|
||||
svc.SetUserNotifier(func(_ context.Context, userID, _ string) { notified = append(notified, userID) })
|
||||
|
||||
if err := svc.RunOnce(ctx); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
for _, id := range notified {
|
||||
if id == "u-unbound" {
|
||||
t.Fatal("unbound user must not be notified")
|
||||
}
|
||||
}
|
||||
found := false
|
||||
for _, id := range notified {
|
||||
if id == "u-bound" {
|
||||
found = true
|
||||
}
|
||||
}
|
||||
if !found {
|
||||
t.Fatal("bound user must be notified")
|
||||
}
|
||||
|
||||
// 未绑定用户不应写标记键:再次跑时仍然跳过(不重复通知)。
|
||||
notified = nil
|
||||
if err := svc.RunOnce(ctx); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
for _, id := range notified {
|
||||
if id == "u-unbound" {
|
||||
t.Fatal("unbound user notified on second run")
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// 两个提醒桶(3d / 1d)各触发一次,互不干扰。
|
||||
func TestExpiryTwoBuckets(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
ctx := context.Background()
|
||||
|
||||
now := time.Date(2026, 9, 22, 12, 0, 0, 0, time.Local)
|
||||
// 用户的到期时间在 "1d" 桶内
|
||||
oneDay := now.Add(12 * time.Hour)
|
||||
u := &model.User{Base: model.Base{ID: "u1"}, Username: "alice", PasswordHash: "x", Role: "user", IsActive: true, ExpiredAt: &oneDay, TelegramChatID: "555"}
|
||||
if err := repos.User.Create(ctx, u); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
svc := NewTelegramExpiryWatcher(zap.NewNop(), repos)
|
||||
svc.now = func() time.Time { return now }
|
||||
|
||||
var count int
|
||||
svc.SetUserNotifier(func(context.Context, string, string) { count++ })
|
||||
|
||||
// 第一次运行:1d 桶触发
|
||||
if err := svc.RunOnce(ctx); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if count != 1 {
|
||||
t.Fatalf("first run: count = %d, want 1", count)
|
||||
}
|
||||
|
||||
// 第二次运行:1d 桶已标记,不再触发
|
||||
if err := svc.RunOnce(ctx); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if count != 1 {
|
||||
t.Fatalf("second run: count = %d, want still 1", count)
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,117 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"fmt"
|
||||
"html"
|
||||
"strings"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
// expiryNotifiedKeyPrefix 记录「某个用户在某个提醒桶已经提醒过」,防止重复打扰。
|
||||
// 键格式:telegram.expiry_notified.{userID}.{bucket},bucket 为 "3d" 或 "1d"。
|
||||
const expiryNotifiedKeyPrefix = "telegram.expiry_notified."
|
||||
|
||||
// expiryWarnWindow 是「即将到期」的判定总窗口(所有提醒桶中最大的上限)。
|
||||
const expiryWarnWindow = 72 * time.Hour
|
||||
|
||||
// expiryBucket 描述一个提醒时间窗口。
|
||||
type expiryBucket struct {
|
||||
name string
|
||||
from time.Duration // 剩余时间下限(不含)
|
||||
to time.Duration // 剩余时间上限(含)
|
||||
}
|
||||
|
||||
// expiryBuckets 定义两次提醒:约 3 天前 / 约 1 天前,各提醒一次。
|
||||
var expiryBuckets = []expiryBucket{
|
||||
{"3d", 24 * time.Hour, 72 * time.Hour}, // 1–3 天
|
||||
{"1d", 0, 24 * time.Hour}, // 0–1 天
|
||||
}
|
||||
|
||||
// TelegramExpiryWatcher 每日巡检即将到期的账号并提醒用户。
|
||||
//
|
||||
// 只负责「发现 + 通知 + 去重」,发送本身交给注入的 notifier,因此没有配置
|
||||
// Telegram 时整条链路静默跳过。
|
||||
type TelegramExpiryWatcher struct {
|
||||
log *zap.Logger
|
||||
repo *repository.Container
|
||||
now func() time.Time
|
||||
|
||||
userNotifier func(ctx context.Context, userID, text string)
|
||||
}
|
||||
|
||||
// NewTelegramExpiryWatcher 构建巡检器。
|
||||
func NewTelegramExpiryWatcher(log *zap.Logger, repo *repository.Container) *TelegramExpiryWatcher {
|
||||
return &TelegramExpiryWatcher{log: log, repo: repo, now: time.Now}
|
||||
}
|
||||
|
||||
// SetUserNotifier 注入用户通知回调(通常是 TelegramService.SendToUser)。
|
||||
func (w *TelegramExpiryWatcher) SetUserNotifier(fn func(ctx context.Context, userID, text string)) {
|
||||
if w == nil {
|
||||
return
|
||||
}
|
||||
w.userNotifier = fn
|
||||
}
|
||||
|
||||
// RunOnce 执行一次巡检。每个用户每个提醒桶("3d" / "1d")最多触发一次,
|
||||
// 未绑定 Telegram 的用户跳过且不写标记键。
|
||||
func (w *TelegramExpiryWatcher) RunOnce(ctx context.Context) error {
|
||||
if w == nil || w.repo == nil || w.repo.User == nil || w.userNotifier == nil {
|
||||
return nil
|
||||
}
|
||||
now := w.now()
|
||||
|
||||
for _, bucket := range expiryBuckets {
|
||||
from := now.Add(bucket.from) // expired_at > from
|
||||
to := now.Add(bucket.to) // expired_at <= to
|
||||
|
||||
users, err := w.dueUsers(ctx, from, to)
|
||||
if err != nil {
|
||||
return err
|
||||
}
|
||||
for _, u := range users {
|
||||
if u.ExpiredAt == nil {
|
||||
continue
|
||||
}
|
||||
// 跳过未绑定 Telegram 的用户,且不消耗标记键。
|
||||
if strings.TrimSpace(u.TelegramChatID) == "" {
|
||||
continue
|
||||
}
|
||||
markKey := expiryNotifiedKeyPrefix + u.ID + "." + bucket.name
|
||||
if seen, err := w.repo.Setting.Get(ctx, markKey); err == nil && strings.TrimSpace(seen) != "" {
|
||||
continue
|
||||
}
|
||||
w.userNotifier(ctx, u.ID, fmt.Sprintf(
|
||||
"⏳ 账号 <b>%s</b> 将于 %s 到期,请及时续期,避免到期后无法登录。",
|
||||
html.EscapeString(u.Username), u.ExpiredAt.In(time.Local).Format("2006-01-02 15:04"),
|
||||
))
|
||||
// 仅在发送(尝试)后才写标记键。
|
||||
if err := w.repo.Setting.Set(ctx, markKey, "1"); err != nil && w.log != nil {
|
||||
w.log.Warn("telegram expiry mark failed", zap.String("user_id", u.ID), zap.Error(err))
|
||||
}
|
||||
}
|
||||
}
|
||||
return nil
|
||||
}
|
||||
|
||||
// dueUsers 返回 (now, deadline] 内到期且仍处于启用状态的账号。
|
||||
func (w *TelegramExpiryWatcher) dueUsers(ctx context.Context, now, deadline time.Time) ([]*model.User, error) {
|
||||
var users []model.User
|
||||
err := w.repo.DB.WithContext(ctx).
|
||||
Where("expired_at IS NOT NULL AND expired_at > ? AND expired_at <= ?", now, deadline).
|
||||
Where("is_active = ?", true).
|
||||
Find(&users).Error
|
||||
if err != nil {
|
||||
return nil, err
|
||||
}
|
||||
out := make([]*model.User, 0, len(users))
|
||||
for i := range users {
|
||||
out = append(out, &users[i])
|
||||
}
|
||||
return out, nil
|
||||
}
|
||||
@@ -0,0 +1,210 @@
|
||||
package service
|
||||
|
||||
import (
|
||||
"context"
|
||||
"strings"
|
||||
"testing"
|
||||
"time"
|
||||
|
||||
"go.uber.org/zap"
|
||||
|
||||
"github.com/truewhile/MeBox/internal/model"
|
||||
"github.com/truewhile/MeBox/internal/repository"
|
||||
)
|
||||
|
||||
func newTelegramTestService(t *testing.T) (*TelegramService, *repository.Container) {
|
||||
t.Helper()
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
return NewTelegramService(zap.NewNop(), repos), repos
|
||||
}
|
||||
|
||||
func seedTelegramTestUser(t *testing.T, repos *repository.Container, id, chatID string) {
|
||||
t.Helper()
|
||||
if err := repos.User.Create(context.Background(), &model.User{
|
||||
Base: model.Base{ID: id},
|
||||
Username: "tg-" + id,
|
||||
PasswordHash: "x",
|
||||
Role: "user",
|
||||
IsActive: true,
|
||||
TelegramChatID: chatID,
|
||||
}); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
}
|
||||
|
||||
func TestStartBindReturnsSixCharCode(t *testing.T) {
|
||||
s, _ := newTelegramTestService(t)
|
||||
code, err := s.StartBind(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if len(code) != 6 {
|
||||
t.Fatalf("code = %q, want 6 chars", code)
|
||||
}
|
||||
for _, r := range code {
|
||||
if !strings.ContainsRune(telegramBindAlphabet, r) {
|
||||
t.Fatalf("code %q contains unexpected rune %q", code, r)
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
// 同一用户重复申请绑定码时,旧码必须立即失效,避免多个有效码并存。
|
||||
func TestStartBindReplacesPreviousCode(t *testing.T) {
|
||||
s, _ := newTelegramTestService(t)
|
||||
first, err := s.StartBind(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
second, err := s.StartBind(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if first == second {
|
||||
t.Skip("random collision, rerun")
|
||||
}
|
||||
if err := s.CompleteBind(context.Background(), first, "111"); err == nil {
|
||||
t.Fatal("expected the superseded code to be rejected")
|
||||
}
|
||||
}
|
||||
|
||||
func TestCompleteBindRejectsExpiredCode(t *testing.T) {
|
||||
s, _ := newTelegramTestService(t)
|
||||
code, err := s.StartBind(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
s.mu.Lock()
|
||||
s.pending[code] = telegramBindPending{UserID: "u1", ExpiresAt: time.Now().Add(-time.Second)}
|
||||
s.mu.Unlock()
|
||||
|
||||
if err := s.CompleteBind(context.Background(), code, "999"); err == nil {
|
||||
t.Fatal("expected expired code to be rejected")
|
||||
}
|
||||
}
|
||||
|
||||
func TestCompleteBindWritesChatID(t *testing.T) {
|
||||
s, repos := newTelegramTestService(t)
|
||||
seedTelegramTestUser(t, repos, "u1", "")
|
||||
code, err := s.StartBind(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if err := s.CompleteBind(context.Background(), code, "987654321"); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
u, err := repos.User.FindByID(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if u.TelegramChatID != "987654321" {
|
||||
t.Fatalf("chat id = %q, want 987654321", u.TelegramChatID)
|
||||
}
|
||||
// 绑定成功后码必须被消费,不能重复使用。
|
||||
if err := s.CompleteBind(context.Background(), code, "987654321"); err == nil {
|
||||
t.Fatal("expected the consumed code to be rejected")
|
||||
}
|
||||
}
|
||||
|
||||
func TestStatusMasksChatID(t *testing.T) {
|
||||
s, repos := newTelegramTestService(t)
|
||||
seedTelegramTestUser(t, repos, "u1", "1234567890")
|
||||
|
||||
bound, masked := s.Status(context.Background(), "u1")
|
||||
if !bound {
|
||||
t.Fatal("expected bound user")
|
||||
}
|
||||
if strings.Contains(masked, "1234567890") {
|
||||
t.Fatalf("chat id must not be exposed verbatim, got %q", masked)
|
||||
}
|
||||
if !strings.Contains(masked, "***") {
|
||||
t.Fatalf("masked value should carry a *** marker, got %q", masked)
|
||||
}
|
||||
}
|
||||
|
||||
func TestUnbindClearsChatID(t *testing.T) {
|
||||
s, repos := newTelegramTestService(t)
|
||||
seedTelegramTestUser(t, repos, "u1", "555")
|
||||
|
||||
if err := s.Unbind(context.Background(), "u1"); err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
u, err := repos.User.FindByID(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
if u.TelegramChatID != "" {
|
||||
t.Fatalf("chat id = %q, want empty", u.TelegramChatID)
|
||||
}
|
||||
}
|
||||
|
||||
// 未启用 / 未配置 token 时,发送必须静默返回,绝不能发起网络请求或以 panic 收场。
|
||||
func TestSendNoopWhenDisabled(t *testing.T) {
|
||||
s, repos := newTelegramTestService(t)
|
||||
seedTelegramTestUser(t, repos, "u1", "1234567890")
|
||||
|
||||
s.SendToUser(context.Background(), "u1", "hello")
|
||||
s.SendToAdmin(context.Background(), "hello")
|
||||
}
|
||||
|
||||
// 未绑定 Telegram 的用户仍可能触发通知(例如首次登录),此时必须静默跳过。
|
||||
func TestSendNoopWhenUserUnbound(t *testing.T) {
|
||||
s, _ := newTelegramTestService(t)
|
||||
s.SendToUser(context.Background(), "missing-user", "hello")
|
||||
}
|
||||
|
||||
// 数据库写入失败时绑定码必须保留,让用户可以重试。
|
||||
func TestCompleteBindKeepsPendingOnDBFailure(t *testing.T) {
|
||||
db := newServiceTestDB(t)
|
||||
repos := repository.New(db)
|
||||
s := NewTelegramService(zap.NewNop(), repos)
|
||||
|
||||
code, err := s.StartBind(context.Background(), "u1")
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
|
||||
// 关闭底层数据库连接,强制 UpdateFields 失败。
|
||||
sqlDB, err := db.DB()
|
||||
if err != nil {
|
||||
t.Fatal(err)
|
||||
}
|
||||
sqlDB.Close()
|
||||
|
||||
bindErr := s.CompleteBind(context.Background(), code, "999")
|
||||
if bindErr == nil {
|
||||
t.Fatal("expected an error from closed DB")
|
||||
}
|
||||
|
||||
// 码必须还在 pending 里,以便重试。
|
||||
s.mu.Lock()
|
||||
_, stillPresent := s.pending[code]
|
||||
s.mu.Unlock()
|
||||
if !stillPresent {
|
||||
t.Fatal("bind code must be retained when DB write fails, so the user can retry")
|
||||
}
|
||||
}
|
||||
|
||||
// pollLoop 在 Telegram 禁用状态下不应退出,而应持续等待配置开启。
|
||||
func TestPollLoopContinuesWhenDisabled(t *testing.T) {
|
||||
repos := repository.New(newServiceTestDB(t))
|
||||
s := NewTelegramService(zap.NewNop(), repos)
|
||||
|
||||
// 使用一个立即取消的 context 验证 goroutine 能正常退出(不阻塞)。
|
||||
ctx, cancel := context.WithCancel(context.Background())
|
||||
done := make(chan struct{})
|
||||
go func() {
|
||||
defer close(done)
|
||||
s.pollLoop(ctx)
|
||||
}()
|
||||
|
||||
// 给 goroutine 启动时间,然后取消 context。
|
||||
time.Sleep(20 * time.Millisecond)
|
||||
cancel()
|
||||
|
||||
select {
|
||||
case <-done:
|
||||
// ok: goroutine 正常退出
|
||||
case <-time.After(2 * time.Second):
|
||||
t.Fatal("pollLoop did not exit after ctx cancellation")
|
||||
}
|
||||
}
|
||||
@@ -8,6 +8,10 @@ import { getActivePlayProfileId, getActivePlayProfilePinToken } from '../stores/
|
||||
export const api = axios.create({
|
||||
baseURL: '/api',
|
||||
timeout: 30000,
|
||||
// Serialize arrays as repeated params without brackets: genre=a&genre=b
|
||||
// instead of axios's default genre[]=a&genre[]=b which Gin's QueryArray
|
||||
// does not recognise.
|
||||
paramsSerializer: { indexes: null },
|
||||
})
|
||||
|
||||
export const LONG_REQUEST_TIMEOUT = 120_000
|
||||
|
||||
@@ -0,0 +1,49 @@
|
||||
import { api } from './client'
|
||||
|
||||
// 设备管理客户端。
|
||||
//
|
||||
// 普通用户走 /me/devices(服务端按会话身份过滤,前端无法越权指定他人);
|
||||
// 管理员走 /admin/users/:id/devices 代管。
|
||||
|
||||
export interface DeviceInfo {
|
||||
id: string
|
||||
device_id: string
|
||||
device_name?: string
|
||||
client?: string
|
||||
last_ip?: string
|
||||
last_seen_at?: string
|
||||
last_play_at?: string
|
||||
kicked: boolean
|
||||
online: boolean
|
||||
playing: boolean
|
||||
warnings: number
|
||||
}
|
||||
|
||||
interface DeviceListResponse {
|
||||
devices: DeviceInfo[] | null
|
||||
}
|
||||
|
||||
export const devicesAPI = {
|
||||
listMine: () =>
|
||||
api.get<DeviceListResponse>('/me/devices').then((r) => r.data.devices ?? []),
|
||||
|
||||
kickMine: (deviceId: string) =>
|
||||
api.post(`/me/devices/${encodeURIComponent(deviceId)}/kick`).then((r) => r.data),
|
||||
|
||||
kickAllMine: () => api.post('/me/devices/kick-all').then((r) => r.data),
|
||||
|
||||
listForUser: (userId: string) =>
|
||||
api
|
||||
.get<DeviceListResponse>(`/admin/users/${encodeURIComponent(userId)}/devices`)
|
||||
.then((r) => r.data.devices ?? []),
|
||||
|
||||
kickForUser: (userId: string, deviceId: string) =>
|
||||
api
|
||||
.post(
|
||||
`/admin/users/${encodeURIComponent(userId)}/devices/${encodeURIComponent(deviceId)}/kick`,
|
||||
)
|
||||
.then((r) => r.data),
|
||||
|
||||
kickAllForUser: (userId: string) =>
|
||||
api.post(`/admin/users/${encodeURIComponent(userId)}/devices/kick-all`).then((r) => r.data),
|
||||
}
|
||||
@@ -1,6 +1,18 @@
|
||||
import { api, BATCH_REQUEST_TIMEOUT, LONG_REQUEST_TIMEOUT } from './client'
|
||||
import type { Library, LibraryRoot, Media, PlaybackInfo, ScanResult } from '../types'
|
||||
import type { SeriesCard } from '../utils/groupSeries'
|
||||
import {
|
||||
EMPTY_LIBRARY_FILTERS,
|
||||
toFilterQuery,
|
||||
type LibraryFilterParams,
|
||||
} from '../utils/libraryFilters'
|
||||
|
||||
/** 媒体库筛选面板的可选项。 */
|
||||
export interface LibraryFacets {
|
||||
genres: Array<{ name: string; count: number }>
|
||||
year_min: number
|
||||
year_max: number
|
||||
}
|
||||
|
||||
export interface MediaPage {
|
||||
items: Media[]
|
||||
@@ -165,7 +177,12 @@ export const libraryAPI = {
|
||||
id: string,
|
||||
page = 1,
|
||||
pageSize = 50,
|
||||
options?: { groupVersions?: boolean; sort?: string; order?: 'asc' | 'desc' },
|
||||
options?: {
|
||||
groupVersions?: boolean
|
||||
sort?: string
|
||||
order?: 'asc' | 'desc'
|
||||
filters?: LibraryFilterParams
|
||||
},
|
||||
) =>
|
||||
api
|
||||
.get<MediaPage>(`/libraries/${id}/media`, {
|
||||
@@ -175,20 +192,46 @@ export const libraryAPI = {
|
||||
group_versions: options?.groupVersions === false ? 0 : undefined,
|
||||
sort: options?.sort,
|
||||
order: options?.order,
|
||||
...toFilterQuery(options?.filters ?? EMPTY_LIBRARY_FILTERS),
|
||||
},
|
||||
timeout: LONG_REQUEST_TIMEOUT,
|
||||
})
|
||||
.then((r) => r.data),
|
||||
|
||||
/** 媒体库筛选面板的可选项:类型清单与年份区间。 */
|
||||
facets: (id: string) =>
|
||||
api
|
||||
.get<LibraryFacets>(`/libraries/${id}/facets`, { timeout: LONG_REQUEST_TIMEOUT })
|
||||
.then((r) => r.data),
|
||||
|
||||
/** 「随便看看」:按同一套筛选条件随机取一条,无命中时抛 404。 */
|
||||
random: (id: string, filters?: LibraryFilterParams) =>
|
||||
api
|
||||
.get<Media>(`/libraries/${id}/random`, {
|
||||
params: toFilterQuery(filters ?? EMPTY_LIBRARY_FILTERS),
|
||||
timeout: LONG_REQUEST_TIMEOUT,
|
||||
})
|
||||
.then((r) => r.data),
|
||||
|
||||
listSeries: (
|
||||
id: string,
|
||||
page = 1,
|
||||
pageSize = 500,
|
||||
options?: { sort?: string; order?: 'asc' | 'desc' },
|
||||
options?: {
|
||||
sort?: string
|
||||
order?: 'asc' | 'desc'
|
||||
filters?: LibraryFilterParams
|
||||
},
|
||||
) =>
|
||||
api
|
||||
.get<SeriesPage>(`/libraries/${id}/series`, {
|
||||
params: { page, page_size: pageSize, sort: options?.sort, order: options?.order },
|
||||
params: {
|
||||
page,
|
||||
page_size: pageSize,
|
||||
sort: options?.sort,
|
||||
order: options?.order,
|
||||
...toFilterQuery(options?.filters ?? EMPTY_LIBRARY_FILTERS),
|
||||
},
|
||||
timeout: LONG_REQUEST_TIMEOUT,
|
||||
})
|
||||
.then((r) => r.data),
|
||||
|
||||
@@ -1,5 +1,5 @@
|
||||
import { api } from './client'
|
||||
import type { Media, Playlist } from '../types'
|
||||
import type { Media, PlaybackSegmentsResponse, Playlist } from '../types'
|
||||
|
||||
// History rows arrive joined with their Media row; the backend returns null
|
||||
// for orphaned rows whose media has been removed.
|
||||
@@ -47,6 +47,13 @@ export const playbackAPI = {
|
||||
.get<{ position_ms: number; duration_ms: number; completed: boolean }>(`/playback/${mediaId}/resume`)
|
||||
.then((r) => r.data),
|
||||
|
||||
// 片头/片尾片段:播放开始后再调用,服务端可能需要几秒去外部数据库取数,
|
||||
// 因此绝不能让它挡在起播路径上。
|
||||
segments: (mediaId: string) =>
|
||||
api
|
||||
.get<PlaybackSegmentsResponse>(`/playback/${encodeURIComponent(mediaId)}/segments`)
|
||||
.then((r) => r.data),
|
||||
|
||||
recordProgress: (payload: PlaybackProgressRequest) =>
|
||||
api.post('/history', payload).then((r) => r.data),
|
||||
|
||||
|
||||